OPEN SOURCE DEEP DIVE
Octop:把多用户多智能体助手装进一个 Python 进程的自托管平台
腾讯云开源的自托管 AI 助手平台(MIT,8777 star)。一个进程同时跑 FastAPI 后端、React 控制台、CLI、IM 通道与 cron,控制面默认 SQLite WAL、可选 PostgreSQL;把 octop-harness、octop-gateway、octop-memory、octop-browser 四个运行时库组合成可自托管产品。专家库与 AgentTeams、双向 ACP、跨实例 Bridge、工具护栏与 PII 脱敏是差异化部分,ADR 与行号级 spec 把取舍和禁令写成可复核的证据。
一句话定位
Octop 是腾讯云开源的自托管 AI 助手平台,MIT 协议,仓库创建于 2026 年 7 月,当前版本 1.0.2b6(CHANGELOG 记录 2026-10-04 发布)。它的自我描述是 multi-user、multi-agent 的自托管助手,但真正让它和一堆套壳聊天界面区分开的是交付形态:一个 Python wheel 里同时装着 FastAPI 后端、React 控制台、Click CLI、IM 通道接入和 cron 调度,octop run 一条命令全部起来,所有数据落在 ~/.octop/ 下。没有外部队列,没有必须额外部署的服务,除了你自己配置的 LLM provider。
截至采集时,GitHub 上 8777 star、1075 fork,后端以 Python 3.12+ 为主,前端是 React 18 + TypeScript + Vite + Ant Design。它同时提供 Windows、macOS、Linux 桌面客户端和飞牛 NAS 的 fpk 包,说明目标用户里「家里或办公室一台机器」的比重不低。控制台侧栏把聊天、专家、任务、连接器、技能、Token 统计、通道、子智能体、终端 AI+、浏览器 AI+、远程桌面、ACP、MBTI 人格、记忆逐项列出,这份导航本身就是一张功能清单。
它为什么在 harness 板块:harness 之上的宿主层
Octop 自己不是 harness。它把四个独立仓库的运行时库组合进一个进程:octop-harness(基于 LangGraph 的 agent 运行时,管模型路由、工具、技能与会话 checkpoint)、octop-gateway(把飞书、钉钉、QQ、微信、Telegram、Discord、企业微信等 IM 消息归一化进同一条处理管线)、octop-memory(分层召回加全文检索,让记忆跟着工作区走)、octop-browser(基于 CDP 的浏览器自动化,带持久化 profile)。CHANGELOG 里 1.0.2b3(2026-09-26)把四个运行时切到 1.0.0 同版对齐,1.0.2b5(2026-09-29)加入 Octop 与 Octop 之间的 Bridge。这条版本线本身就是一份「宿主与运行时如何协同发版」的记录。
所以它进 harness 板块的理由和推理内核那一类项目不同:Octop 是 harness 之上那一层的完整样本。一个自托管产品要把多个 harness 实例装进一个进程,就得回答会话键怎么编、checkpoint 放哪、记忆库归谁、IM 消息和网页聊天怎么共用同一个运行时、崩溃重启后怎么把整棵运行时树从数据库重建。这些问题的答案都在仓库里,而且写成了 ADR。
单进程,没有队列:ADR 001 的账
ADR 001(2026-06,状态 Accepted)把架构的第一性决定写得很直白:web server、CLI、每用户的 agent 运行时、IM 连接、cron 调度全部跑在同一个 uvicorn 进程里;不用 Redis、RabbitMQ、Celery,没有独立 worker。理由有四条:自托管用户的安装路径是 pip install octop && octop init,加一个 Redis 就把运维负担翻倍;agent 调用是 LLM 绑定的 I/O 等待,asyncio 的扇出足够;并发写很少(同一时刻一个 agent 一个写者),SQLite WAL 扛得住;重启语义简单,OctopServer.start() 从 SQLite 文件重建整棵运行时树,没有外部状态需要对账。
这份 ADR 的价值在于它同时写了代价:只能纵向扩展(一台机器);重 CPU 任务会阻塞事件循环;没有横向 worker 扩展。并且指明未来要拆分时,接缝已经部分可见于 infra/gateway/processor.py。把「我们现在不做什么、将来从哪拆」写进决策记录,比把架构图画得漂亮更有信息量。
三层存储不许混谈:ADR 002
ADR 002(2026-07-20)开头就警告 do not conflate,因为 Octop 里同时存在三层存储,混谈是这类项目最常见的事故源。控制面存用户、agent、通道、cron、设置与密钥;harness checkpoint 存会话图状态;agent 记忆归 octop-memory 所有。工作区内容文件(SOUL、技能、inbound、会话 JSONL)则始终是文件,经 BackendWorkspace 适配,与控制面数据库是两回事。
| 层 | 内容 | 默认 | 可选 |
|---|---|---|---|
| Layer 1 控制面 | users / agents / channels / cron / settings / secrets | ~/.octop/ 下 SQLite(WAL) | PostgreSQL(psycopg3 连接池 1 到 8) |
| Layer 2 harness checkpoint | 会话图状态 | {workspace}/checkpoints.sqlite | memory 为 postgres 时复用 octop-harness 的 PostgresSaver |
| Layer 3 agent 记忆 | octop-memory 的分层召回与全文检索 | SQLite 控制面:{workspace}/memory.sqlite;PG 控制面:同 DSN 下 schema agent_<id> | config_json.memory.backend 显式覆盖 |
| 工作区内容文件 | SOUL、技能、inbound、会话 JSONL | 文件,经 BackendWorkspace | 本地磁盘 / Docker 沙箱 / PostgreSQL / COS、S3 |
实现上有几条硬约束值得抄走:repo 层继续写 ? 占位符,由 PostgresPool 在边界统一改写成 %s;SQLite 与 PostgreSQL 各维护一份编号迁移(NNN_*.sql 与 NNN_*.pg.sql);控制面的 pg 迁移里禁止 CREATE EXTENSION(很多托管 PG 角色没有建扩展的权限,而控制面也不需要 vector,octop-memory 用的是内置 tsvector);单写者,不承诺多实例写;只提供 greenfield,不做 SQLite 到 PostgreSQL 的数据迁移器;备份清单里带 database_driver 与 database_dump_format,跨引擎恢复直接拒绝。这些约束的共同点是:宁可把功能砍掉,也不留一个「看起来能用、出事在半夜」的口子。
专家、人格与 AgentTeams:把团队做成一种特殊专家
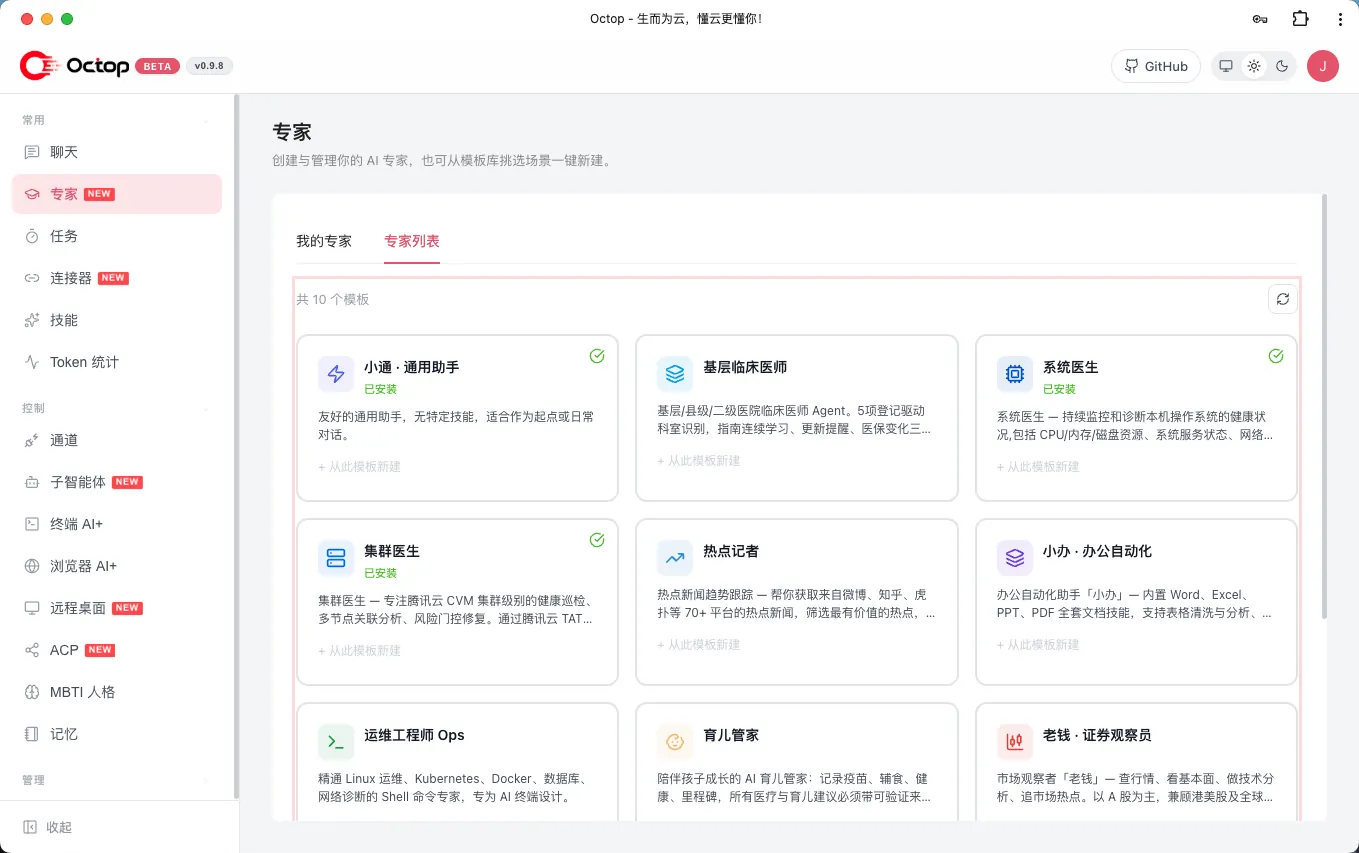
Octop 的基本单位不是 agent 而是「专家」:每个用户可以有多个专家,每个专家有自己的工作区、provider、通道和 cron;内置 16 套 MBTI 人格模板加自定义系统提示;专家库在启动时扫描(infra/agents/experts/library/),另有专家市场与同实例内的专家分享。控制台的专家列表页按模板卡片给出预置角色:通用助手、基层临床医师、系统医生、集群医生、热点记者、办公自动化、运维工程师、育儿管家、证券观察员,每张卡片标注是否已安装,并支持「从此模板新建」。
AgentTeams(Beta)是这套模型的自然延伸,而它的身份模型设计得相当克制:团队不是平行实体,而是 agents.kind = team 的一种特殊专家。房间 ID 就是主持人的 thread_id,成员的 checkpoint 写成「主 thread~成员 id」,群聊转播靠网关加 speaker_agent_id 区分发言人;成员各写各的工作区,团队准则与团体记忆只存在主持人一侧,派工时写进任务消息;通道只绑主持人。设计文档列了 23 条已确认决策,其中几条直接决定实现边界:有在途派工时不能把成员移出团队、也不能删除该专家;成员可以同步 ask_agent 问同事,但不能再异步往群里拉人;停止只停主持人本轮,成员跑完再回叫;用户的新消息一律先到主持人,即使成员还在说话。
| 专家(kind=expert) | 团队主持人(kind=team) | |
|---|---|---|
| 工作区 / checkpoint / 记忆 | 有 | 有(团队记忆根) |
| 系统提示 | 专家模板 | 隐藏调度模板 + 运行时「先消化再改写」约束 |
| 工具 | 干活用的全套 | 轻量 + agent_list + 异步 ask_agent |
| 可见 peer | 默认同用户其它专家 | 仅 team_peers,即团队成员 |
| 通道 | 可绑(1:1) | 可绑(团队入口) |
最关键的一条是主持人权能收窄:主持人的工具只有 agent_list、异步 ask_agent 和记忆/时间,不挂文件系统、浏览器、搜索、MCP、技能、插件,创建与编辑时也没有 skill、subagent、插件、人格选项。主持人只调度不干活,这条约束把「协调者自己下场写文件」这类多智能体系统最常见的混乱挡在了工具表外面。
四个表面共用一个运行时
Web、CLI、IM、cron 四个表面共用同一套 harness 运行时,区别只在会话键的编法:Web 是 <aid>:dashboard:<user_id>:dm,CLI 是 <aid>:cli:<user_id>:dm,IM 是 <aid>:<channel_kind>:<platform_session>:<dm|group>,cron 则用任务行上的 session_key(默认取属主的 dashboard 键)。thread_id 本身不编码来源,来源是 chat_sessions 与 threads 表上的列;线程的复用与归档是一次行更新,状态机在 infra/gateway/threads.py。这种「键是约定、来源是数据」的拆法,让同一个会话在不同表面之间能被正确归属,而不是靠解析字符串猜。
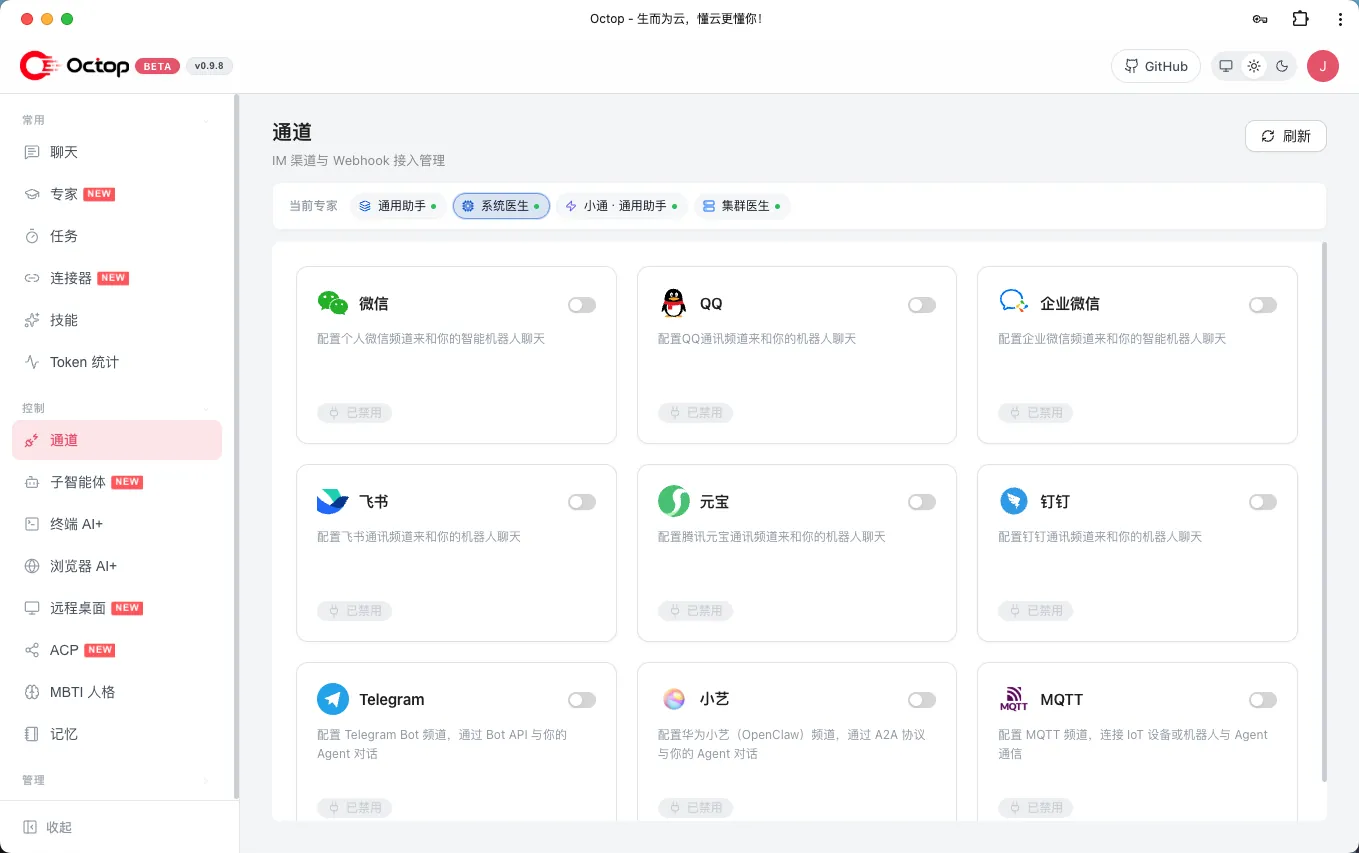
流式聊天已经从 SSE 迁到 WebSocket(/api/agents/{aid}/chat/ws),理由是双向:控制台需要在回合进行中发斜杠命令和 /compact。目前只剩 POST /api/agents/{aid}/chat/hitl/resume 一条路由还用 SSE,因为它只需要把恢复后的回合单向流回客户端。通道页能看出 IM 接入的颗粒度:微信、QQ、企业微信、飞书、元宝、钉钉、Telegram、小艺(OpenClaw,走 A2A 协议)、MQTT 逐项开关,且按「当前专家」切换,一个专家绑一套通道。
ACP 双向与跨实例 Bridge
ACP(Agent Client Protocol)在 Octop 里是双向的。入向:octop acp --agent main 起一个 stdio ACP server,让 Zed、OpenCode 这类编辑器直接使用你的 Octop 专家;出向:Octop 把任务委派给外部编码 agent,内置 runner 包括 OpenCode、CodeBuddy、Claude Code、Codex,配置里还列了 kimi_code、cursor_cli、pi,在控制台 /acp 里按用户配置 runner,再对单个 agent 打开 acp_runner 工具即可在聊天中委派,委派带权限门。
Bridge(Octop 与 Octop 实例桥)解决的是另一件事:用户级地连上另一台 Octop(云端或另一台本地机器),在本机控制台查看对端专家列表、按需拉取对话记录、像选本地专家一样与对端专家对话,且对称可用。设计文档把边界划得很死:对话只在专家所在实例执行,发起侧不落库完整历史;远程 agent 的 id 形如 bridge:{connection_id}:{remote_agent_id};浏览器只打本机 API,由本机识别远程后经桥转发;传输是联邦长连接 WebSocket,其上以通用 HTTP 隧道为主,turn 流式多路复用;明确列出的非目标包括改造 ask_agent 的跨端协议、双边双写全量聊天记录、浏览器直连对端 baseURL。文档标注状态为实现中、Phase 0 到 3 骨架已落地,读的时候应当按半成品对待。
工程纪律:把「不许做什么」写进仓库
仓库根的 AGENTS.md 是给编码 agent 看的导航手册,但它的模块边界表对人类同样有效:依赖只能向内流,传输层调领域层,领域层绝不反向调 HTTP 或 CLI;infra/db/repos/ 一个表一个 repo、只写 SQL;infra/utils/ 是纯函数,不得依赖任何其它 infra 包;api/routers/ 必须薄,只校验 HTTP、调 infra、映射错误,不写新领域规则。Hard bans 列了六条,包括 infra/ 不得 import api/、cli/、launch.py,以及全仓库只有 launch.py 允许同时 import infra/server 与 api/app。发货门槛是 make all(format + lint + typecheck + test)全绿;测试要求 uv run pytest,禁止裸 pytest;CI 同时在 Linux 与 Windows 上跑,测试不许假设单一平台。
规模上它已经不是一个玩具:在我们采集的这份 clone 里,infra/ 488 个 Python 文件、106,895 行,api/ 105 个文件、29,877 行,cli/ 46 个文件、5,579 行,dashboard/src 934 个 ts 与 tsx 文件、181,772 行,tests/ 501 个文件、90,411 行。测试代码量接近 infra 的九成,这个比例在同类自托管项目里不常见。
| 目录 | 文件数 | 行数 |
|---|---|---|
src/octop/infra | 488 个 .py | 106,895 |
src/octop/api | 105 个 .py | 29,877 |
src/octop/cli | 46 个 .py | 5,579 |
dashboard/src | 934 个 .ts / .tsx | 181,772 |
tests | 501 个文件 | 90,411 |
更能说明纪律的是一份 spec 文档:docs/octop-ui-payload-offload.md 处理的问题是内置 bilibili 插件一次工具调用返回 13 到 24 KB 的 JSON(PoC 复现 200 集番剧 22.5 KB),而同一个字符串要服务四类需求互相矛盾的消费者:模型上下文要小,历史持久化要全,控制台实时帧要全,插件 UI 也要全。截断不可行,因为 UI 会丢剧集。文档的解法是在工具执行之后、ToolMessage 进入 LangGraph state 之前,把数据面(大 payload,作为 artifact)与控制面(摘要加渲染提示)分离:artifact 不进模型上下文,但随 WS 实时帧、历史持久化与插件 UI 传递。这份 spec 标注 v2、三方模型独立评审一致 APPROVE WITH CHANGES,并且列了 20 条已验证事实,每条都带源码文件与行号,另附真实 LangGraph agent loop 的 PoC 脚本。把「模型评审 + 行号级取证 + 运行时复现」当成 spec 的准入条件,是这份仓库里最值得同行抄走的部分。
| 消费者 | 需求 | 路径 |
|---|---|---|
| LLM 上下文 | 越小越好;ToolMessage.content 进 state 后每次模型调用全量携带 | LangGraph state |
| 历史持久化 | 需要完整数据供回放 | thread_messages(recorder 主路径 message_to_dict) |
| 控制台实时渲染 | 需要完整 data | WS tool_result 帧(model_dump) |
| 插件 UI | 需要完整 data | props.data,解析 tool output |
运维侧的克制:memory slim 与 history_v2
octop memory slim 是在线整理记忆库的命令:连接正在运行的同一个 OCTOP_HOME 实例,不启第二份 Octop;先等当前任务结束(120 秒内找不到空闲窗口就失败退出,不迁移),再备份、去重历史上下文、压缩、恢复;每个库单独备份为 memory.sqlite.before-slim.<随机 ID>.bak,不自动删除也不覆盖;批次中任何一个失败立即停止,报告已完成与未执行数,不自动重试。文档里有一句少见但重要的承诺:备份与 VACUUM 阶段不提供虚假的百分比或剩余时间,耗时增加只表示服务连接仍有响应,不代表完成比例。维护期间记忆面板的 RPC 返回 AGENT_BUSY,而不是让同步 SQLite 的锁等待去阻塞状态轮询;其它独立数据库的智能体不受影响,仍可正常使用。
分段历史归档(history_v2)同样克制:默认关闭,不跑历史数据迁移,不清理 checkpoint,切换以完整回合为边界;新文件 history_v2.sqlite 里 documents 存消息或轨迹结构、bodies 存按内容哈希共享的正文、可见 thinking 与工具参数结果,完全相同的大字段可被两种视图引用,而不是把两份完整聊天存进两个新库。该功能只支持 SQLite 主库与单个服务进程,PostgreSQL 开启会被明确拒绝启动;文档也不承诺「全项目历史只剩一份」,已有 SQLite 文件不会因此立即变小。一个默认关闭、拒绝在不支持的后端上启动的特性,比一个默认打开的迁移脚本更让人放心。
部署形态与安全默认值
安装走一行脚本(uv 在 ~/.octop/ 下隔离安装 Python 3.12),或 pip install octop;octop init 交互式建库、生成 JWT secret 与首个管理员;octop run 前台起服务,默认端口 8088,可 --host 0.0.0.0 --port 8088 自定义;octop service start 注册成 systemd、launchd 或 Windows 服务。Docker 首启若未设 OCTOP_DEFAULT_PASSWORD 会生成随机管理员密码写进 /data/.octop/credential.txt;密码策略是至少 8 位且含字母与数字,弱密码会被应用层密码策略拒绝并回落随机密码。安全侧的默认值包括:JWT 多用户、行级隔离(按 agents.user_id 与调用者比对,管理员可越权查看);PII 在离开工作区前脱敏;高风险工具与 shell 命令需显式审批,规则放在用户可编辑的 ~/.octop/security/tool_guard/;工作区文件与控制面数据库分离,工作区后端可选本地磁盘、Docker 沙箱、PostgreSQL、COS 或 S3。
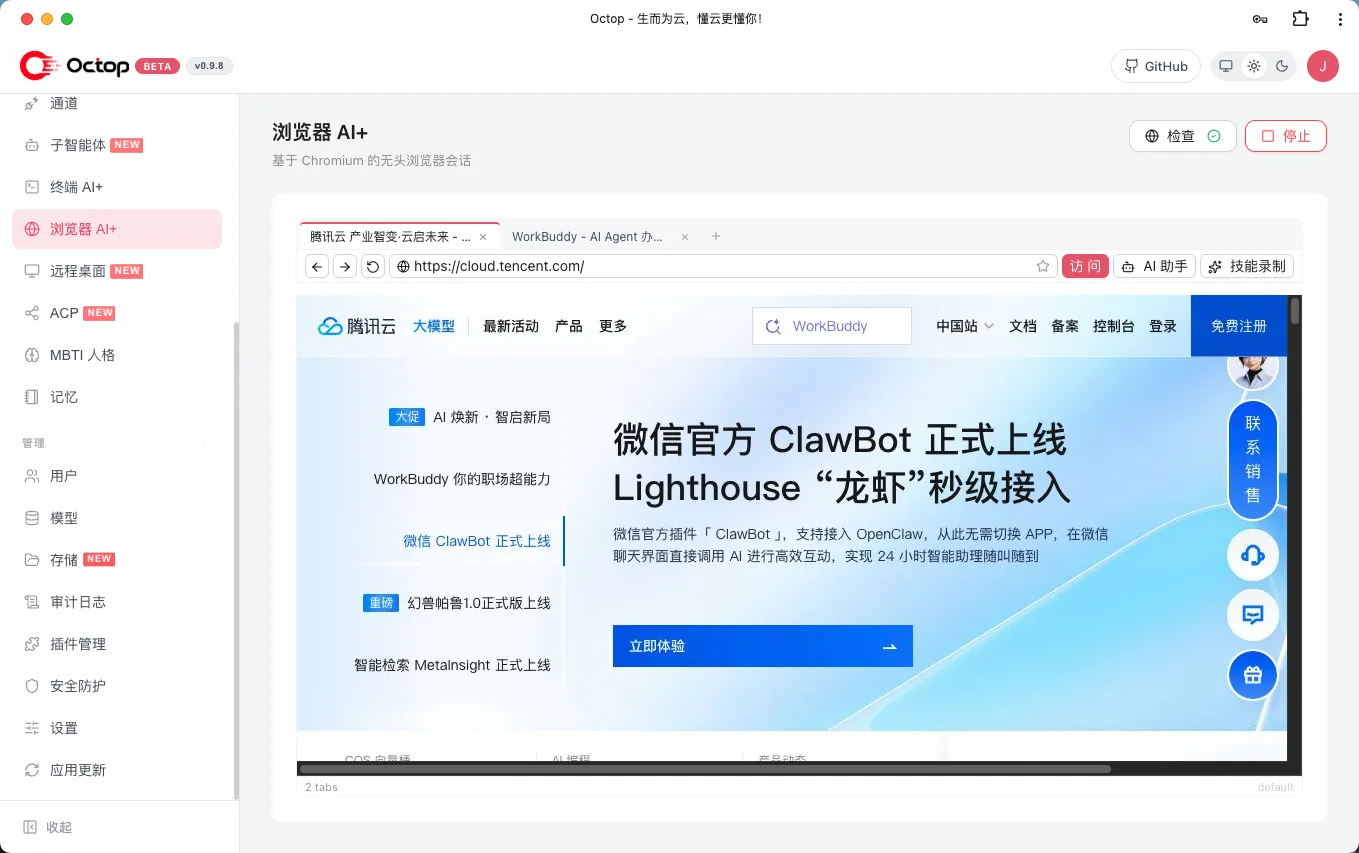
控制台里「浏览器 AI+」页直接内嵌了一个基于 Chromium 的无头会话,截图里能看到标签页、地址栏与「技能录制」按钮;「远程桌面」页则在 Linux、Windows、macOS 上捕获并注入宿主桌面会话,无头 Linux 上一键起隔离桌面。这两项把 agent 的手从文本伸到了 GUI,也是它和纯聊天型助手最直观的差别。
边界与需要自己判断的地方
几点必须写清楚。第一,AgentTeams 标注 Beta,Bridge 标注实现中,history_v2 默认关闭且只支持 SQLite:这三块是方向而非成品,评估时不要按 README 的高光表来验收。第二,单进程模型的天花板是官方自己写进 ADR 的:一台机器、纵向扩展、重 CPU 阻塞事件循环;多实例写不被承诺,这意味着它不适合被当成水平扩展的服务端底座。第三,专家市场、技能分享与连接器生态会把第三方内容带进同一个运行时,工具审批与 shell 护栏是缓解而非消除。第四,我们没有对它做过基准或长时运行测试,8777 star 说明关注度,不说明能力水位。把它列进 harness 板块,是因为它把「宿主层如何编排多个 harness 实例」这件事做成了可复核的文档与代码:ADR 写取舍,AGENTS.md 写禁令,spec 写行号级取证。对正在自建 agent 平台的人,这套文档本身就是可复用的资产。