
OPEN SOURCE DEEP DIVE
Pika H3 Flex:最多 12 路引用驱动的六步同步音视频生成
Pika Labs 在 MiniMax-H3 上开源的双适配器音视频生成工具,支持首尾帧和多模态引用,六步联合生成视频与立体声,并明确算力与许可证边界。
一句话定位
Pika H3 Flex 是 Pika Labs 在 MiniMax-H3 上后训练并开源的一组音视频生成适配器。它没有把“生成画面”和“生成声音”拆成两个互不相干的阶段,而是在同一个扩散采样过程中联合生成视频与立体声音频;一次请求使用六次模型前向,再从共享的时间轴解码为 H.264 视频和 AAC 音频。
这个项目值得关注的地方不只是“文生视频”。它把专业创作中反复出现的两类控制都收进了同一套推理入口:第一类是首帧、尾帧或首尾帧,用来规定镜头从哪里开始、在哪里结束;第二类是有序的多模态引用,可以把人物、动作、镜头轨迹、环境、声音或完整源视频作为素材交给模型。前者由 FL2VA 承担,后者由 Ref2VA 承担。
开源权重与托管服务不是同一能力边界
阅读项目时最容易产生的误解,是把 Pika 托管 API 的规格直接当成开源包的规格。仓库明确区分了两层能力。下载到本地运行的权重原生支持 480p 和 768p,时长请求为 5 至 15 秒;Pika API 另外提供草稿升到 1080p、2K、4K 的服务,也提供音轨分离和提示词增强。这些托管功能没有随开放权重一起发布。
因此,本文讨论的对象是本地可运行的 FL2VA 与 Ref2VA 推理包,不是 Pika 商业 API 的完整产品面。开放权重也不意味着没有许可证限制。推理代码使用 Apache-2.0,两个适配器属于 MiniMax-H3 的模型衍生作品,必须遵守 MiniMax H3 Community License。适用地域排除欧盟、英国、韩国和美国,商业收入、界面标识、下游用户约束和禁止用于改进其他模型等条款也需要逐条核对。
两个适配器,两种控制方式
FL2VA 适合“给定镜头端点,让模型补出中间过程”的任务。只给文本时,它生成画面、对白、环境声与配乐;给首帧时,首帧定义开场状态;给尾帧时,模型反向组织动作;同时给首尾帧时,提示词要描述如何从第一张图连续过渡到最后一张图。官方提示词指南建议首尾帧之间优先保持单镜头,确有叙事需要时再明确切镜。
Ref2VA 适合引用生成、视频编辑和续写式创作。它最多接收 9 张图片、3 段视频和 3 段独立音频,文件总数不超过 12 个,并且至少要有图片或视频。输入顺序会被保留,提示词里用 <Picture N>、<Video N>、<Audio N> 和 <Subject N> 分别指向画面锚点、源视频、音频与要保留或转移的主体。视频自带的声音跟随视频引用,不会额外占用一个独立音频名额。
引用并不等于像素级复制。提示词把意图分成完全保留、局部保留、属性迁移和弱参考;音频还可以区分完整复制、片段复制、音色参考和氛围参考。视频续写同样只是提示词层的任务意图,当前命令行并没有单独的“无缝延长”模式。把这些标记理解成可控条件,而不是确定性的合成指令,才符合发布包的实现。
| 任务 | 入口 | 条件输入 | 典型用途 |
|---|---|---|---|
| 文本到音视频 | t2va / FL2VA |
一段 1 至 8,000 字符的提示词 | 多镜头叙事、运动图形、产品片、对白与环境声 |
| 首帧或尾帧条件 | i2va, l2va / FL2VA |
提示词加一张端点图 | 从既有构图开始,或让动作收束到指定画面 |
| 首尾帧条件 | fl2va / FL2VA |
提示词加首帧与尾帧 | 两个确定画面之间的连续动作与镜头设计 |
| 多模态引用 | ref2va / Ref2VA |
提示词加最多 9 图、3 视频、3 音频 | 角色与产品保持、动作迁移、视频编辑、声音参考 |
从引用到成片,实际经过哪几步
推理入口先解析任务、画幅、时长和引用规格,再从固定版本的模型仓库加载基座与适配器。适配器的格式版本、LoRA 秩与缩放系数、采样节点、视频和音频偏移、基座仓库及提交号都会被校验。任何一个契约字段不匹配,程序会在加载大模型之前直接停止,避免用错权重生成出一段看似成功、实际上不可复现的成片。
flowchart LR
  A["提示词与可选端点帧"] --> B["文本与视觉条件编码"]
  C["有序图片 / 视频 / 音频引用"] --> D["引用预检与媒体编码"]
  B --> E["FL2VA 或 Ref2VA 适配器"]
  D --> E
  E --> F["六次联合去噪前向"]
  F --> G["视频潜变量解码"]
  F --> H["音频潜变量解码"]
  G --> I["H.264 视频"]
  H --> J["32 kHz 立体声 AAC"]
  I --> K["MP4 + 生成元数据 JSON"]
  J --> K
具体实现中,文本与引用先经过 H3 的条件编码器,随后释放编码器以降低后续采样压力;Transformer 载入 CPU,注入适配器后整体移到 GPU,或者启用块级 CPU offload;采样结束后,视频 VAE 与音频 VAE 分别解码;最后写出 MP4,并用 PyAV 重新打开结果,检查画布、帧数、帧率、音频采样率和双声道是否符合请求。这个回读校验很重要,因为它验证的是编码后的实际文件,而不只是内存里的张量形状。
原生输出规格与帧网格
本地支持 480p、768p 两档,覆盖 21:9、16:9、3:2、4:3、5:4、1:1、4:5、3:4、2:3、9:16 和 9:21 共 11 种画幅。实际像素尺寸取发布包内的分辨率桶,并不是把短边写死后任意计算。输出固定为 24 fps、32 kHz 立体声,封装为 H.264/AAC MP4,并同时写一份 JSON,记录提示词、随机种子、适配器哈希、几何参数、引用顺序、采样峰值显存和分阶段耗时。
时长请求是整数 5 至 15 秒,但生成器使用 17n+5 的帧网格,所以实际长度会轻微上取整。5 秒请求得到 124 帧,约 5.17 秒;15 秒请求得到 362 帧,约 15.08 秒。阅读规格时不应把“请求 5 秒”误写成“严格输出 300 帧”。同样,画幅比例也不是自由裁切,最终尺寸由对应分辨率桶决定。
| 项目 | 开放本地推理规格 | 需要特别留意的边界 |
|---|---|---|
| 分辨率 | 480p / 768p,11 种画幅 | 1080p、2K、4K 只属于 Pika 托管 API |
| 时长 | 请求 5 至 15 秒 | 按 17n+5 帧网格上取整 |
| 画面与声音 | 24 fps,32 kHz 立体声 | MP4 内为 H.264 + AAC,不是分离交付 |
| 提示词 | 1 至 8,000 字符 | 文件按原文读取,本地推理不自动增强 |
| 引用 | 最多 9 图 + 3 视频 + 3 音频 | 总数不超过 12,且至少有图片或视频 |
六步并不等于通用六步欧拉
项目把“六步”作为核心卖点,但复现时必须使用适配器规定的采样契约。当前发布包固定六个去噪前向,节点为 1000、750、500、250、100、40、0,视频偏移为 12,音频偏移为 3,并在中间步骤重新注入噪声。代码把方法标为 renoise。拿常见的六步欧拉采样器替换它,即使步数相同,也不是同一个生成过程。
可复现性也有边界。固定种子能固定噪声序列,但官方明确说明不同注意力内核、设备、进程、offload 方式与库版本仍可能产生差异。因此,同一台机器、同一套锁定依赖和同一权重版本更接近逐次复现;跨硬件则只能期待语义接近,不能承诺逐像素一致。仓库里的创作样例本身也不是发布验证基准:种子、确切检查点与服务端预处理没有完整公开,所以它们展示的是创作能力,不能拿来计算吞吐或作为可精确重放的验收集。
样例展示的是创作方向,不是 benchmark
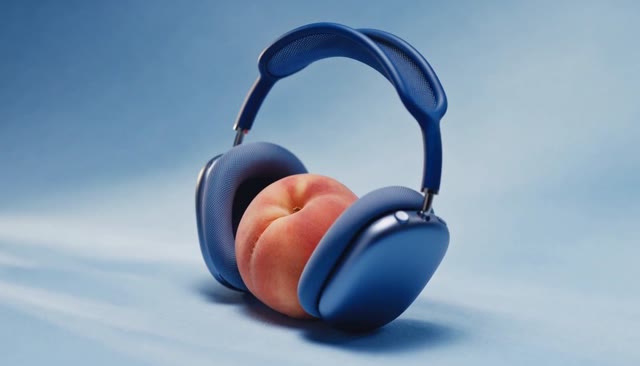
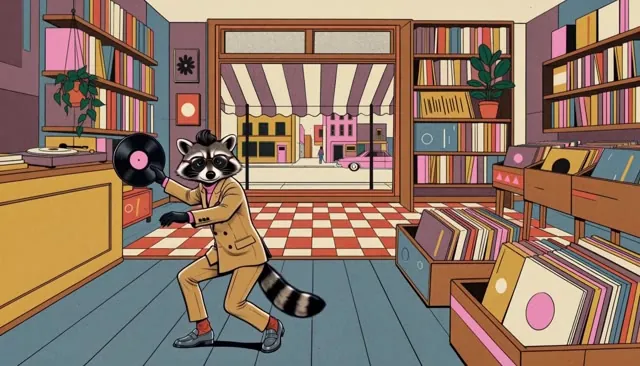
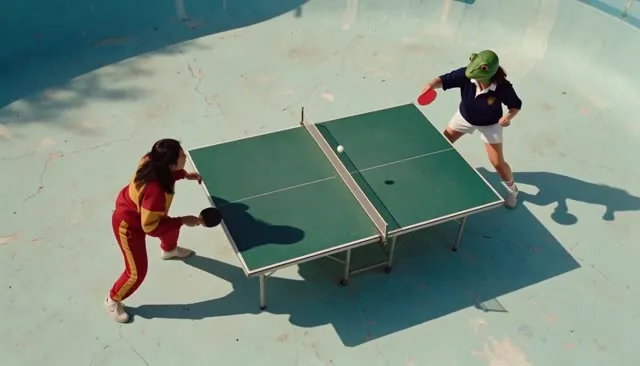
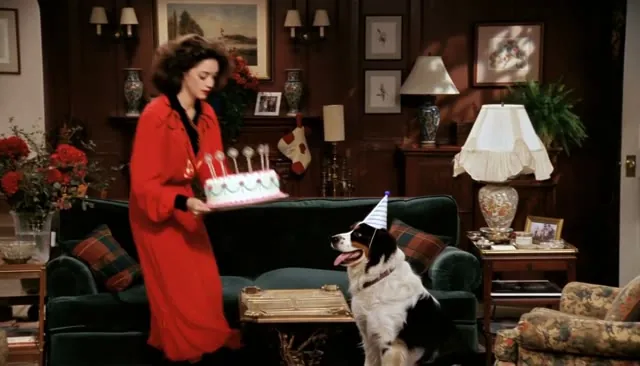
下面四张图来自仓库随附的创作样例。产品片样例把耳机、桃子、纯色棚拍背景和节拍剪辑压进连续镜头;动作迁移样例把角色设定图、环境图与真人动作视频拆成三种引用;青蛙乒乓球样例用长提示词描述俯拍、摇臂、甩镜和环绕;情景喜剧样例则测试多镜头、对白、观众笑声和道具动作的同步。它们覆盖了该模型最有代表性的创作表面。
硬件门槛比“六步”更值得先看
六次前向降低了采样步数,但没有把模型变成轻量工具。下载两个任务所需的基础组件约 210 GB,两个适配器约 5.5 GB,还要为 Python 依赖、下载暂存和输出留空间。每个请求只使用一张 GPU,多卡不会拆分同一次推理;多张空闲卡可以并行跑不同请求。
官方在 H100 80GB 上验证过一组代表配置。默认模式下,480p、5 秒采样的代表性显存分配约为 66 至 69 GiB;768p、5 秒和多数端点帧任务可通过。768p、15 秒在默认模式下超出 H100 显存,启用 Transformer 块级 CPU offload 后,采样显存约 29 至 32 GiB,但主机内存连同页缓存接近 94 GiB。这里的数字只覆盖采样阶段,文本编码器和两个 VAE 还有各自的内存需求,不能当成最低系统要求。
| 已验证或未验证项 | 发布包给出的证据 | 结论 |
|---|---|---|
| 480p / 5 秒文本生成 | H100 80GB,默认模式,采样约 66 至 69 GiB | 适合作为首轮资格验证 |
| 768p / 15 秒 | H100 80GB + CPU offload,采样约 29 至 32 GiB | 可跑,但需要接近 94 GiB 主机内存余量 |
| 图像、视频、音频混合引用 | 480p / 5 秒通过 | 不代表最大 12 路引用组合已通过显存验证 |
| H200 / B300 | 没有针对该发布包完成资格验证 | 不能把基础架构相似当作已验证 |
视频与独立音频引用还各自受长度约束:每一段必须是 2 至 15 秒,视频总时长和独立音频总时长分别不能超过 15 秒。即使文件数量合法,所有引用同时拉满也可能超过显存。发布包接受某种输入组合,只说明参数校验允许,不说明任何硬件都能完成该组合。
最小运行路径
项目要求 Python 3.12、受支持的 NVIDIA 驱动和编译工具链。安装后先应用仓库固定的 Diffusers 补丁,再以无依赖方式安装本地包;直接安装依赖而不是应用补丁,可能得到与发布验证不同的注意力实现。首次运行会自动下载固定版本的 MiniMax-H3 基座和所选适配器,也可以通过本地快照覆盖,但本地覆盖被当成受信任输入,命令行不会重新校验全部基座分片。
python -m pip install -r requirements.txt
python tools/apply_diffusers_patches.py
python -m pip install --no-deps -e .

export MODEL_REPO=Pika-Labs/Pika-H3-Flex
export MODEL_REVISION=0ddf55ad7067ca1e76812253bd7b4600df87f759

pika-h3-pro \
  --task t2va \
  --prompt-file examples/prompts/t2va.txt \
  --model-repo "$MODEL_REPO" \
  --revision "$MODEL_REVISION" \
  --resolution 480p \
  --aspect 16:9 \
  --duration 5 \
  --seed 42 \
  --output outputs/sample.mp4
第一次跑通不要直接选最长、最高分辨率和最多引用。先用 480p、5 秒、单卡验证环境、下载、解码和编码链,再逐步增加画幅、时长和引用数量。出现显存不足时可以尝试 --cpu-offload,但要同时监控主机内存和块传输耗时;它不是把全部模型搬到 CPU,文本编码器与 VAE 仍在 GPU 上执行。
适合什么,不适合什么
它适合需要快速迭代镜头方案的专业创作流程:广告产品片、角色一致的动画、多镜头短叙事、动作与镜头迁移、带对白和环境声的社交视频,以及把已有素材重新组合成新片段。Ref2VA 的引用语义尤其适合在“主体、动作、环境、声音”之间明确分工,让创作者知道每个素材到底控制了什么。
它不适合把它当成已经验证过的通用世界模型、机器人控制模型或高精度视频编辑器。当前包没有专门的逐帧遮罩、关键点绑定、物理约束或确定性身份锁定;引用保持仍然是生成条件。最大引用数也不等于所有组合都经过硬件验证。涉及真实人物声音、版权素材和商业分发时,还要同时处理肖像、声音、训练数据、生成内容标识与许可证合规。
最准确的评价是:Pika H3 Flex 用一组明确的适配器,把首尾帧控制、多模态引用、联合音频和低步数采样放进了一个可审计的开源推理包。它把“能生成”推进到了“知道哪些素材在控制画面、动作和声音”,但算力门槛、地域许可和多模态引用组合的验证覆盖,仍然是部署前必须正视的边界。