OPEN SOURCE DEEP DIVE
PersonaPlex:用角色文本与声音样本控制全双工语音对话
NVIDIA PersonaPlex-7B 以 Mimi 和 Moshi 为底座,把固定声音条件与文本角色提示注入同一条流式生成状态,实现可打断、边说边听的实时语音对话。代码采用 MIT 许可证,模型权重则单独受 NVIDIA Open Model License 约束。
PersonaPlex 解决的不是“换一个音色”
PersonaPlex-7B 是一个实时、全双工语音到语音对话模型。它要同时做三件事:在用户说话时持续接收音频,不等整段录音结束就开始生成回应;用一段参考声音固定说话人的音色;再用文字约束助手此刻是谁、掌握哪些信息、该采用什么对话策略。仓库把这套能力称为 voice and role control,代码则把两种条件真正拼成了一段混合系统提示,而不是只在应用层给生成结果套一个“人设”。
项目建立在 Moshi 的流式语音架构和 Helium 语言骨干之上。它与常见的“语音识别 → 大模型 → 语音合成”三段式管线不同:用户音频先被 Mimi 编码成低帧率离散表示,语言模型在同一个自回归循环里预测助手文本和助手音频的下一帧,Mimi 解码器再把音频 token 还原成波形。这样,听、想、说共享同一条时间轴,用户可以在助手生成期间继续发声,服务端也没有必要等到一句话结束才启动下一轮。
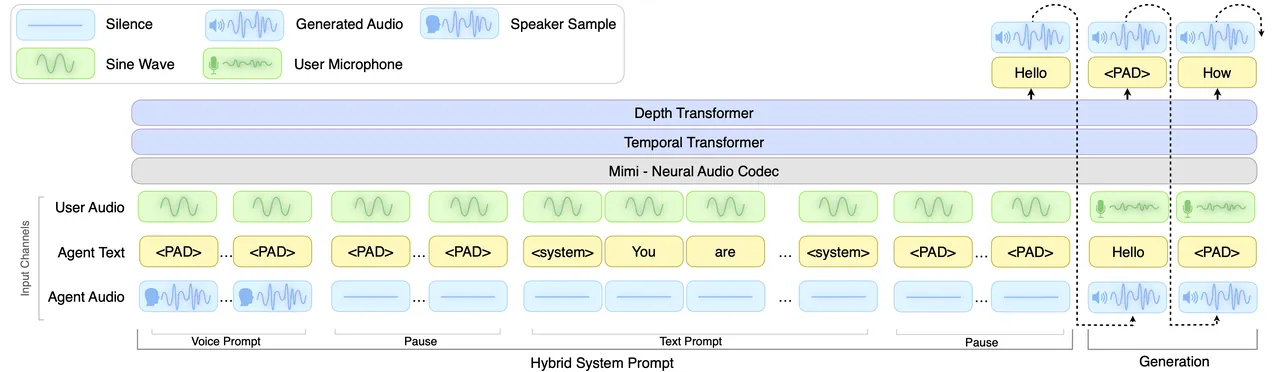
<PAD> 不是普通文本空格,而是训练时约定的控制位置。双流不是两个独立模型在轮流说话
“全双工”最容易产生的误解是:用户说话时模型一边识别,助手说话时模型一边合成。PersonaPlex 实际维护的是用户音频通道与助手音频通道的联合序列。服务端每次从浏览器 Opus 流中取出足够的 PCM,按 Mimi 的 80 ms 帧切成块;每编码一帧,就把它送入语言模型并取得同一时间位置的助手 token。助手音频不应答时,这个位置仍然是模型输出的一部分,只是表现为静音或控制 token。连续推进的结果,才是可被打断、可重叠的对话。
这个时间粒度可以从代码直接算出来:Mimi 的采样率为 24 kHz,帧率为 12.5 Hz,因此一帧正好是 24000 / 12.5 = 1920 个采样点,也就是 0.08 秒。服务端的 frame_size 就取这个值。语言模型主干使用 4096 维、32 层、32 个注意力头、3000 帧上下文;音频侧的 Depth Transformer 为 1024 维、16 头、6 层,并依靠延迟表协调不同音频码本的生成顺序。这里的目标不是把整段语音压缩成一个句向量,而是让每个 80 ms 槽位都可供双向推理。
| 组件 | 仓库中的实际配置 | 对交互意味着什么 |
|---|---|---|
| Mimi 编码器与解码器 | 24 kHz、12.5 Hz、8 个推理码本、SEANet 因果卷积 | 每 80 ms 处理一次输入与输出,适合持续接收麦克风流 |
| Temporal Transformer | 4096 维、32 层、32 头、上下文 3000 帧 | 在分钟级上下文里联合建模用户音频、助手文本和助手音频 |
| Depth Transformer | 1024 维、16 头、6 层、每步 8 帧上下文 | 在单个时间槽内组织多个音频码本,补足波形细节 |
| LM 音频配置 | n_q=16、dep_q=16,服务端解码 tokens[:, 1:9] | 权重配置支持 16 路音频槽;在线 WebSocket 输出路径实际解码 8 路助手音频 |
| 浏览器传输 | Opus,WebSocket 二进制消息 | 网络层持续压缩语音,模型侧接收解码后的 PCM 帧 |
表中最后两项的差异值得保留:不能看到 n_q=16 就说网页端生成 16 路音频,也不能因为 WebSocket 解码 8 路就反推模型只有 8 个码本。前者是模型配置和训练接口,后者是当前服务端面向 Mimi set_num_codebooks(8) 的实际推理路径。技术说明应把“模型支持什么”和“这条代码路径使用什么”分开。
声音条件如何进入模型状态
每个会话先确定一个声音提示。仓库附带 18 个固定选项:自然女声 NATF0 到 NATF3、自然男声 NATM0 到 NATM3、多样女声 VARF0 到 VARF4、多样男声 VARM0 到 VARM4。网页默认使用 NATF0.pt;这些是一组打包好的声音条件文件,不是让用户现场上传任意音频即可克隆的通用声音接口。
如果传入的是原始音频,load_voice_prompt() 会先重采样到模型采样率,再把响度归一到 -24 LUFS。代码使用 .pt 时走另一条更快路径:文件里保存了声音提示逐帧产生的 embeddings 和模型缓存,服务端直接重放这些状态,不必每次从波形重新编码。这个缓存设计解释了为什么默认声音选项都是 .pt:音色条件在会话开始前执行一次,之后的延迟预算主要留给文本与音频生成。
声音提示输入期间,文本通道固定为 0 号控制 token,助手音频通道也用正弦波提示占位。也就是说,参考声音建立的是“接下来谁在说”的声学状态,而不是让模型把参考音频当成用户刚说过的第一句话。随后代码插入约 0.5 秒静音,再把角色文本逐 token 注入;文本阶段仍保持静音与占位音频;最后再插入约 0.5 秒静音。完成后,Mimi 的流式状态被重置,才进入真正的用户音频处理。
声音提示帧 → 0.5 s 静音 → <system>角色文本<system> → 0.5 s 静音 → 双向会话这套顺序由 step_system_prompts() 的同步与异步两个版本共同保证。异步版本在声音提示、静音和文本提示的检查点之间查询连接是否仍存活,因此浏览器关闭后,服务端不必把长文本提示全部注入才退出。对一次会话而言,提示只初始化一次;声音或文本改变后,必须从对应的新状态重新开始会话。
角色文本控制的是对话行为,不是关键词检索
服务端会把客户端传来的文本包成 <system> ... <system>,再交给 SentencePiece tokenizer。网页默认角色是“wise and friendly teacher”,另外预置了诊所接待、银行客服和火星宇航员三个例子。它们覆盖了三种不同的约束:信息采集任务需要主动提问并核对资料;客服任务需要知道服务项目、价格与例外;自由对话任务则需要维持身份背景和话题方向。
训练数据也对应这两类角色。客服场景主要来自合成对话,模型学习在给定公司、姓名、业务信息和用户诉求后,把回答约束在角色知识与对话目标内;开放闲聊来自 Fisher English 的真实双人对话,研究团队用大模型为每段对话标注可读的角色提示。README 特别说明,模型是按一个固定助手角色和多种客服角色训练的,因此“任意复杂企业策略都能零样本遵守”并不是仓库给出的结论。提示中越依赖长表格、实时查询或多步审批,越需要外部工具与规则系统补充。
| 提示类型 | 适合写进文本提示的内容 | 不应默认模型能独立完成 |
|---|---|---|
| 对话身份 | 姓名、职业、关系、态度、谈话目标 | 未经训练的身份事实与长期记忆 |
| 客服任务 | 机构、业务范围、可用信息、价格、处理边界 | 实时订单查询、支付、退款和身份认证 |
| 开放闲聊 | 兴趣、背景经历、当前情境、希望讨论的话题 | 对事实准确性与安全边界的额外保证 |
| 突发场景 | 地点、角色、正在发生的事件、需要对方参与的目标 | 仓库未覆盖的专业处置流程 |
提示工程上的实用原则是:把“是谁、知道什么、现在要做什么”写成可听见的角色约束,少写只有阅读才能理解的长篇排版。PersonaPlex 的输出首先是语音行为,模型需要知道该不该追问、该多快回应、遇到用户打断时是否停下、语气应该多正式。文本里塞满不可朗读的格式符号,只会消耗上下文,不会自动变成稳定的对话策略。
一次 WebSocket 会话在服务端怎样运行
浏览器连接 /api/chat 后,服务端先解析 voice_prompt、text_prompt、随机种子等查询参数,创建 Opus 读写器并重置 Mimi 与语言模型状态。声音提示和文本提示初始化期间,连接还没有收到开始握手,三种运行循环也尚未启动;初始化完成后,服务端先发送一个 0 字节,告诉客户端可以进入会话。
之后,recv_loop 持续接收浏览器发来的二进制消息,首字节 1 表示音频,其余负载追加给 Opus 解码器;opus_loop 把解码后的 PCM 拼成 80 ms 块,按帧执行 Mimi 编码和语言模型生成;send_loop 则从 Opus 写出器读取已编码的助手音频并立即发回。另有首字节 2 的消息用于发送逐步文本 token。三个循环相互独立,是“用户还能说、助手可以继续生成”的工程实现基础。
模型本身不是并发生成器。ServerState 持有一个 asyncio.Lock,整个会话在这个锁内运行,因此一个模型实例同一时刻只服务一个对话。仓库的默认启动方式也只构造一套 Mimi、LM 和生成状态,并未内置多租户调度。需要并发时,应该部署多个进程或模型副本,再在外层做队列和容量控制;让多个 WebSocket 同时请求同一实例,只会在锁外排队,并不会提高吞吐。
每条连接结束时,三个任务通过 asyncio.wait(..., FIRST_COMPLETED) 收束,其余任务被取消,然后关闭 WebSocket。断线检查通过短超时读取连接状态完成,避免等待用户继续发送音频。对生产部署而言,这比“断开后仍把提示阶段跑完”节省显存和计算,但临时 SSL 证书、直接暴露 8998 端口都不适合作为公网服务方案;这些命令是本地演示入口,不是带鉴权、限流和租户隔离的生产网关。
离线脚本与在线服务共享同一条提示路径
仓库同时提供 python -m moshi.offline。它用一段输入 WAV 模拟用户侧连续音频,输出一段与输入等长的 WAV,并另存按时间生成的文本 token 列表。离线模式加载同样的 Mimi、tokenizer 和 Moshi 权重,构造同样的 LMGen,执行同样的“声音提示 → 静音 → 文本提示 → 静音”,随后逐帧喂入用户音频。
在线与离线结果不应被理解为完全相同的产品能力。在线服务还要经过 Opus 编解码、网络抖动、浏览器音频设备、任务调度和播放缓冲;离线脚本去掉这些因素,适合比较声音提示、文本提示和采样参数对固定输入的影响。反过来,离线脚本也不能证明实时体验,因为它不测量 WebSocket 端到端延迟,也不模拟用户中途打断。
脚本会把生成结果截断或补零到输入音频长度,这让批量评测更容易对齐,但也意味着“等长”不是模型天然的输出约束。真实对话会持续多久,取决于双方何时停止、服务端何时关闭流以及浏览器何时结束播放。使用离线文件做 AB 测试时,应固定输入、随机种子、声音提示和采样参数,再分别评价内容、音色稳定性与打断后的恢复,而不是只看输出是否生成了一个完整句子。
部署前必须看清的三条边界
第一条是许可证边界。代码仓库采用 MIT 许可证,但 PersonaPlex 权重采用 NVIDIA Open Model License,使用前需要在 Hugging Face 接受模型许可证并提供 HF_TOKEN。因此,准确表述是“MIT 代码 + 有条件使用的权重”,而不是“整个项目都是 MIT”。如果只是阅读源码,许可证问题较小;一旦下载权重、部署服务或分发派生结果,就必须按权重条款处理。
第二条是硬件边界。--cpu-offload 的语义是把放不进 GPU 的模型层暂时放到 CPU,并在前向计算时调回,不是“完全用 CPU 推理”的开关。README 明确要求安装 accelerate,默认设备仍是 CUDA。真正无 GPU 的离线评测需要安装 CPU-only PyTorch,速度与实时能力不应按 GPU 服务器上的表现推断。
第三条是服务边界。源码会直接把请求里的 voice_prompt 与配置目录拼接,然后加载命中的文件;默认界面只提供固定选项,但没有在生产层替你做身份认证、请求限流或文件访问隔离。若要把 WebUI 开放给外部用户,至少需要验证声音文件名、只允许白名单文件、把模型服务放在受控内网,并在网关增加鉴权与并发限制。把研究演示脚本原样暴露到公网,会同时放大资源滥用和文件加载风险。
当前仓库快照对应提交 3428dfd95309a7f3c84fd93259ded0f810d1ff91,论文为 arXiv:2602.06053。它给出的是一套可复现的研究与演示实现:固定语音集合、单一角色提示、流式服务端和离线评测入口都很清楚;至于多租户调度、业务工具调用、任意声音克隆与生产级安全策略,并不在仓库已经完成的能力范围里。
怎样判断它是否适合自己的场景
如果你的目标是低延迟、可打断的语音角色,而且角色知识与对话规则能够在会话开始时写进一段文本提示,这个项目值得优先试验。特别适合的测试包括:用户在一句话中途改主意时模型能否停止旧回答;助手在用户思考停顿时是否不过度抢话;切换预置声音后,角色音色是否保持一致;同样的提示在客服、陪伴和技术讨论里是否出现明显的指令漂移。
如果目标是严格的流程执行、百分百准确的企业信息答复、长时记忆或多用户并发,评估重点应放在模型外部。让 PersonaPlex 负责自然语音交互,把身份验证、知识检索、事务接口、权限和审计放到确定性服务中,通常比不断加长角色提示更可靠。它最有价值的部分是实时语音状态与人设条件如何结合;它不替代业务系统,也不自动保证对话内容正确。
复现时建议先跑离线输入,锁定一个声音提示和一条角色文本,检查文本 token 与音频是否同步;再启动本地 WebUI,用单个浏览器会话测试开始、打断、静音和断开;最后才做多会话压力测试。这样能把“模型行为不对”“音频链路有问题”“服务容量不足”分开定位。项目包含的架构图、源码和离线脚本足以支撑这类逐层验证,但仓库没有提供一套可直接照抄的生产 SLA。