
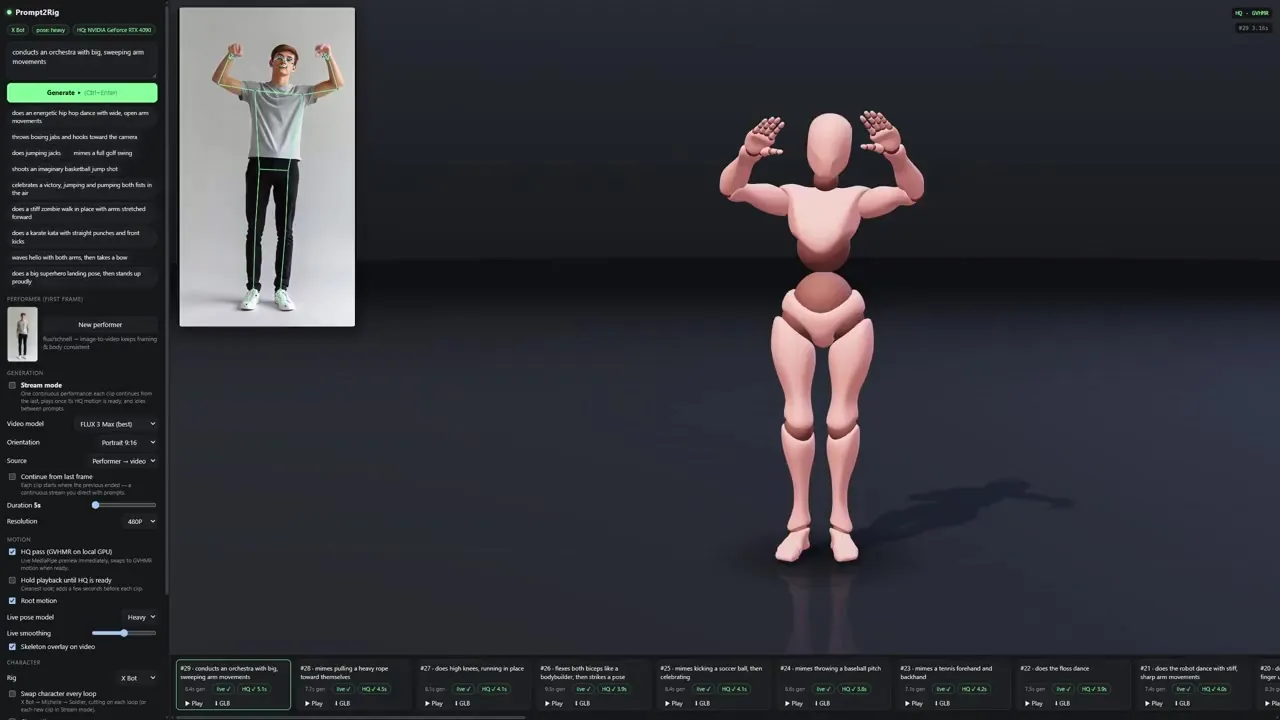
一句话生成可导出的 3D 动作:prompt2rig 如何把 AI 视频变成手指级 Mixamo 动画
prompt2rig 用视频模型演出一句动作描述,再以浏览器 MediaPipe 和本地 GVHMR/WiLoR 双路重建身体与手指,重定向到 Mixamo 并导出 GLB。拆解流水线、加速、局限与许可边界。
大多数 text-to-motion 演示会直接让模型从一句文字里想象关节旋转。prompt2rig 走的是另一条路:先让视频模型把这句话演出来,再从像素中恢复动作,并把它映射到带骨骼的角色上。最终得到的东西不是一段机器人视频,也不是渲染完成的成片,而是一段可以在浏览器里播放、检查并导出为 GLB 的骨骼动画。
这个项目值得拆解,是因为它没有把整条链路藏在一个接口后面。托管视频模型负责生成动作,浏览器里的 MediaPipe 提供即时预览,本地 GPU worker 再运行 GVHMR 和 WiLoR,得到更干净的身体与手部轨迹。独立的 retargeting 层把两种动作来源统一转换成 Mixamo 骨骼旋转。这样的拆分容易理解,也直接暴露了系统的强项和薄弱处。
核心思路:把生成视频当作中间动作格式
常规的单目动作捕捉从真实录像开始。prompt2rig 先把录像这一步生成出来:文字提示会附带一套拍摄约束,送进视频模型后变成一个人表演的短片。随后,这段短片进入与视频动捕相同的一类算法,被恢复成关节动作。
绕这一圈有两个直接后果。好处是视频模型天然提供了节奏、轮廓、四肢轨迹和手势,项目不必再训练一个 text-to-SMPL 模型。代价是视频模型产生的每一个时间不一致、穿地、多余手指或肢体重叠,都会变成姿态估计器的输入错误。prompt2rig 用固定人物参考图和强约束提示词来压低这个风险,但它无法从根本上消除。
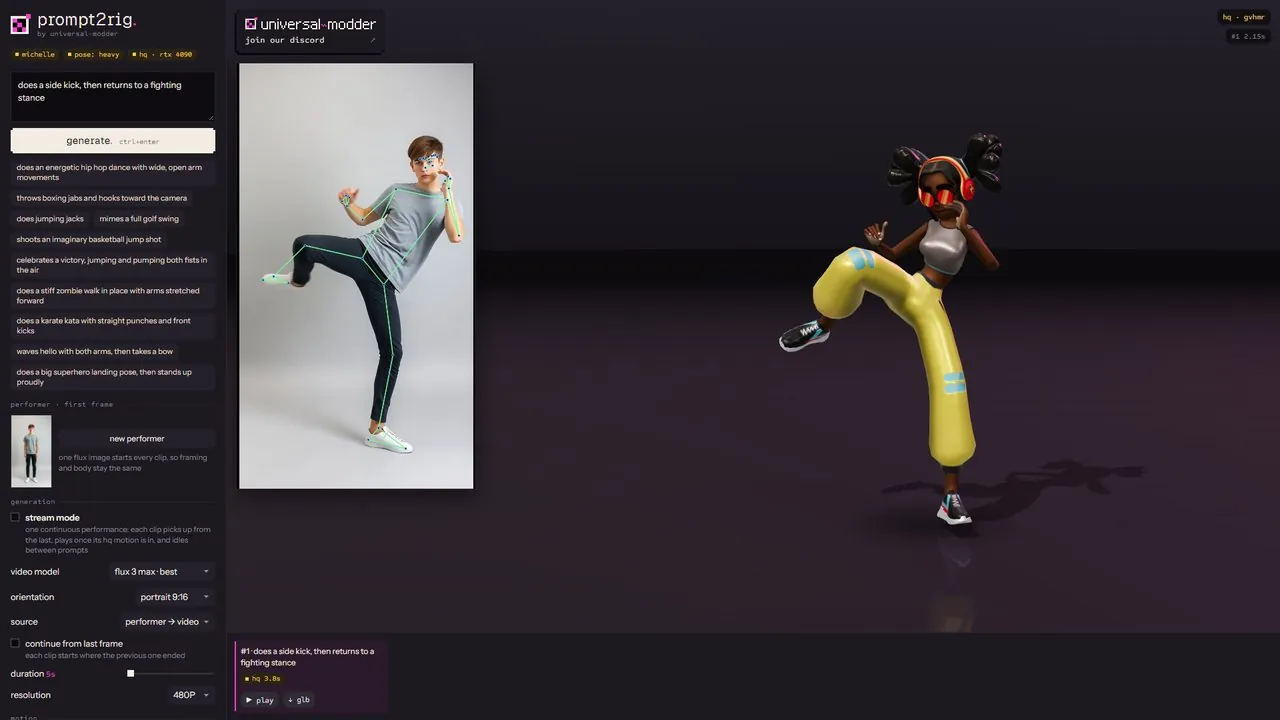
完整流水线
| 阶段 | 运行位置 | 输出 |
|---|---|---|
| 人物参考图 | fal,模型为 fal-ai/flux/schnell | 纯色影棚背景上的居中全身人物 |
| 视频生成 | fal,H3 Max Turbo 或 FLUX 3 Max | 一段 5 到 20 秒的目标动作 |
| 实时预览 | 浏览器,MediaPipe Pose | 带噪声但立即可用的关键点动作 |
| HQ 身体重建 | 本地 FastAPI worker,GVHMR | SMPL 全局朝向、每帧 63 个 body pose 值、平移和腿长 |
| HQ 手指追踪 | 本地 GPU,WiLoR 或 MediaPipe Hands | 每只手每帧 21 个关键点,绑定到身体并转到世界坐标 |
| 重定向 | 浏览器,three.js | Mixamo 骨骼的局部四元数轨道,以及落地的髋部路径 |
| 导出 | 浏览器,GLTFExporter | 包含骨骼动画和髋部位移的 GLB |
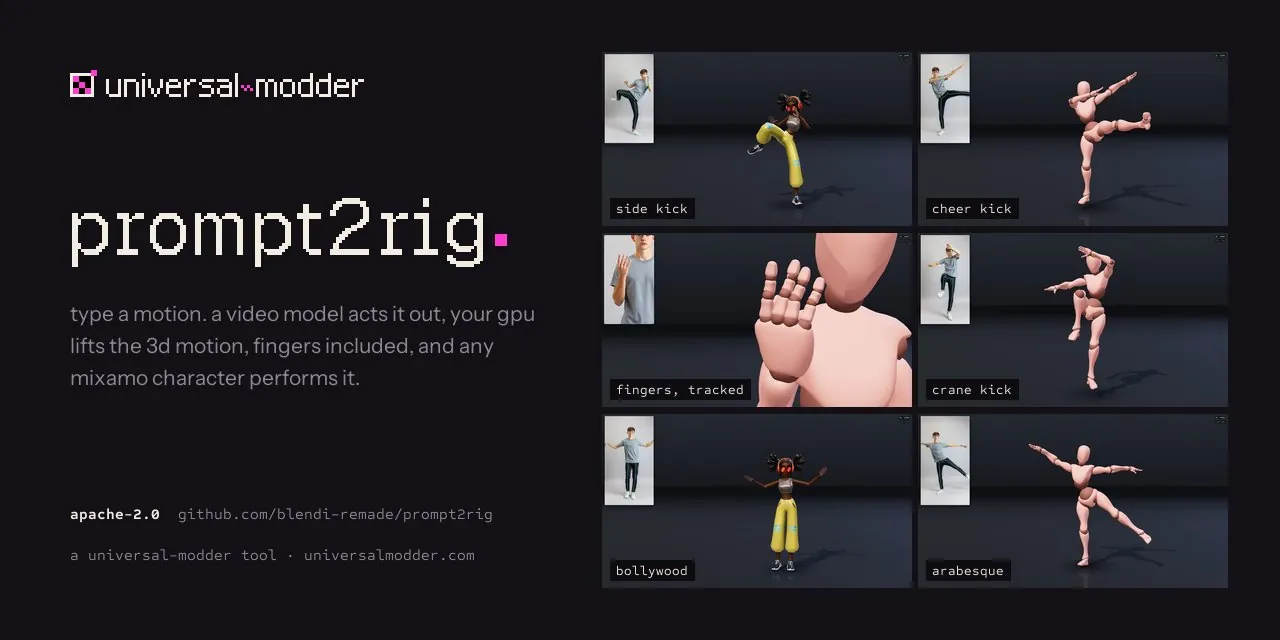
为什么先生成一张人物图
应用先通过 FLUX.1 schnell 生成一张人物照片:一名年轻人站在纯色浅灰影棚中,身体从头顶到脚底完整可见,双臂自然下垂,穿着浅灰 T 恤、深色长裤和白色运动鞋。随后,这张图作为 image-to-video 的首帧,用来生成具体动作。普通模式下,多个 prompt 可以复用同一个角色和构图;stream 模式则改用上一条视频的最后一帧。
这一步让下游问题简单了不少。视频模型获得了稳定的身份参照,人物在画面中足够大,姿态裁切更容易成功,场景也不会出现切镜或相机运动。提示词模板还会强制附加“双臂清楚可见并远离躯干”“不要转身”“不要翻跟头”“固定机位、不推拉、不剪辑”等条件。这些不是装饰性提示,而是在主动避开单目估计器最容易判错的歧义。
实时路径:低延迟,但几何量有限
生成视频开始播放时,MediaPipe Pose 在浏览器里同步运行,输出 33 个身体关键点和一组世界坐标关键点。应用把这些坐标转成 three.js 空间中的位置,用自适应 One Euro filter 去抖,根据肩部和髋部的 2D 位置估计躯干尺度,再驱动 Mixamo 骨骼并记录成一条可播放的实时轨道。
这条路径最大的优势是延迟。它不需要服务端回传,也不需要等待数 GB 的模型启动;视频一可用,角色几乎马上就会跟着动。问题全部来自几何质量:关键点会抖动,单目深度不可靠,肢体交叉时左右身份可能互换,33 个点也不能完整描述人体表面。应用提供平滑参数和根运动修正,但滤波器不能补出没有观测到的深度。
HQ 路径:在整段视频上恢复人体模型
HQ worker 针对 prompt2rig 生成的片段做了专门设计。既然画面里只有一个人、机位固定、背景简单,就没有必要使用昂贵的多目标跟踪。worker 以 batch 方式运行 YOLO11m,每帧保留最大的那个人,补齐短暂漏检,再对检测框做平滑。检测和裁切共用同一批解码帧,避免重复读取;输入长边被限制在 854 像素,因为 GVHMR 最终处理的仍然是小尺寸人体裁切;视频则统一重采样到 30 fps。
GVHMR 随后恢复一段固定比例人体的 SMPL 参数,并输出带重力方向的根轨迹。worker 返回全局朝向、每帧前 63 个 body pose 值、平移和实测腿长,还返回首帧相对相机的朝向,用来让连续生成的片段保持一致的前进方向。GVHMR 看的是整段序列,并非逐帧独立求解,因此能减少实时 landmark 重定向中常见的肢体拉伸和前臂扭转。
实现里还有几项很具体的加速。batch 检测替代逐帧跟踪,ViTPose 默认关闭镜像翻转测试,所有 CUDA 调用固定在同一组预热线程上,人体恢复前先缩小输入。README 给出的数据是:原版 GVHMR 路径约 10 秒,优化后在 RTX 4090 上处理 5 秒片段约 3.4 秒。
手指是一个独立的几何问题
常见人体模型通常止于手腕。prompt2rig 因此在 GVHMR 处理身体的同时,额外对原始全分辨率片段运行手部检测和姿态模型。它支持带 MANO 的 WiLoR,也支持更轻量的 MediaPipe Hand Landmarker。每只手用 21 个关键点表示,顺序与 MediaPipe/OpenPose 相同:手腕、四根手指各四个点,再加上拇指四个点。
把手分配给人并不简单。手部模型给出的左右手标签会翻转,而身体关键点提供的左右关系更稳定。代码会把手部结果分配到最近的身体手腕,对左手裁切做镜像以匹配 WiLoR 的右手先验,推断完成后再解除镜像,最后把手部轨迹重采样到身体动作的帧率。
手部关键点还必须从相机坐标旋转到 GVHMR 的世界坐标。worker 根据世界坐标和相机坐标中的骨盆朝向,逐帧构造变换:
$$R_{w \leftarrow h}(t) = R_{w \leftarrow c}(t)R_{c \leftarrow h}(t)^T$$
这两个源旋转分别描述骨盆在世界和相机坐标中的姿态。得到的矩阵作用在以手腕为原点的局部手部点上,于是手指既能跟随恢复出的 3D 世界运动,又不会脱离手腕。
漏检会被明确保留,而不是假装补全。长度不超过 0.4 秒的空缺可以插值,更长的缺失继续保持 invalid;每段有效区间单独做高斯平滑,30 fps 下标准差为 1.2 帧。某只手完全缺失时,重定向器会给它一个自然的放松弯曲,而不是僵硬的平掌。
每只手最终驱动 15 根骨骼,也就是五根手指各三节。代码让每节骨骼尽量朝向测得的指段方向,但不强迫所有手指只沿一个掌心法线弯曲;它会限制反向弯折,并把指根与关节的弯曲角限制在合理范围内。WiLoR 的 MANO 输出被认为已经满足解剖约束,因此不经过 MediaPipe 路径上更强的关节限位。
重定向:先对齐旋转,再处理尺度
身体路径把 22 个 SMPL 关节映射到 Hips、Spine、LeftArm、RightUpLeg、LeftToeBase 等 Mixamo 骨骼。目标角色的静止姿势提供髋部基座和胸部基座,源动作的世界旋转被转换成局部四元数。髋部路径会平移到目标坐标系,并按目标腿长与表演者腿长的比值缩放。
$$s = \frac{L_{\mathrm{rig}}}{L_{\mathrm{human}}}$$
重定向后,代码会检查最低的脚是否低于静止姿势的地面;如果会穿地,就抬高髋部。这一步能修正明显的悬空和下沉,但它不是接触求解器:脚底滑动、跳跃落地时的穿透和压力分布都没有建模。
实时路径先用 One Euro filter 平滑 MediaPipe 关键点。HQ 路径本身更稳定,浏览器只需要采样重建好的轨道,并在 600 毫秒内从实时动画交叉淡入 HQ 结果。切换角色使用更短的 250 毫秒混合。导出 GLB 时,代码把当前最佳轨道采样成局部旋转关键帧和一条髋部位置轨道,再交给 three.js 的 GLTFExporter 写成二进制文件。
Stream 模式与累积漂移
Stream 模式尝试把多次生成拼成一段近似连续表演。每个新片段都把上一段视频的最后一帧作为 image-to-video 起点。若下一条 HQ 动作还没返回,应用会保持最后姿势,或在队列即将耗尽时先用实时路径启动下一条;用户 prompt 之间则自动插入短 idle 动作。上一段的水平根偏移会带到下一段,并限制在 2.5 米以内。
它比每次都从同一张中立图重新开始更连贯,但也继承了两种漂移。视频模型可能逐步改变人物身份、服装或身体比例;上一段最后一帧也不能保证下一段动作在物理上连续。更准确的理解是“带动作感知的视觉拼接”,而不是长时程世界模型,更不是无缝接触保证。
性能数字
| 操作 | 配置 | 作者报告时间 |
|---|---|---|
| 快速视频生成 | H3 Max Turbo,480P,5 秒 | 总耗时约 2 到 3 秒,GPU 0.5 秒 |
| 更高质量视频 | FLUX 3 Max,720p,5 秒 | 总耗时约 8 到 9 秒,GPU 4.5 秒 |
| HQ 身体恢复 | GVHMR,RTX 4090 | 约 3.5 到 4 秒 |
| 手指追踪 | WiLoR,与 GVHMR 并行 | 额外约 0.3 秒 |
这些是作者在 Windows 11、RTX 4090 和调优过的环境中,对生成式单人片段测得的结果,不能直接当成通用吞吐。服务端封装里 FLUX 3 的最短时长是 5 秒,H3 可以更短;模型平台排队、视频下载和首次 CUDA 初始化也没有完全包含在 GPU 推理数字里。
它会在哪些地方失效
核心限制不在某一个网络,而在输入假设。系统要求单人、固定相机、干净背景、完整身体可见,并且四肢始终能分开。转身、旋转、翻腾、地面动作、抱臂、手被遮住、宽松衣服和特殊机位,都会压到整条链路最脆弱的部分。提示词模板主动避开这些场景,因为姿态估计器可能交换左右、丢失深度,或者在躯干后面凭空补出一条肢体。
动作看起来正确,也不等于物理上有效。prompt2rig 会让最低脚贴地,并限制手指反向弯折,但它没有求解接触、力矩、质心或机器人关节限位。目前也没有公开的量化基准,去衡量长动作的自然度、手指精度、脚底滑动或 sim-to-real 迁移。演示足以证明它可以生成有说服力的短片段,但还不足以证明它达到了动作捕捉产品的精度。
Windows 加 NVIDIA GPU 是另一个现实门槛。浏览器部分只需要 Node,但推荐的 HQ 路径依赖本地 CUDA、约 5 GB 的 GVHMR checkpoint、注册下载的 SMPL-X,以及可选的 MANO 和 WiLoR 权重。它不是一个打开网页就能完整运行的零安装服务。
机器人团队为什么仍然值得看
对机器人最有参考价值的,是把动作生成、动作恢复、重定向和执行分开。机器人学习系统可以把生成视频替换成真人演示,把 Mixamo 替换成人形机器人,把 GLB 导出替换成轨迹与控制器。这个项目展示了一个实用前端:如何从视频得到可检查的关节运动,同时保留中间人体表示。
它同时也清楚地标出了动作捕捉之后还缺什么。人形机器人需要接触时序、质心一致性、关节速度与力矩限制、碰撞感知重定向,以及动作不可行时还能恢复的控制器。prompt2rig 不是机器人控制系统,不是动力学模型,也不是经过验证的 sim-to-real 流水线。它是一个浏览器原生内容与原型工具,其中的重定向思路可以作为这些系统的上游。
实际运行
git clone https://github.com/blendi-remade/prompt2rig
cd prompt2rig
cp .env.example .env
# 在 .env 中填入 FAL_KEY
node server.mjs
这会在 http://localhost:5177 启动 Web 应用和 MediaPipe 实时路径。若要启用 HQ,在 Windows 上运行 hq\setup.ps1,把 SMPLX_NEUTRAL.npz 放到 hq/body_models/smplx/,可选地用 hq\setup_hands.py 安装 MANO,然后启动 hq\.venv\Scripts\python hq\worker.py。worker 监听 127.0.0.1:5178,模型加载后会保持常驻。
许可才是真正决定能否上线的地方
| 组件 | 许可状态 | 实际影响 |
|---|---|---|
| prompt2rig 自有代码 | Apache-2.0 | 项目自身代码是宽松许可 |
| GVHMR | 仅限教育、研究和非营利使用 | HQ 身体路径不能直接商用 |
| SMPL-X | 非商业注册,另有商业许可 | 商业产品必须单独授权人体模型 |
| WiLoR | CC-BY-NC-ND | HQ 手指路径不允许商业使用 |
| MANO | 非商业注册 | 商用必须获得单独授权 |
| Ultralytics YOLO | AGPL-3.0 或商业许可 | 网络部署可能触发 copyleft 义务 |
README 对这个拆分写得非常直接:Web 界面、MediaPipe 实时预览和托管视频生成在各自条款下可以商用,但推荐的 HQ 身体与手指栈是研究用途。准备上线时必须替换或单独授权 GVHMR、SMPL-X、WiLoR、MANO 和检测器。只说“仓库是 Apache-2.0”会遗漏最关键的限制。
prompt2rig 真正证明了什么
它有说服力,是因为把几套成熟组件接成了清晰的契约。视频生成提供有表现力但不可靠的观测,MediaPipe 提供速度,GVHMR 提供连续的人体模型,WiLoR 提供手指,重定向层提供通用骨架接口,GLB 导出则让结果离开演示页面。真正的工程工作大多发生在这些模块的接缝上:拍摄约束、坐标系、左右手、尺度、平滑、混合和无效数据处理。
因此,正确的读法不是“文字已经能生成生产级动作捕捉”,而是“只要场景受控、底层许可符合用途,生成片段就可以被转换成可编辑、可导出的骨骼表演”。它证明的是一条可运行的视频到动作资产路径,不是通用动作理解,也不是机器人执行能力。
来源:GitHubDaily 在 X 发布的 “一句描述生成带手指的 3D 动作”,以及 blendi-remade/prompt2rig 仓库。本文依据仓库 README、服务端、重定向、HQ worker、手部追踪和 Blender 导出源码撰写。公开视频已存在于 RobotWorld 的 X 演示记录中;本文新增的是完整双语技术分析,而不是重复生成视频卡。
原文来源:GitHubDaily / prompt2righttps://x.com/GitHub_Daily/status/2114326173430042791