
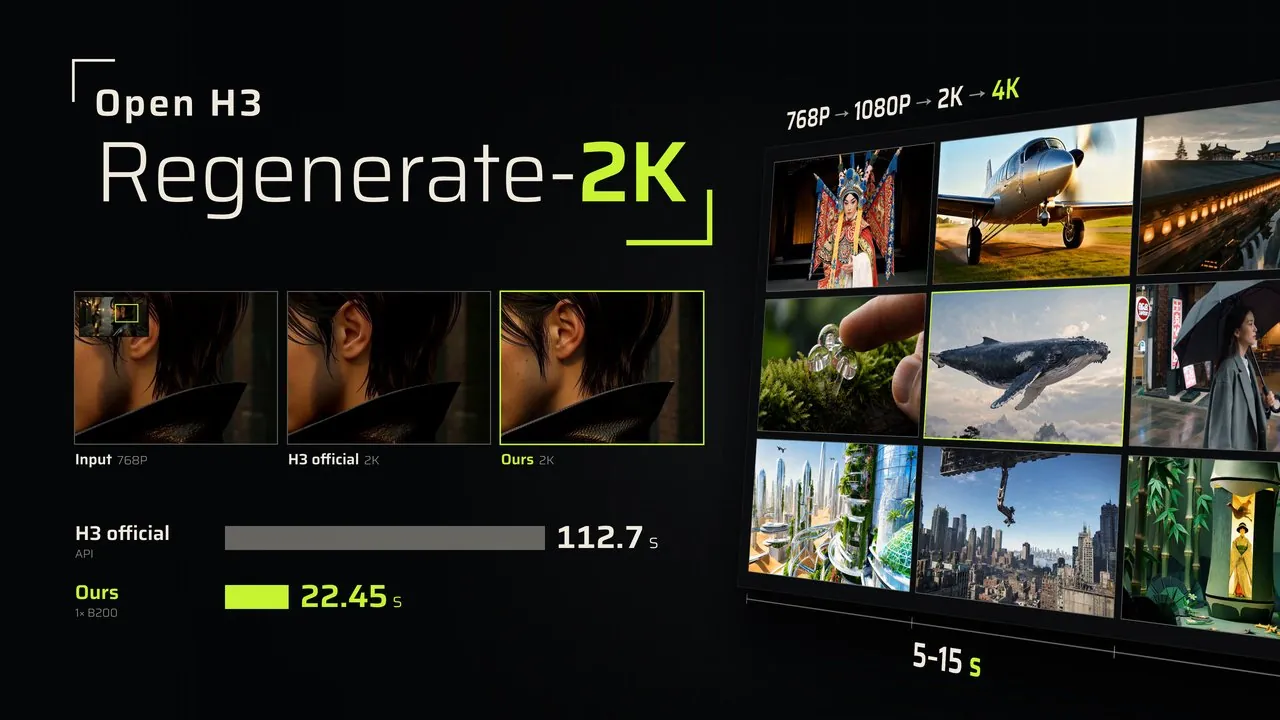
Open-H3-Regenerate-2K:三步扩散把低分辨率视频重绘到原生 4K
Open-H3-Regenerate-2K 冻结 H3 主干与 VAE,只训练细化 LoRA,用潜空间放大和三次扩散把任意低分辨率草稿重绘到原生 768P 至 4K。
高分辨率视频生成通常被拆成两个独立阶段。扩散模型先在可承受的分辨率上确定场景、动作和整体构图;第二个模型再以全尺寸重绘这份草稿,补上低分辨率采样阶段没有足够算力生成的细节。MiniMax 的 H3-Regenerate-2K 正是在托管 API 背后完成第二步,但权重并未开放。开源 H3 基座能够生成草稿,却无法在本地执行这一专有的高分辨率细化过程。
Open-H3-Regenerate-2K 补上的就是这个缺口。它冻结 H3 Transformer 与 H3 视频 VAE,只用真实高分辨率视频及其退化副本训练一个细化 LoRA,并通过三次扩散步骤完成整个重绘。输入既可以来自 H3,也可以来自 LTX-2、SANA-Video 等其他视频模型;输出支持 768P、1080P、2K(2560 x 1440)和 4K(3840 x 2160),5 至 15 秒的视频可以在一次前向流程中处理。
这项工作来自 NVIDIA 与 SoL-Engine 团队。它的核心主张并不是“开源视频生成已经在所有方面追平闭源服务”,而是一个更具体的判断:冻结的开放 H3 栈加一个经过训练的小型细化器,可以复现“把草稿变成高分辨率结果”这一单独阶段,同时接受更丰富的输入与输出尺寸,并在本地硬件上达到可用速度。作者围绕这一阶段给出了质量与速度测量,并公开了推理路径。
H3 为什么需要一个开放的第二步
H3 把视频生成拆成低成本的低分辨率阶段和高成本的高分辨率阶段,原因很实际。如果从开始采样就一直在 2K 或 4K 上运行,大型 Transformer 就要在极端庞大的 token 网格上反复计算。相反,基座模型可以先在较小的潜变量网格上决定画面中有什么、它们如何运动;细化模型随后接收草稿,保留其内容与时间结构,把计算集中到只有最终尺寸才会显现的细节上。
托管的 H3-Regenerate-2K API 提供了第二步,但也限制了它的使用方式。作者说明,该 API 只接受未经修改的 H3 768P 输出,并返回 2K 结果。它不提供权重,因此使用者不能在自有 GPU 上运行细化器,不能接在其他草稿模型后面,不能输出其他分辨率,也无法研究其内部机制。Open-H3-Regenerate-2K 用一个开放实现承担相同功能,同时改变这些操作边界。
这也说明项目中真正新增的部分是什么。H3 Transformer、H3 VAE 以及基座模型形成连贯草稿的能力仍然来自上游;贡献集中在它们周围的细化组件:目标网格潜变量放大、经过训练的 LoRA、三步噪声计划,以及系统级推理优化。这项工作没有声称三步细化器能够取代 H3 原本的内容生成过程。
| 属性 | 官方 H3-Regenerate-2K API | Open-H3-Regenerate-2K |
|---|---|---|
| 可获得性 | 托管服务,不公开模型权重 | 围绕 H3 构建的开放推理路径 |
| 接受的草稿 | 未经修改的 H3 768P 输出 | H3、LTX-2、SANA-Video 及其他低分辨率草稿 |
| 展示的草稿尺寸 | 1344 x 768 | 672 x 384、896 x 512、1024 x 576、1344 x 768 等 |
| 原生输出 | 2560 x 1440 | 1344 x 768、1920 x 1080、2560 x 1440、3840 x 2160 |
| 细化步骤 | 没有以开放实现的形式说明 | 三次全分辨率 Euler 步骤 |
| 视频时长 | 由服务规定 | 一次处理 5 至 15 秒 |
四阶段细化流水线
细化器封装冻结的 H3 Transformer 与视频 VAE。它接收草稿视频和文本提示,在更大的目标分辨率上输出相同场景与运动。
- 只编码一次。H3 VAE 把低分辨率草稿编码成潜变量。
- 在潜空间中放大。社区模型 H3-Latent-Upscaler 使用学习到的三维卷积网络,直接把该潜变量映射到目标网格。
- 部分重新加噪。放大后的潜变量只被破坏到足以让细化器重建缺失细节的程度,不会放任草稿构图漂移。
- 执行三步并解码。冻结的 H3 Transformer 在细化 LoRA 的适配下执行三次全分辨率 Euler 步骤,再由 H3 VAE 解码回像素。快速路径使用 StreamRender-H3 的 24 层解码器。
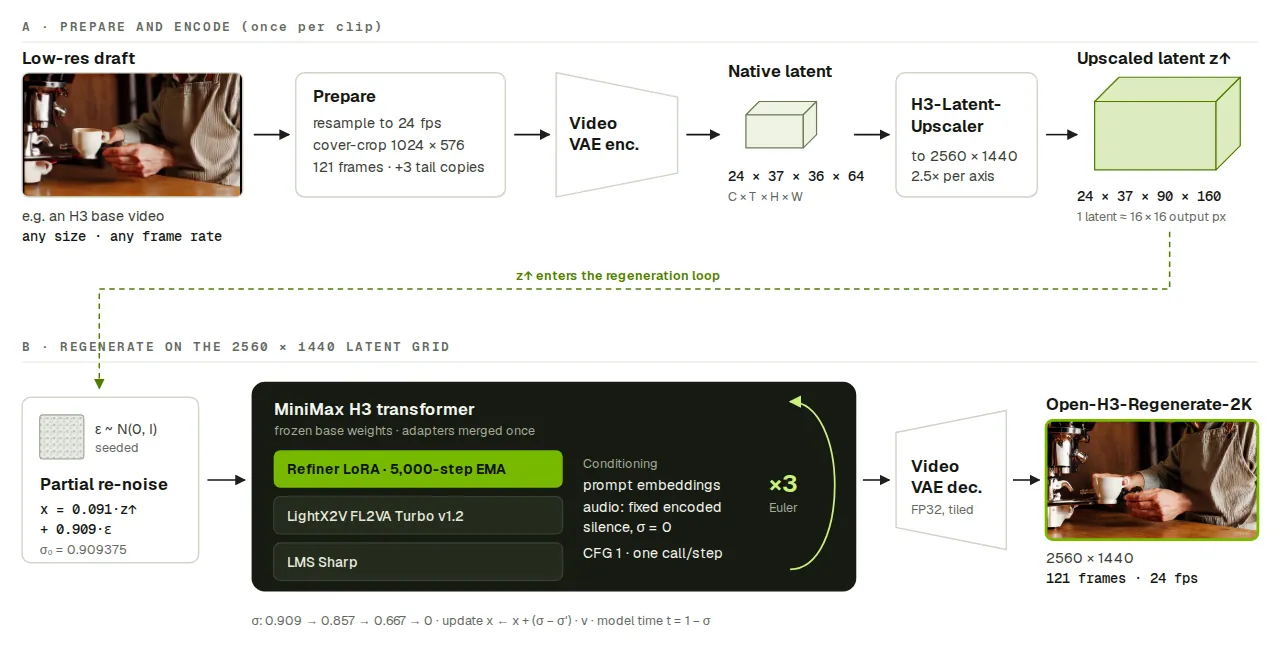
这里必须保留一个关键限定:潜变量放大本身不会产生可信的高频细节。它把布局、颜色、粗糙边缘和运动带到更大的网格上;真正负责在更多像素中重绘表面的是三次扩散。因此,这项工作的定位是“重新生成”,而不是一个只对放大结果做锐化的视频超分辨率网络。
视觉对比展示了什么
作者提供的对比保持同一帧、同一裁切区域。第一组输入是 H3 基座生成的草稿,两个输出均为 2560 x 1440,分别是官方 H3-Regenerate-2K API 与开放模型的结果。局部裁切放大了细化器最需要恢复的那类细节。
本站无法复现项目页上的交互式放大镜,因此把一组代表性 H3 草稿对比拆成三个短视频:输入、官方 API 输出与开放模型输出。三段视频分别播放,不伪装成同步比较器。它们用于展示被比较的时间证据,不能替代完整基准测试。
项目还展示了以 1024 x 576 准备的 LTX-2 与 SANA-Video 草稿。这项实验很重要,因为它检验细化器是否只依赖 H3 基座产生的图像统计。作者报告,模型在保留替代草稿场景与运动的同时,施加了学习到的高分辨率细节分布。工程意义在于:只要草稿的潜变量布局与内容兼容转换路径,细化器就可以接在不同低分辨率生成器之后。
从任意低分辨率草稿到原生 4K
模型并不绑定单一输入或输出尺寸。项目展示的低分辨率输入包括 672 x 384、896 x 512 与 1024 x 576。草稿只编码一次,其潜变量被放大到所选目标网格,三次扩散都在该尺寸上执行。作者列出的原生输出包括 1344 x 768、1920 x 1080、2560 x 1440 与 3840 x 2160。
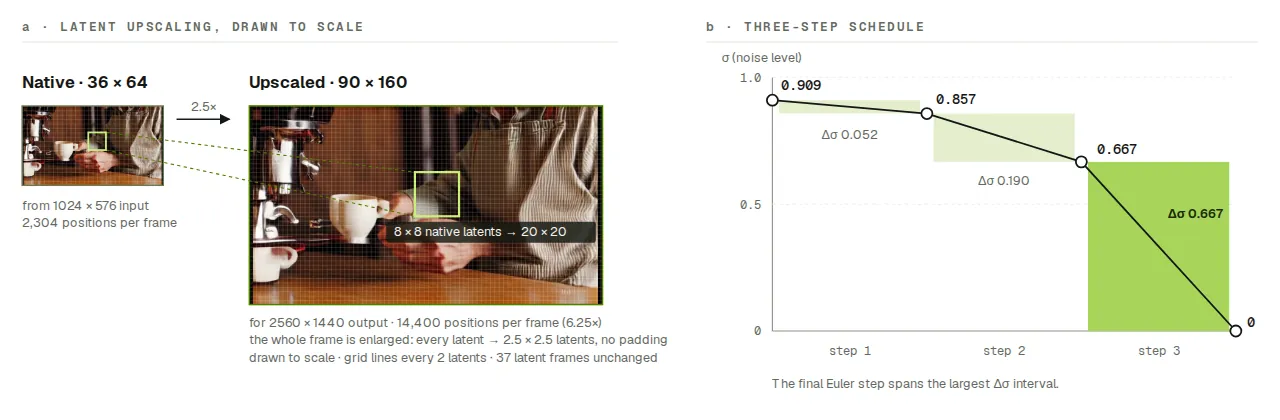
在 2K 路径中,作者给出的潜变量网格从 $36 \times 64$ 增至 $90 \times 160$,每边放大 2.5 倍,同时保留 24 个通道与 37 帧潜变量时间长度。4K 路径会调用 H3-Latent-Upscaler 两次,每次都处在其训练范围内。与之相对的朴素方案是做一次 4K 放大:尺寸变大了,但不会凭空增加新像素预算所需的细节。
| 阶段 | 项目使用的示例 | 发生了什么 |
|---|---|---|
| 输入草稿 | 672 x 384;896 x 512;1024 x 576;1344 x 768 | 内容与运动已经确定 |
| 原生 768P | 1344 x 768 | 在 768P 网格执行一次细化 |
| 原生 1080P | 1920 x 1080 | 潜变量与扩散计算转移到 1080P 网格 |
| 原生 2K | 2560 x 1440 | 潜变量从 36 x 64 放大到 90 x 160 |
| 原生 4K | 3840 x 2160 | 潜变量放大器执行两次 |
长视频不需要拼接
Open-H3-Regenerate-2K 支持在一次流程中处理 5 至 15 秒视频。项目中的 15 秒示例包含 360 帧,并以 2K 分辨率一次完成细化。这样就不必把镜头拆成多个短窗口、分别细化再混合,从而避免接缝以及跨窗口的身份一致性管理。它并不意味着模型支持任意长度视频;这里给出的范围就是当前工作边界。
训练:学习退化过程拿走了什么
细化器沿用 SoL-Refiner 的高分辨率持续训练配方,也就是其第一阶段,只把原始基座模型换成 H3。每个训练对从一段真实高质量视频开始,尺寸为 1280 x 704 或 2560 x 1440。原始视频是目标,退化副本是条件:先用抗锯齿双线性滤波缩小 8 至 64 倍,再放回原始尺寸。两者都经过 H3 VAE 编码。
设高分辨率潜在表示为 $z_{\mathrm{hq}}$,缩放倍数为 $s$,抗锯齿双线性下采样为 $D_s$,恢复尺寸的上采样为 $U_{1/s}$,则条件可以写成
$$ z_{\mathrm{cond}} =E_{\mathrm{VAE}}\!\left( U_{1/s}\!\left(D_s(x_{\mathrm{hq}})\right) \right), \qquad s\in\{8,16,32,64\}. $$H3 Transformer 全程冻结,只优化细化 LoRA。训练使用流匹配速度损失,噪声水平从 $\sigma=0.91$ 向下采样;这个起点与推理一致,因为推理时放大后的草稿会被重新加噪到 $\sigma_0=0.909$。实际推理前,训练得到的细化 LoRA 会与一个社区蒸馏 LoRA 合并。
SoL-Refiner 规划了三个阶段:高分辨率持续训练、使用 ReFL 的强化学习后训练,以及蒸馏为一步模型的 DMD。Open-H3-Regenerate-2K 目前只使用第一阶段。ReFL 与 DMD 被明确标记为尚未启用。这个边界对理解结果很重要:三步模型不是完整 SoL-Refiner 路线的最终形态。
| 训练要素 | Open-H3-Regenerate-2K 设置 |
|---|---|
| 可训练部分 | 只训练细化 LoRA,H3 Transformer 与 VAE 冻结 |
| 高质量训练尺寸 | 1280 x 704 或 2560 x 1440 |
| 条件构造 | 抗锯齿双线性下采样与上采样,倍率为 8 至 64 |
| 训练目标 | 从 $\sigma=0.91$ 向下的流匹配速度损失 |
| 细化 LoRA | 秩 384,使用 5,000 步 EMA |
| 推理时合并的 LoRA | 细化 LoRA、LightX2V FL2VA Turbo、LMS Sharp |
| 使用的 SoL-Refiner 阶段 | 仅第一阶段;尚未使用 ReFL 与 DMD |
对连续潜变量 $z_0$、噪声 $\epsilon\sim\mathcal{N}(0,I)$ 与噪声水平 $\sigma$,流匹配的含噪样本和目标为
$$ z_\sigma=(1-\sigma)z_0+\sigma\epsilon, \qquad v_\mathrm{target}=\epsilon-z_0. $$细化器学习一个受放大草稿和文本上下文 $c$ 约束的速度场 $v_\theta(z_\sigma,\sigma,c)$。用退化输入训练,使它预测回到真实高分辨率潜在表示的方向,而不是仅仅重建低分辨率像素。
为什么在潜空间里放大
细化器在目标网格上工作,因此草稿必须先到达输出尺寸。如果在像素空间放大,就会产生一次昂贵的 VAE 往返:解码每个低分辨率帧、放大到 2K 或 4K,再逐帧编码。到了这个尺寸,视频仅仅通过 VAE 就会占据大量时延。
H3-Latent-Upscaler 绕开了这次往返。它使用学习到的三维卷积网络,直接把草稿潜变量映射到更大的空间网格,同时保持通道数与时间长度不变。在 2K 路径中,作者报告的变换为
$$ z_{\mathrm{draft}}\in\mathbb{R}^{37\times 24\times 36\times 64} \longrightarrow z_{\mathrm{up}}\in\mathbb{R}^{37\times 24\times 90\times 160}, $$按项目使用的维度顺序,它们分别对应帧、通道、高度与宽度。4K 路径会把同一个学习得到的放大器调用两次。随后,细化器在放大后的分辨率上执行全部三次去噪,因此细节确实是在最终网格上生成的。
从数十步压缩到三步
速度来自草稿先验与蒸馏采样路径的组合。LightX2V 的 FL2VA Turbo 是一个让 H3 从数十步生成降到四步的 LoRA。Open-H3-Regenerate-2K 把 Turbo、社区 LMS Sharp 适配器与自己的细化 LoRA 合并。与从纯噪声开始的四步生成不同,细化从一份已经包含布局、颜色与运动的草稿出发。
放大后的潜变量在 $\sigma_0=0.909$ 处被部分重新加噪。给定标准高斯噪声 $\epsilon$,
$$ z_{\sigma_0}=(1-\sigma_0)z_{\mathrm{up}}+\sigma_0\epsilon. $$随后执行三次 Euler 更新,噪声计划为
$$ 0.909\longrightarrow0.857\longrightarrow0.667\longrightarrow0, $$ $$ z_{k+1}=z_k+(\sigma_{k+1}-\sigma_k)\, v_\theta(z_k,\sigma_k,c). $$推理中关闭 classifier-free guidance,因此每一步只在目标分辨率调用一次 Transformer,而不是分别运行条件与无条件分支。草稿已经解决了“画面里有什么”的问题,全分辨率模型只需把有限步骤用于细节和连贯性。
3.9 倍加速来自哪里
作者在单张 B200 上测量一条完整路径:从 1344 x 768 的 H3 潜变量开始,经过潜变量放大、三次细化与 VAE 解码,得到一段 5 秒 2K 视频。草稿生成、模型加载、文本编码与 MP4 写入都不计入。同一套热启动配置在稠密 BF16 注意力与原始 VAE 下耗时 87.26 秒,在 SoL-Engine 与更快的 StreamRender-H3 解码器下耗时 22.45 秒,比例为 3.9 倍。
| 推理配置 | 5 秒 2K 视频耗时 | 累计加速 | 主要变化 |
|---|---|---|---|
| 稠密注意力、BF16、原始 VAE | 87.26 秒 | 1.0 倍 | 细化路径基线 |
| 无损内核 | 81.38 秒 | 1.1 倍 | 跨步 cuDNN 与 torch.compile |
| Sol-Attn | 41.38 秒 | 2.1 倍 | 稀疏注意力,节省 39.99 秒 |
| MXFP8 线性层 | 38.12 秒 | 2.3 倍 | FP8 GEMM,每个阶段重新量化 |
| 融合 SwiGLU 与 MXFP8 | 37.85 秒 | 2.3 倍 | 单次激活量化 |
| CUDA graphs | 35.87 秒 | 2.4 倍 | 每个细化步骤捕获一张计算图 |
| 24 层快速 H3 VAE 解码器 | 22.45 秒 | 3.9 倍 | 从 36 层 VAE 蒸馏得到的非因果解码器 |
稀疏注意力是单项收益最大的优化,减少 39.99 秒。把原始 36 层 VAE 解码器换成 24 层 StreamRender-H3 后,解码从 14.99 秒降到 1.58 秒。无损内核、带融合 SwiGLU 量化器的 MXFP8 线性层与逐步骤 CUDA graphs 共同贡献剩余收益。
| 阶段 | 基线 | SoL-Engine 与快速解码器 |
|---|---|---|
| 细化:2560 x 1440 下三步 | 71.27 秒 | 19.75 秒 |
| VAE 解码:2560 x 1440 下 121 帧 | 14.99 秒 | 1.58 秒 |
| 潜变量放大:768P 到 2K | 1.01 秒 | 1.05 秒 |
| 总计 | 87.26 秒 | 22.45 秒 |
不能把这个数字与项目页上另外提到的 5.0 倍混为一谈。3.9 倍比较的是同一套开放流水线的两种配置,潜变量输入和 2K 目标都保持一致。5.0 倍则是作者在单张 B200 上按服务比较口径,把优化后的开放系统与官方 API 对照。两者回答的是不同问题,应当分别保留。
基准结果:质量提升,但仍限于作者测试集
定量比较使用继承自 SoL-Refiner 的 RefinerBench-150,共 150 段视频,覆盖日常场景、体育与舞蹈、动物、车辆、风景、人像与快速镜头运动。两套系统接收相同输入并输出 2560 x 1440。以下数字全部由 Open-H3-Regenerate-2K 作者报告,本文没有进行独立复现。
VBench
VBench 在零到一范围内评测六个维度。与 SoL-Refiner 一致,这里的平均值是六项分数的未加权平均,而不是某个排行榜的特定汇总口径。主体一致性衡量身份随时间保持,背景一致性衡量场景稳定,运动平滑度与动态程度描述动作,美学质量与成像质量评价单帧外观。
| VBench 维度 | 官方 H3-Regenerate-2K | Open-H3-Regenerate-2K | 差值 |
|---|---|---|---|
| 六项未加权平均 | 0.802 | 0.814 | +0.012 |
| 主体一致性 | 0.918 | 0.924 | +0.006 |
| 背景一致性 | 0.950 | 0.950 | 0.000 |
| 运动平滑度 | 0.984 | 0.981 | -0.003 |
| 动态程度 | 0.765 | 0.752 | -0.013 |
| 美学质量 | 0.569 | 0.604 | +0.035 |
| 成像质量 | 0.629 | 0.676 | +0.047 |
开放模型在美学质量、成像质量与主体一致性上更高,背景一致性持平,官方 API 则在运动平滑度与动态程度上略有领先。用简洁形式表示,作者报告的平均值为
$$ \mathrm{VBench}_{\mathrm{avg}} =\frac{1}{6}\sum_{j=1}^{6}s_j, \qquad 0.814 >\;0.802. $$这不是全面胜出,而分数结构也能说明问题。最大提升出现在单帧美学与技术质量,这与使用真实高分辨率视频对训练目标相一致。运动相关分数基本持平,并出现 0.003 与 0.013 的小幅下降。一个从草稿出发的三步细化模型可以提升细节,却不必然提升动态内容,甚至可能轻微削弱它。
UniPercept
UniPercept 从三个维度以零到一百分评价感知质量:美学(IAA)、技术图像质量(IQA)以及结构与纹理(ISTA)。总分是三个维度的平均。
| UniPercept 维度 | 官方 H3-Regenerate-2K | Open-H3-Regenerate-2K | 差值 |
|---|---|---|---|
| 平均 | 53.4 | 60.0 | +6.6 |
| 美学(IAA) | 59.1 | 67.3 | +8.2 |
| 质量(IQA) | 59.5 | 67.8 | +8.3 |
| 结构与纹理(ISTA) | 41.6 | 44.8 | +3.2 |
开放模型在三个维度上都更高:美学与图像质量约提升八分,结构与纹理提升三分多。这个结果支持作者的说法:细化器确实带来有用的高频结构,而不只是改变全局色彩。但它仍然只覆盖这套基准与两套系统在 2K 下的表现。
盲测用户偏好
用户研究包含 50 个案例,其中 25 个来自 RefinerBench-150,25 个来自主要发布在 X 上的在线提示。每次试验先展示低分辨率输入作为参考,再以随机 A/B 顺序播放两个 2560 x 1440 输出。参与者综合考虑清晰度、细节、自然度、伪影与时间稳定性,选择更好的一份。每次会话覆盖十个案例,20 次完成的会话共产生 200 个判断。
| 系统 | 被选中的判断数 | 占比 |
|---|---|---|
| Open-H3-Regenerate-2K | 174 / 200 | 87% |
| 官方 H3-Regenerate-2K | 26 / 200 | 13% |
偏好差距很大,但解读时仍要同时看样本规模与构成。作者报告的是 20 次完成的会话,而不是广泛的用户人口样本;任务也是对基准案例和在线提示做二选一。研究衡量的是视觉结果偏好,没有测试可控性、事实一致性、长视频编辑或生产流水线中的下游使用。
证据支持什么,什么仍然开放
第一,项目展示了一条绕过闭源细化服务的具体路线。冻结的 H3 模型加上小型细化器、开放潜变量放大器与优化推理,能够接受多种草稿来源,从 768P 生成到 4K,并不拼接处理较长视频。即使暂时不看基准分数,这本身就是一项有意义的系统工作。
第二,结果支持 RefinerBench-150 上的有限质量主张:作者报告的开放配置在多个感知与图像质量指标上高于官方 API,也赢下作者组织的盲测。它们不能证明模型在所有情况下都更好。运动动态、该基准之外的时序伪影、非日常领域,以及其他输出尺寸下的人类评价,仍是独立问题。
第三,这一模型明确是 SoL-Refiner 路线的中间版本。它只使用第一阶段的高分辨率持续训练,尚未包含 ReFL 强化学习后训练与 DMD 一步蒸馏。未来版本可能在质量与速度上同时不同;当前三步结果不能描述成整套方法的一步终点。
第四,速度数字都来自热启动、分阶段且有明确边界的测量。3.9 倍收益覆盖潜变量放大、三次细化与 VAE 解码,不包含草稿生成、文本编码、模型加载和 MP4 写入。与官方服务比较得到的 5.0 倍也有独立条件,必须保留。这样的拆分很重要,因为高分辨率视频的端到端时延往往同时受解码、数据搬运和扩散 Transformer 影响。
对机器人与物理 AI 团队而言,实用价值在基础设施层。用于训练数据、场景检查、演示或展示的生成视频,可以先以低成本草稿产生,只在分布要求或发布要求需要全分辨率时进行细化。15 秒单遍路径减少了逐段处理带来的记录管理和接缝风险。它不会因此成为机器人策略、物理模拟器,也不能证明合成视频正确保留了接触与物体状态;这些性质仍要针对任务单独验证。
Open-H3-Regenerate-2K 更重要的意义在架构,而不在宣传口径。它说明一个闭源高分辨率阶段可以被拆成可复用组件:冻结基座、潜空间放大、小型适配训练、短去噪计划与系统级加速。这种拆解让模型更容易检查、部署到本地硬件,并扩展到不同草稿来源与输出尺寸。
作者与来源说明
Open-H3-Regenerate-2K 的作者是 Sensen Gao*、Haozhe Liu*、Yitong Li、Haopeng Li、Tian Ye、Jia-Wang Bian、Song Han 与 Enze Xie,星号表示共同第一作者。项目由 NVIDIA 与 SoL-Engine 研究团队发布。基准数值、速度测量、定性示例与用户研究均由作者报告,不是 RobotWorld 的独立评测。
原文来源:Open-H3-Regenerate-2K: High-Resolution Video Refinement with Few-Step Diffusion,NVIDIA / SoL-Engine,2026 年 10 月。
原文来源:NVIDIA SoL-Enginehttps://nvlabs.github.io/Sana/Open-H3-Regenerate-2K/