MemCurrent:为生产级 Agent 设计持久记忆
Databricks 的 MemCurrent 用情景记忆+蒸馏记忆双存储、插件/工具/离线 dreaming 三接入:内部基准通过率 22.3%→68.4%,token 省 31%、快 26%;开源基准媲美全上下文而输入 token 少约 12 倍。
质量与效率,本该是一对矛盾
AI 工具让「vibe coding」出一个 agent 变得很容易。但要在生产环境里构建并维护一个企业级 agent,仍然难得多。开发者常常被迫在质量(给出好答案,尤其是长尾任务上的好答案)与效率(把规模和时延下的成本压住)之间做取舍。很多技术往往在一个维度上带来收益,却在另一个维度上付出代价。
记忆是一条能同时改善两者的路径:它帮助 agent 把有用的上下文跨任务带下去,比如用户偏好、此前的纠正、指标口径、成功的工作流。原则上,这能提高准确率、减少重复犯错、避免不必要的重复探索。但历史更多并不等于记忆更好:把每一次过往交互都塞进去代价高昂,还会引入过时的、互相冲突的或无关的上下文。真正的核心难题是:决定保留什么、如何维护它、如何度量它有没有用。
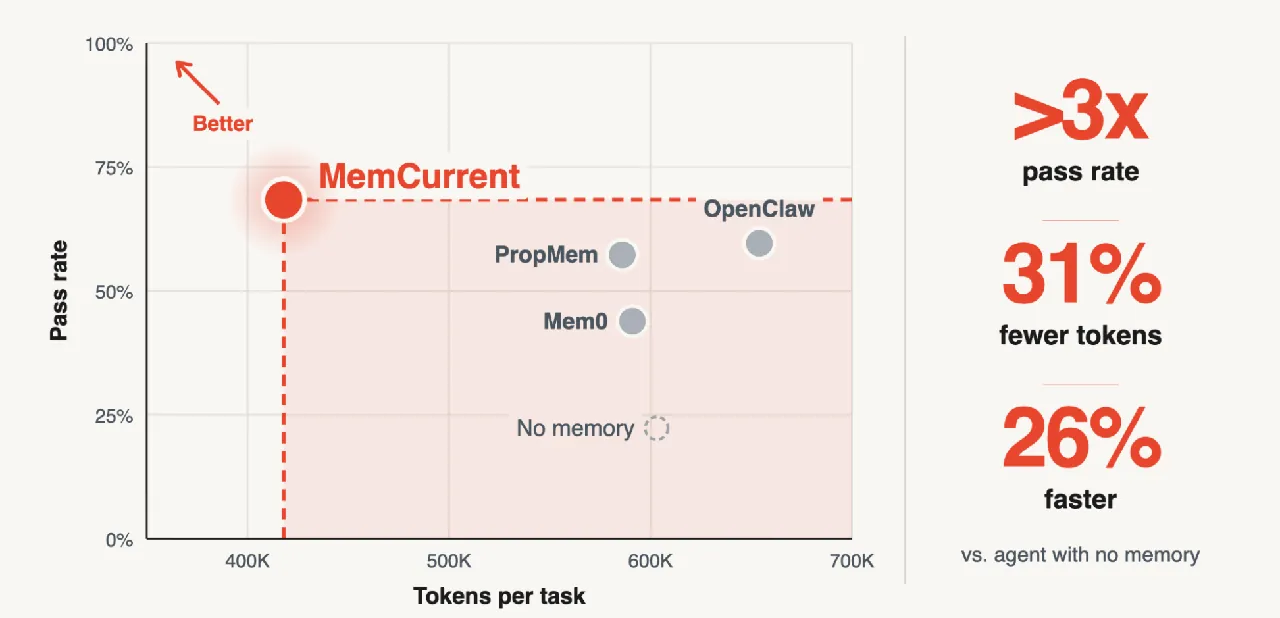
本文介绍 MemCurrent——一套面向生产级 agent 的持久记忆架构,目前已支撑 Databricks 的 Agent Bricks Memory 与 Genie。agent 在工作过程中读写记忆,另有一条离线「dreaming(做梦)」流水线对记忆做整合,使其保持一致与新鲜。在我们基于真实企业任务构建的内部基准上,MemCurrent 把 agent 的通过率提升到无记忆时的 3 倍,同时 token 用量减少 31%、运行速度快 26%。
记忆是如何设计的
把记忆接入 agent 有三种方式。作为插件(plugin)(如此前的 MemAlign 与 Memory Scaling 工作),记忆在会话中的固定时点被自动读写;作为工具(tool),由 agent 自己决定读什么、写什么、何时读写;作为离线流水线(pipeline),记忆在后台按调度或触发更新,供后续会话使用。三者各有取舍:
| 记忆作为…… | 触发方 | 计算时机 | 优点 | 缺点 |
|---|---|---|---|---|
| 插件 | 自动 | 在线 |
|
|
| 工具 | agent | 在线 |
|
|
| 流水线 | 调度或触发 | 离线 |
|
|
MemCurrent 三种都用,各用在最合适的地方。
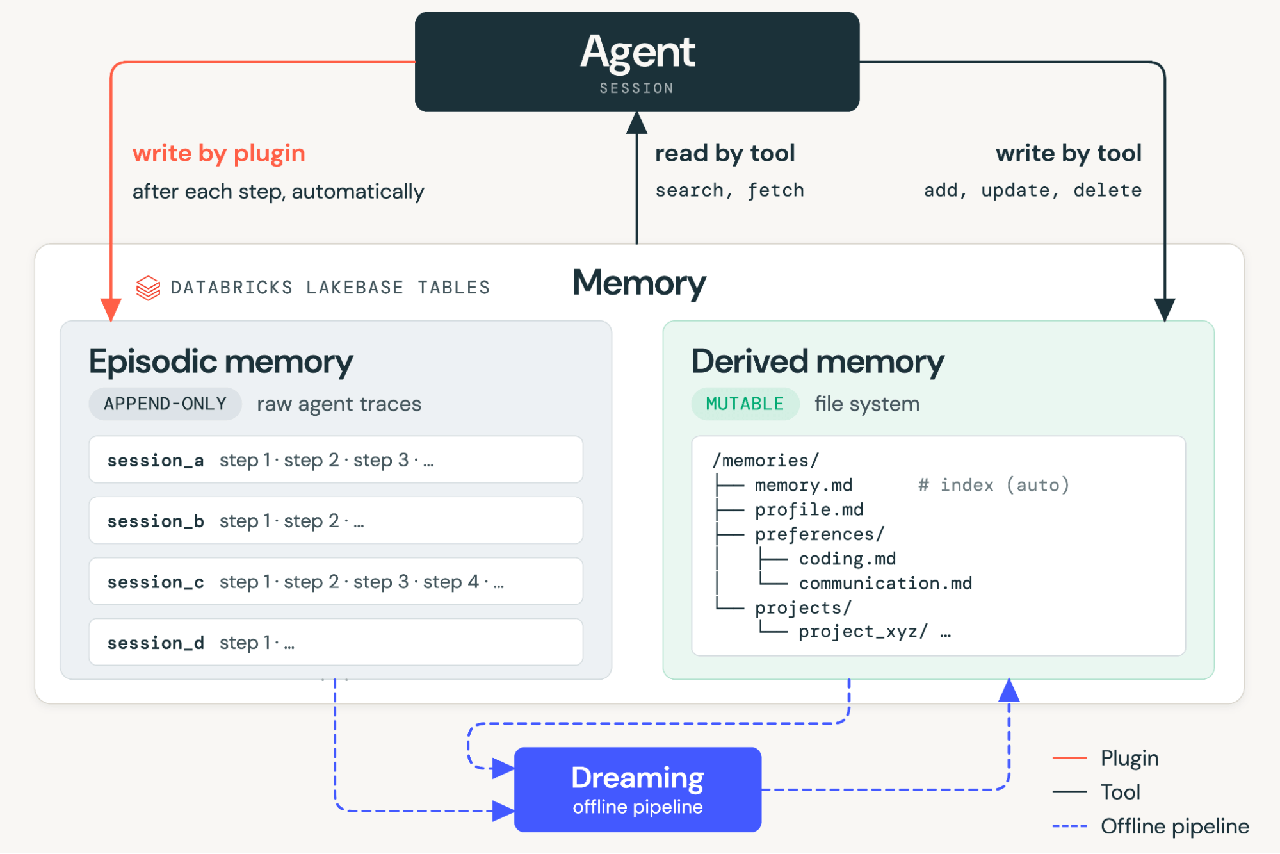
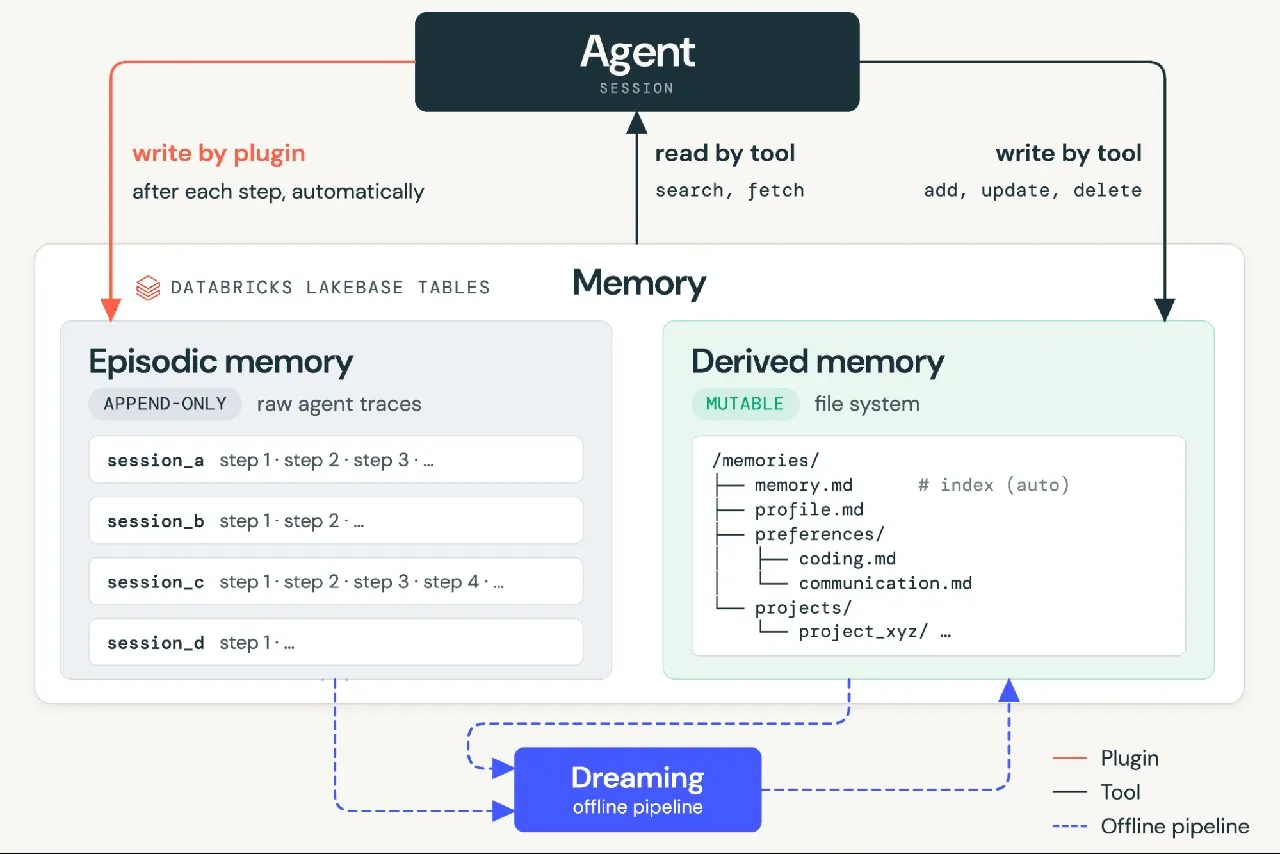
MemCurrent 有两类记忆:情景记忆(episodic memory),保存原始会话轨迹;蒸馏记忆(derived memory),保存从这些轨迹中蒸馏出的经验,以文件形式存放在一个结构化知识库里。顶层有一份自动生成的 memory.md 索引,描述文件结构以及每个文件里有什么。
两类记忆都存放在一个生产级数据库中,能扩展到大量用户并保持低时延响应。情景记忆是只追加的(append-only):会话运行过程中由插件逐步记录。蒸馏记忆是一张模拟层级文件系统的可变表,写入有两条路径:agent 工具(add_memory、update_memory、delete_memory)处理显式请求,比如「永远不要在 /tmp 目录下写脚本」;离线 dreaming 流水线负责其余部分,把每次新会话中隐含的经验蒸馏进相应文件。它还会清理整个存储:拆分过大的文件、合并重复项、消解冲突。
读取是分层的。会话开始时,插件注入记忆索引,让 agent 在动手之前就知道「自己知道什么」。会话过程中,agent 有两个跨两类记忆通用的工具:search_memory 针对一个查询返回最匹配的若干条(过往轨迹中的某一步,或记忆文件中的某一行);fetch_memory 按标识符(会话 ID 或文件路径)返回完整条目。
记忆是如何评测的
基准
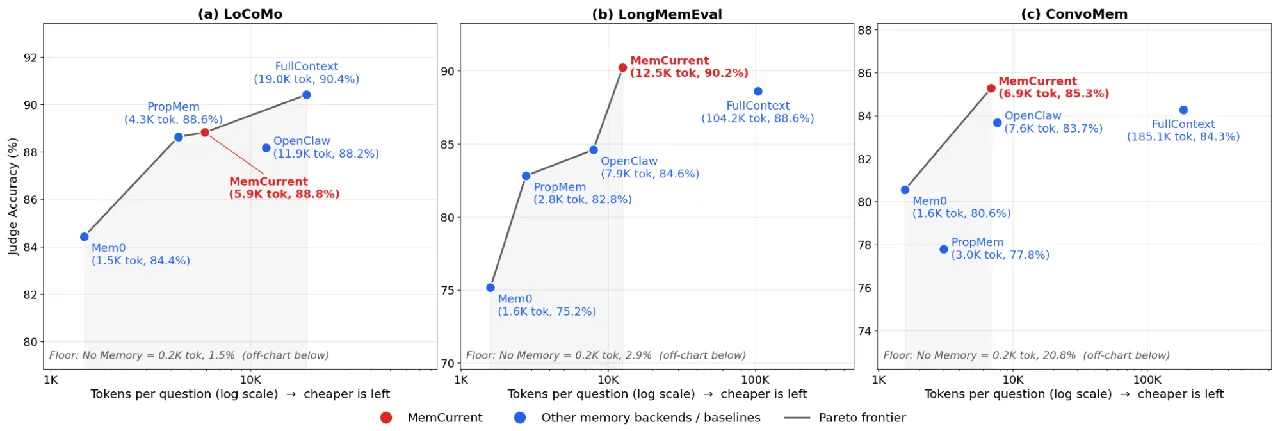
我们先用了三个流行的开源基准:LoCoMo、LongMemEval 与 ConvoMem。三者都测试 agent 能否回忆出开放式合成对话中早先陈述过的事实。
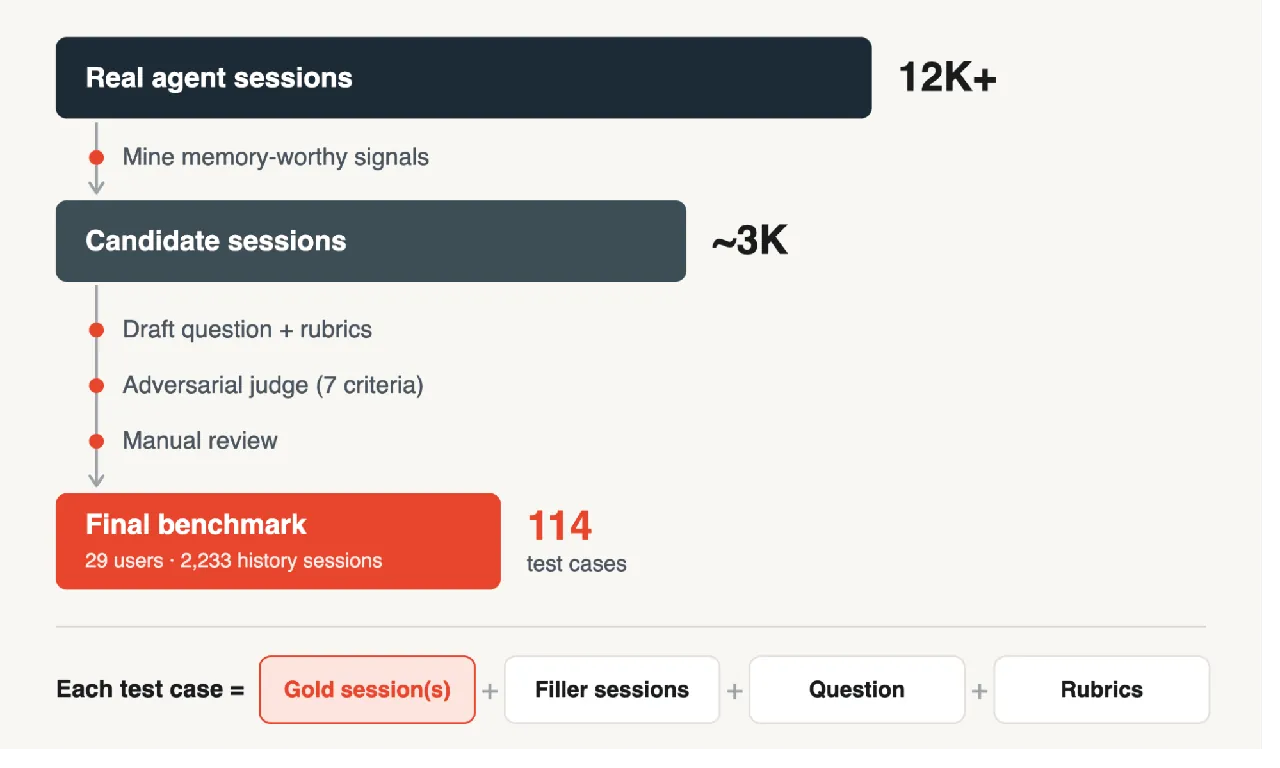
此外,我们用真实的 Genie 会话构建了一个内部记忆基准(Internal Memory Benchmark)——用户在其中就自己的数据提出各种问题。如图 3 所示,我们从 12K+ 会话出发,挖出 3K 条含有「值得记忆」信号的候选,为每条候选起草一个后续问题与评分准则;同一用户的其它会话作为测试用例的填充历史。随后一个对抗评审按 7 条准则检查每个测试用例,例如知识是否真实存在、是否特定于该用户、是否为回答所必需、是否自然、是否可验证。经过最后一轮人工复核,基准共有 114 个测试用例、29 个用户、2,233 条历史会话。
下面是一个例子:
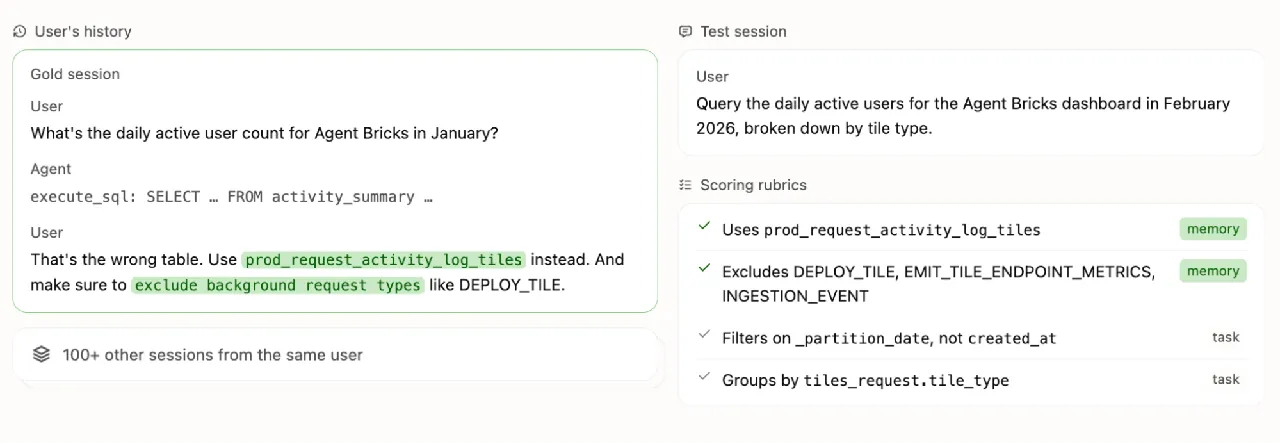
我们的基准与既有基准有三点不同:
- 企业领域。 既有基准是关于模拟人设生活的开放式闲聊;我们的基准来自数据工作空间中的真实工作,涉及表语义、指标口径、工作流等丰富的企业知识。
- 记忆喂的是行动,不是答案。 在过往对话里找到正确的字符串还不够;agent 必须把检索到的知识用起来,完成多步任务。
- 多样性。 测试用例覆盖 5 种记忆类型(profile、偏好、领域知识、项目、工作流)与 11 种场景(直接指令、变化或过时的事实、跨会话聚合、与记忆无关的问题等)的交叉组合。
结果
我们把 MemCurrent 与三个开源记忆后端——Mem0、PropMem、OpenClaw memory——在同一底层 LLM 下做对比。
开源基准。 我们为每个记忆后端配一个简单的问答 agent,用两套 agent harness(LangGraph 与 OpenAI Agents SDK)实现。同时跑两个基线:下限是无记忆,上限是全上下文(full context)——把每一条过往会话都塞进 agent 的上下文。在三个基准上,MemCurrent 在所有记忆后端中得分最高,并始终留在成本-准确率帕累托前沿上。平均来看,MemCurrent(88.1%)与全上下文(87.8%)持平,而每问题的输入 token 约少 12 倍(8.4K 对 103K)。在历史最长的两个基准上,它甚至超过全上下文——把所有东西都倒进 prompt,反而会把 agent 搞糊涂。
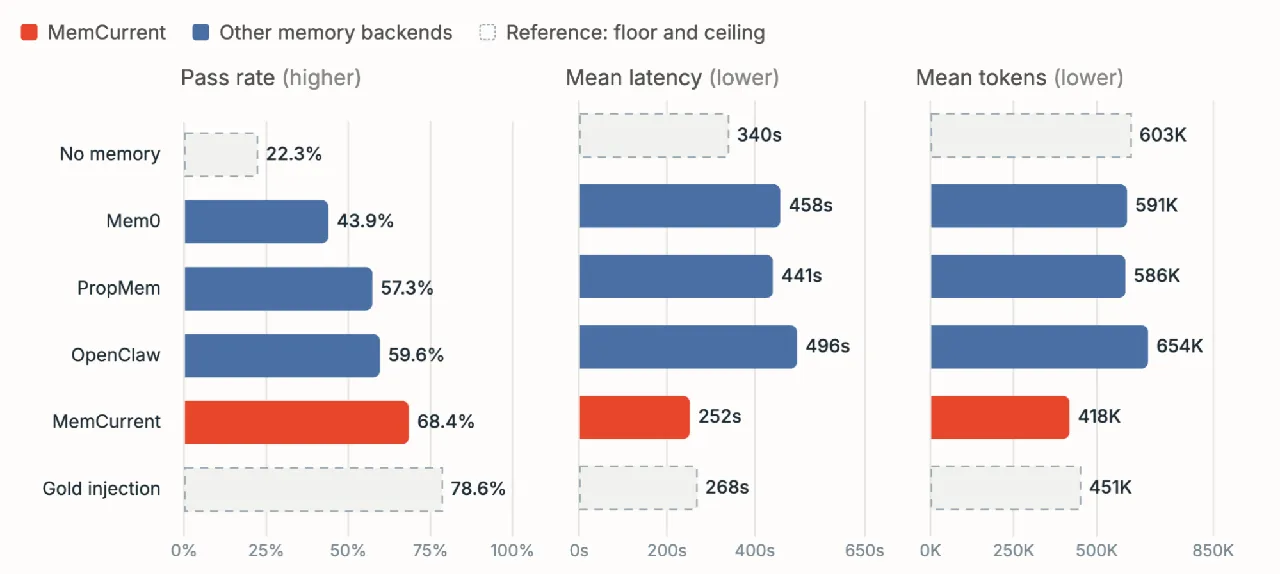
内部记忆基准。 在我们的基准上,差距进一步拉大。这里每个记忆后端都跑在我们内部的 Genie 里——也就是基准会话来源的同一个 agent。历史太长、放不进上下文,因此上限改为 gold injection:只把黄金记忆注入 agent 上下文。在所有记忆后端中,MemCurrent 通过率最高(68.4%)、时延最低(252s)、token 用量最少(418K),闭合了无记忆(22.3%)与 gold injection(78.6%)之间 80% 以上的差距。值得注意的是,Mem0 在前述开源基准上也曾位于前沿,但在这里只有 43.9%,且时延与成本更高。与无记忆相比,MemCurrent 把 agent 的通过率提升到 3 倍(22.3% → 68.4%),同时快 1.35 倍、便宜 1.44 倍。
MemCurrent 实战
除了基准数字,再看两个来自内部 Genie 会话的例子,看 MemCurrent 在实践中如何起作用。
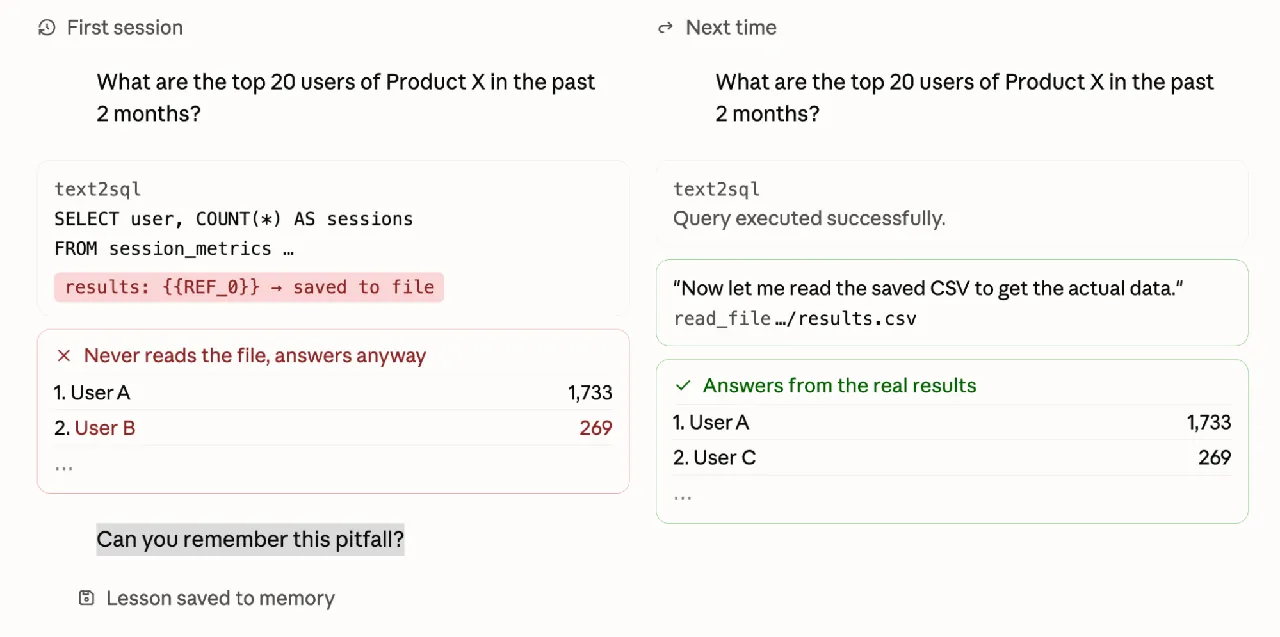
例 1:记忆拦住了一次偶发的幻觉错误。 图 7 中,用户让 agent 给出过去两个月 Product X 的 top 20 用户。agent 写出了正确的 SQL,却从未读取保存到文件里的真实执行结果,仍然自信地给出了一张内容是幻觉的表。用户反馈之后,agent 把这条教训写进记忆。下一次,查询一跑完,agent 先读结果再回答,返回了正确的表。一条记忆纠正,让一次偶发的失误没有变成习惯。
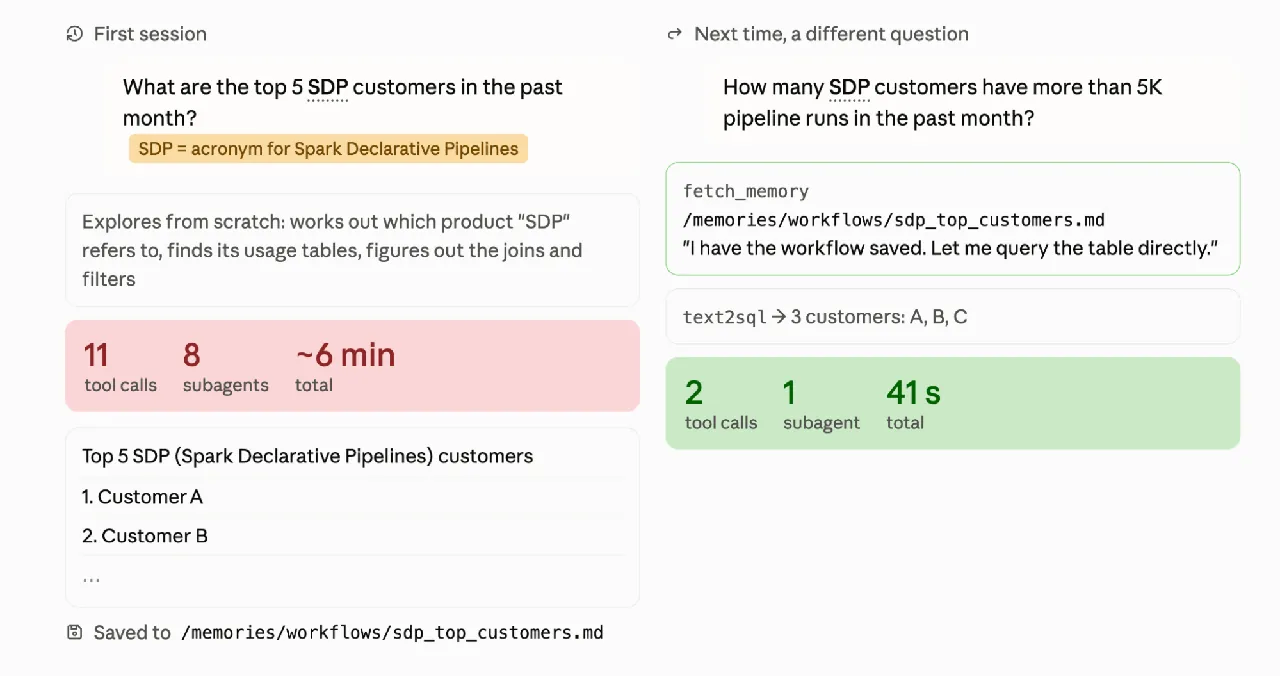
例 2:记忆在相关任务上省下计算。 图 8 中,用户问「top 5 SDP customers」。agent 必须从零搞清楚一切:「SDP」是什么缩写、哪些表存用量数据、如何 join 与过滤。这花了 11 次工具调用、8 个子 agent、将近六分钟。agent 把这些步骤存成记忆里的一个 workflow 文件,供相关任务复用。后来用户问了一个不同的问题:上个月 pipeline 运行次数超过 5K 的 SDP 客户有多少。借助这个 workflow,agent 用 2 次工具调用、1 个子 agent、41 秒就答了出来。问题是新的,但通向答案的路径不是——记忆让 agent 跳过了不必要的探索。
MemCurrent 为什么有效
为了搞清楚 MemCurrent 的优势来自哪里,我们在内部记忆基准上对两个设计选择做了消融:记忆类型与抽取策略。
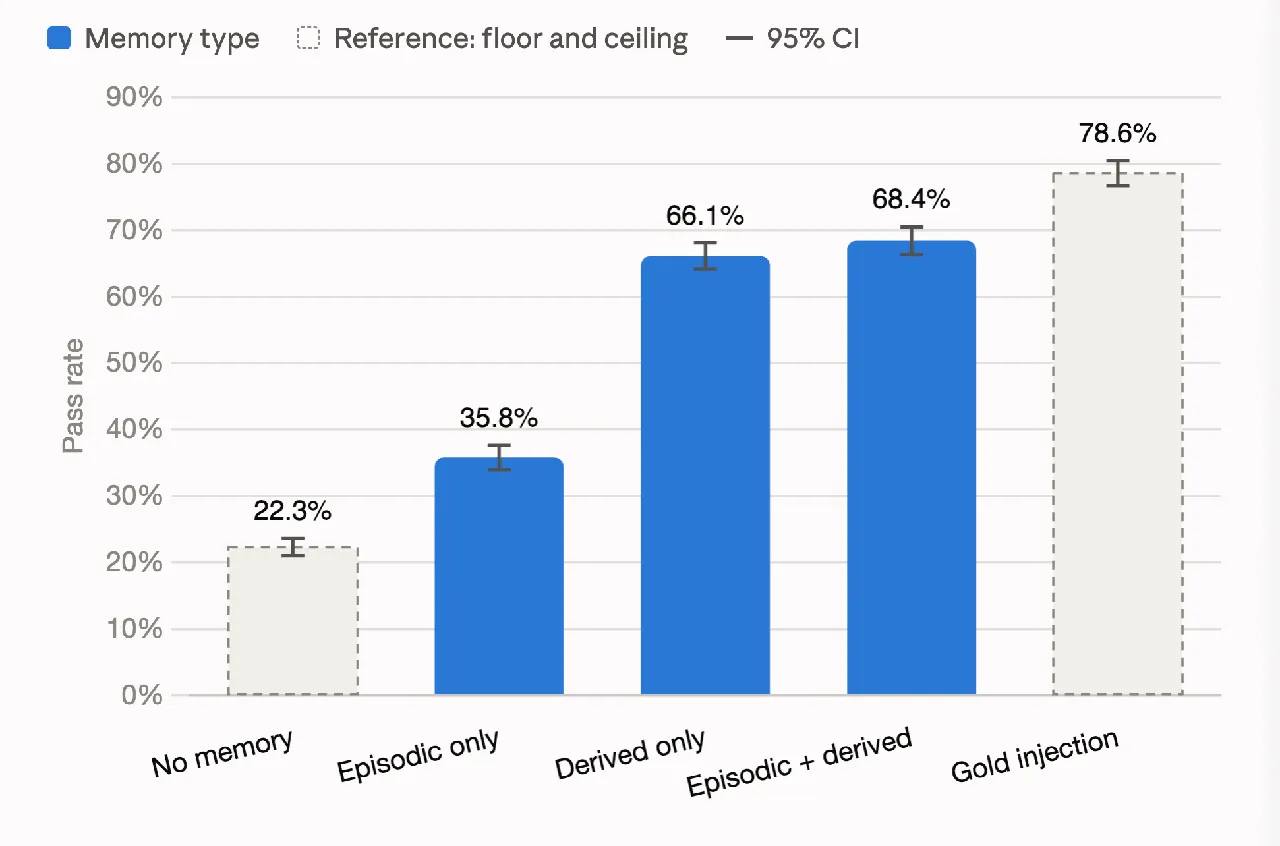
两类记忆都需要吗? 只用情景记忆有一定帮助:35.8%,高于无记忆的 22.3%。原始历史是有用的,但 agent 只在约三分之一的测试用例中去检索它——尽管一旦检索了,其中 60% 能通过。蒸馏记忆避开了这个问题:会话开始时注入的记忆索引告诉 agent「记忆里有什么、什么时候该去看」,把通过率抬到 66.1%。再叠上情景记忆得到最好的 68.4%。增益不大,但它说明原始轨迹能找回蒸馏丢掉的那些细节。
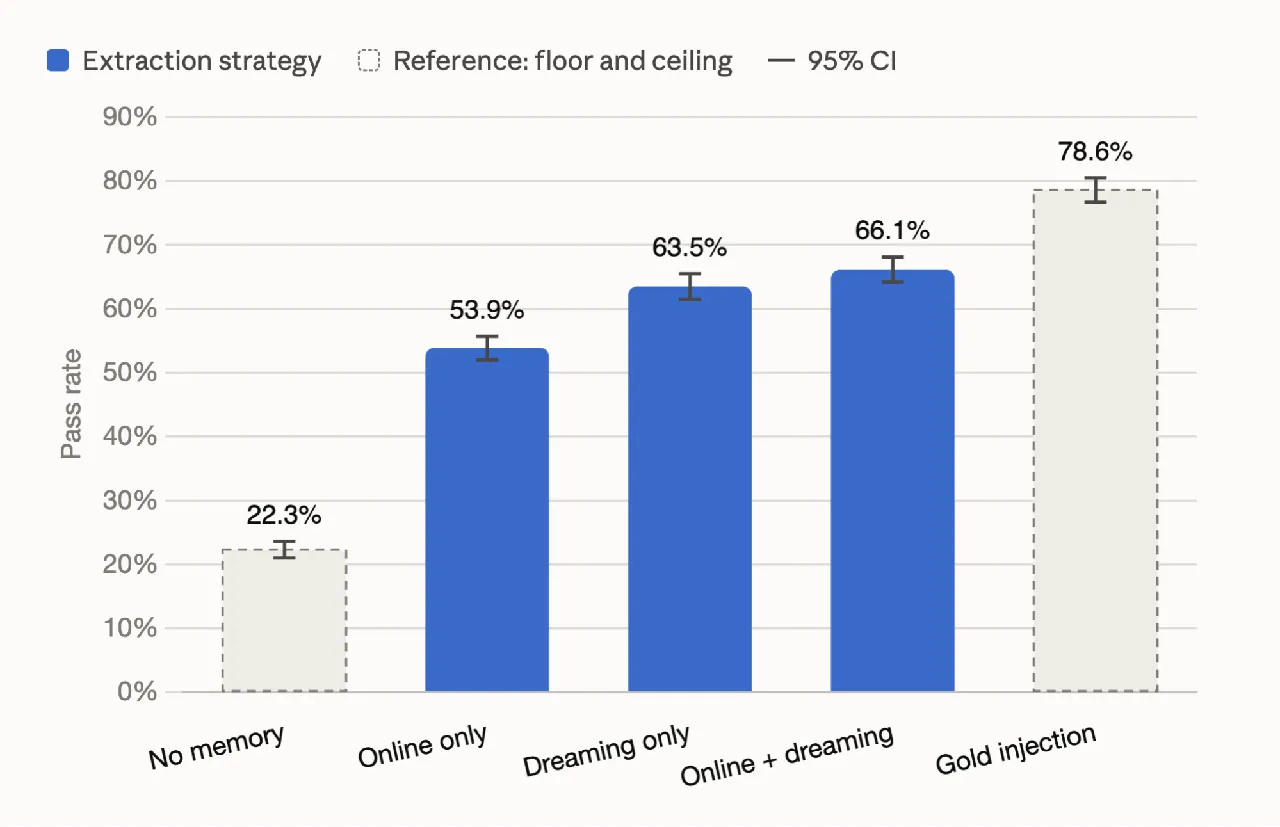
什么是好的记忆抽取策略? 如图 2 所示,抽取蒸馏记忆有两条通道:在线工具与离线 dreaming。单独看,离线 dreaming(63.5%)比在线工具(53.9%)高近 10 个点;两者组合得到最高的 66.1%。这支持一种分工:dreaming 负责后台的抽取与整合,在线工具让显式请求立即生效。
结论
记忆,是 agent 停止「从零开始」的方式。本文介绍了 MemCurrent:一套面向生产级 agent 的记忆架构,结合情景记忆与蒸馏记忆,配三种接入方式——插件自动记录与加载上下文、工具由 agent 按需调用、离线 dreaming 流水线在后台整合记忆。
在我们跑过的所有基准上,MemCurrent 同时改善了质量与效率——正是我们想要打破的那对取舍。在开源基准上,它以约 12 倍更少的输入 token 达到与全上下文持平的表现;在基于真实数据工作构建的内部记忆基准上,它把 agent 的通过率提升到无记忆时的 3 倍,同时更快、更省。
消融实验指出了价值来自哪里:蒸馏记忆承担了大部分工作,情景记忆以较小的增益补回蒸馏丢掉的细节;在线工具与离线 dreaming 的组合是最好的抽取策略——显式请求立即生效,dreaming 在后台蒸馏隐含经验并整合存储。
在数字之外,记忆提供了一份不绑定于某个 agent 或某个 LLM 的知识库。它可以跟着用户迁移到新的 agent 或新的 LLM,也可能成为组织内共享知识的种子——这是我们正在探索的下一个方向。
作者:Veronica Lyu, Wenhao Zhan, Sam Havens, Ziyi Yang, Jenny Sun, Qinxin Wang, Nihit Desai, Sirui Sun, Ankit Mathur, Jane Zhang, Yi Liu, Jialu Liu, Michael Bendersky, Matei Zaharia, Xing Chen。感谢 Jonathan Li, Rishabh Singh, Andy Zhang, Kenneth Choi, Will Tipton, Cassie Cao, Siddharth Murching, Sue Ann Hong, Pranav Sukumar, Neo Ni, Shanshan Zheng, Chung Wu 以及内部用户研究的参与者们在整个项目中的反馈与支持。
1 各记忆后端的时延相近(4-7 秒/问题),因为大多数问题单跳即可回答。
2 我们发现对既有基准而言,插件式记忆已经足够;再加工具的结果被严格支配,故省略。
来源:Databricks 官方博客《MemCurrent: Designing Persistent Memory for Production Agents》,2026 年 10 月 20 日。