HomeBody:一台会自己探索、记住、再动手的人形机器人
斯坦福 TML 的 HomeBody 把「VLM→VLA→控制器」中间那层学出来的 VLA 拆掉:GPT Astra 直接调用可组合技能库,配合机器人自己探索建出的数字孪生与持久空间记忆,在没见过的厨房里完成长时序收拾与取药。
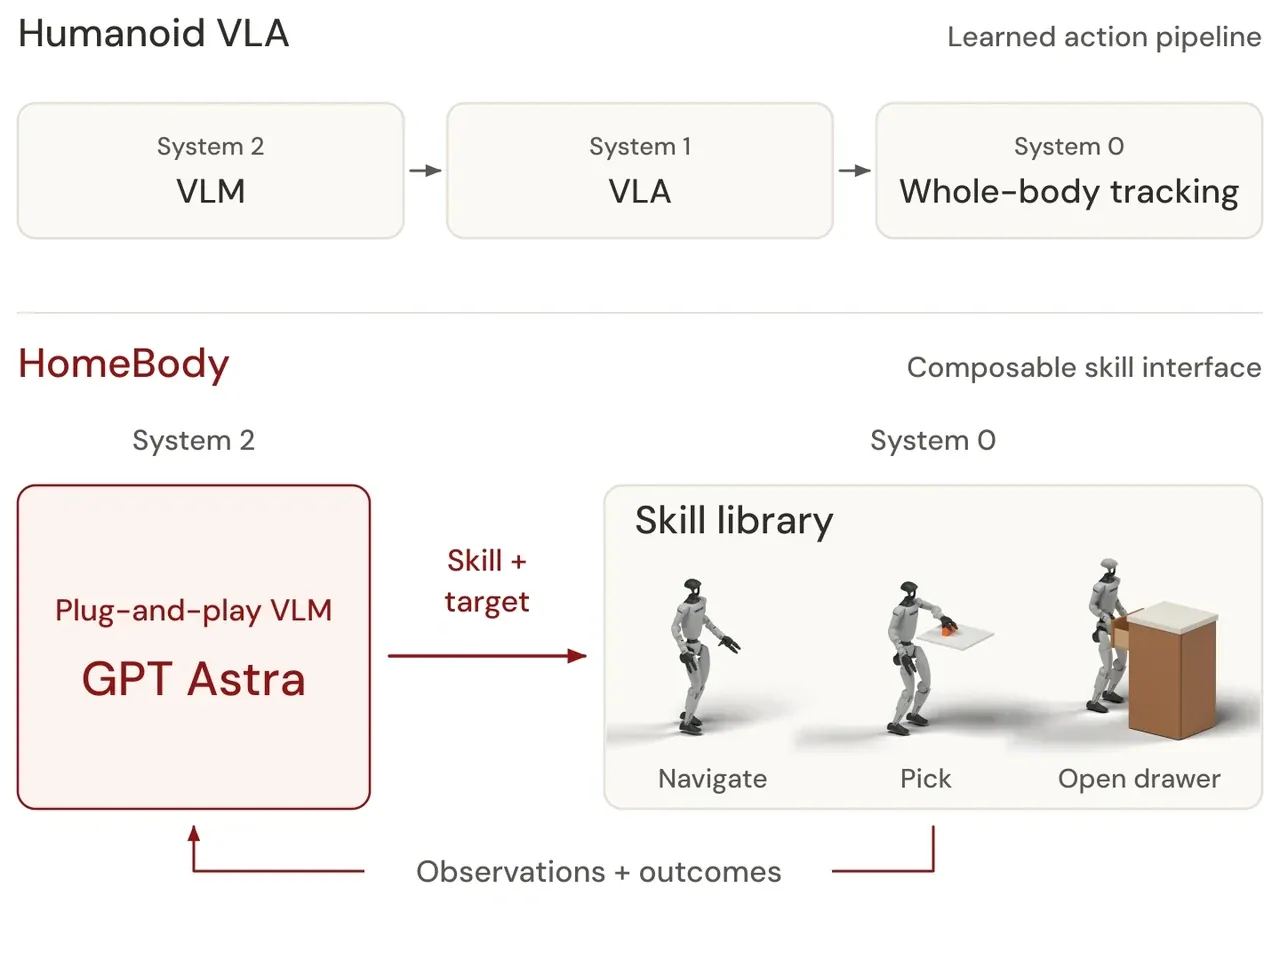
人形机器人自主性有一张常见配方:System 2 的 VLM 读视觉观测与指令,学出来的 System 1 VLA 把推理变成命令,System 0 的控制器执行协调运动。斯坦福 The Movement Lab(TML)的 HomeBody 问了一个更激进的问题:当 Astra 这样的前沿 VLM 越来越强,高层推理与机器人技能之间那层学出来的 VLA 还有必要吗?System 2 能否直接编排一座可复用的运动技能库?
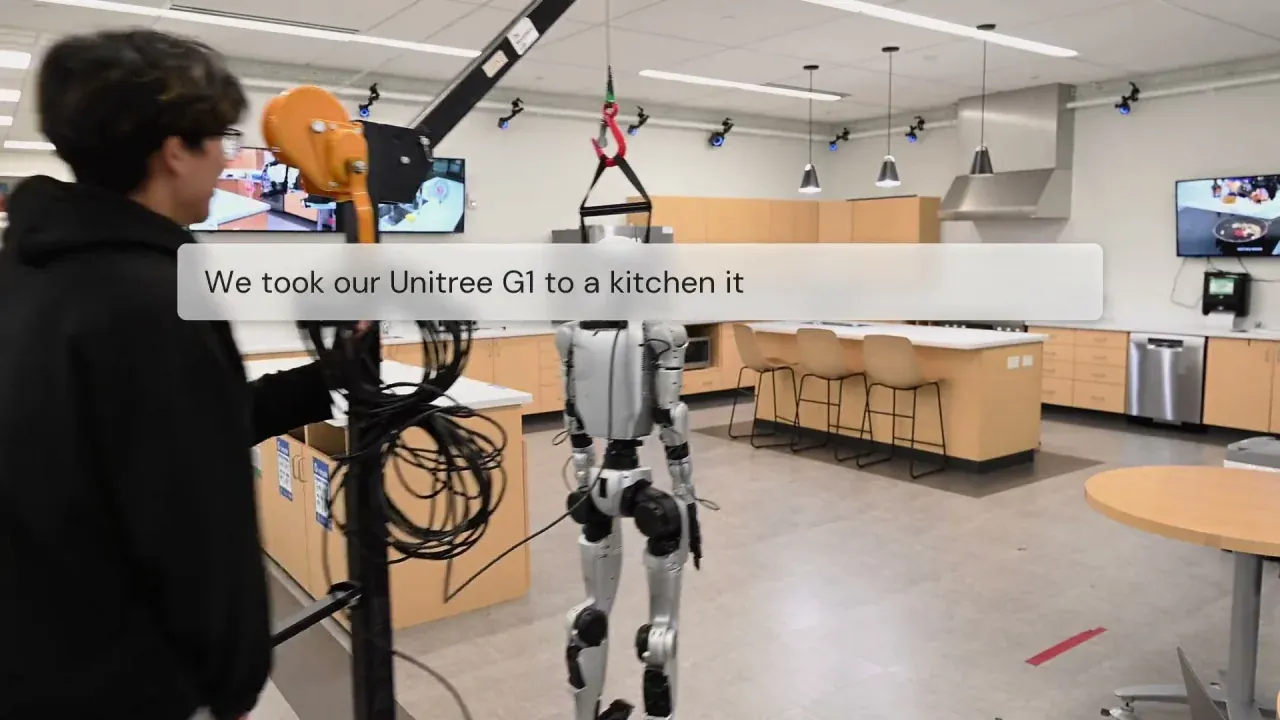
他们的答案是 HomeBody:给前沿 VLM 配上持久空间记忆与可组合的人形技能,去做长时序任务。在一间从未见过的厨房里,GPT Astra 指挥的 Unitree G1 把散落的咖啡袋收拢到中岛、把变质的牛奶与橙汁纸盒丢进垃圾桶;也能从一句含糊的「我忘带药了,帮我拿一下」里找到记忆中那个抽屉,取出药瓶递到人手上。没有针对这个环境的训练数据,也没有额外学任何策略。
01. 两条长时序演示:收拾厨房与取药
Clean up all of the coffee bags and put them in the middle, and throw away all of the milk and orange juice cartons that have gone bad.(把所有咖啡袋收拢放到中间,把变质的牛奶和橙汁纸盒都扔掉。)
收拾厨房意味着决定留什么、丢什么、把每件物体搬到哪里。HomeBody 把咖啡袋聚到中岛,把指定的纸盒丢弃,在一间房里协调一次又一次的往返、抓取与放置。它的视野每动一次就变一次,于是记忆与动作反馈共同负责记录「哪些已经完成、哪些还欠着」。
能力标签:多物体清理 · 任务排序 · 导航 + 操作
I forgot my medicine, can you get it for me? Also throw out the bad carton while you are at it.(我忘带药了,能帮我拿一下吗?顺便把坏掉的纸盒扔掉。)
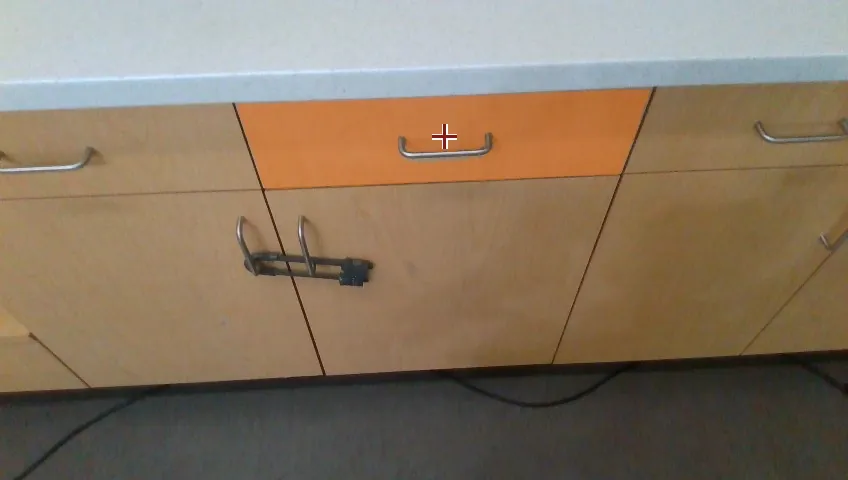
药一开始并不在视野里。HomeBody 用存下的关键帧定位那个抽屉,取出药、递到人手上,再顺手丢掉纸盒。跨房间行动时它用右手抓抽屉把手把抽屉拉开,再用左手丢纸盒——在两条手臂之间做选择,让它能够到身体两侧的目标。
能力标签:被遮挡物体 · 记忆检索 · 右手开抽屉 / 左手丢弃 · 左右手技能选择
02. 空间记忆:把看不见的地方变成可引用的地址
长时序 loco-manipulation 把人形带出自身视野所能展示的范围。要跨房间行动,它需要一个内部空间模型,把看得见的物体与记得的位置连起来,并帮助消解含糊的请求。这份上下文决定去哪里、对什么动手、如何编排走与抓的顺序。HomeBody 把这份空间记忆与可组合技能结合,而技能的执行反馈又让 VLM 在某次动作或转移失败时修正下一个决策。
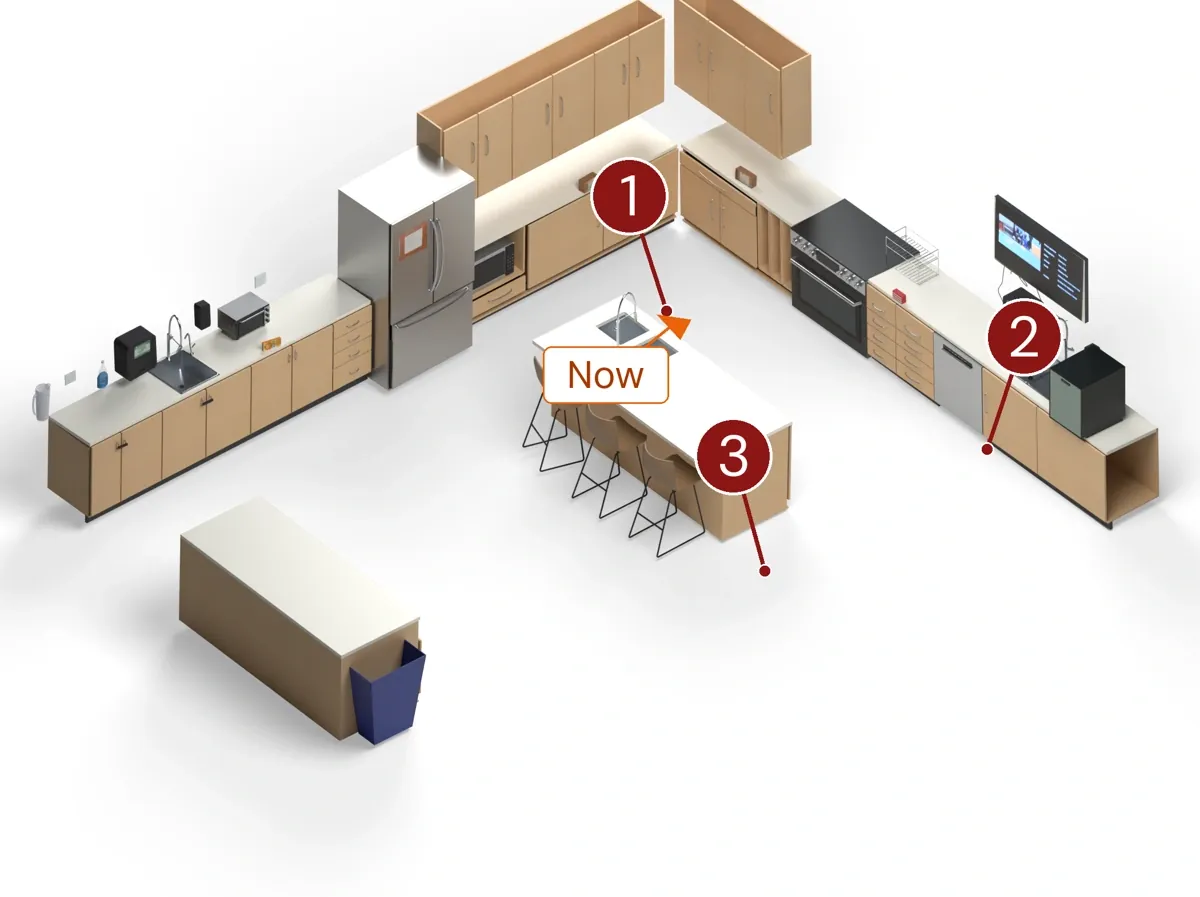
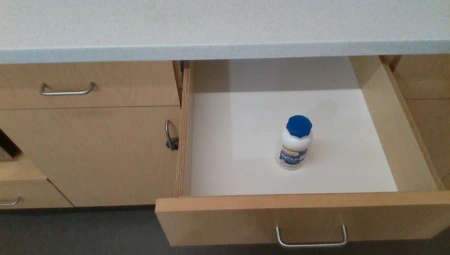
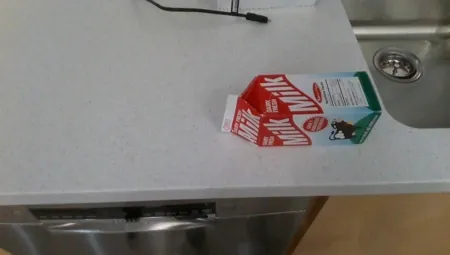
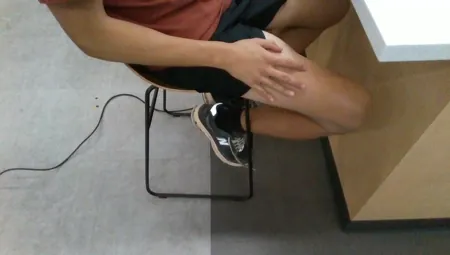
记忆的形态是「存下来的自观关键帧 + 随帧的描述性内容」,两者一起挂在 Super Odometry 与 ICP 对齐后的共享坐标系里。下面三帧分别登记了抽屉里的药瓶、水槽边台面上的纸盒、以及坐在中岛边等待递接的人。召回时它们与当前观测并列呈现,VLM 据此决定下一步。
03. 部署三步:探索、Real2Sim、给一个日常任务
Step 1 · 探索
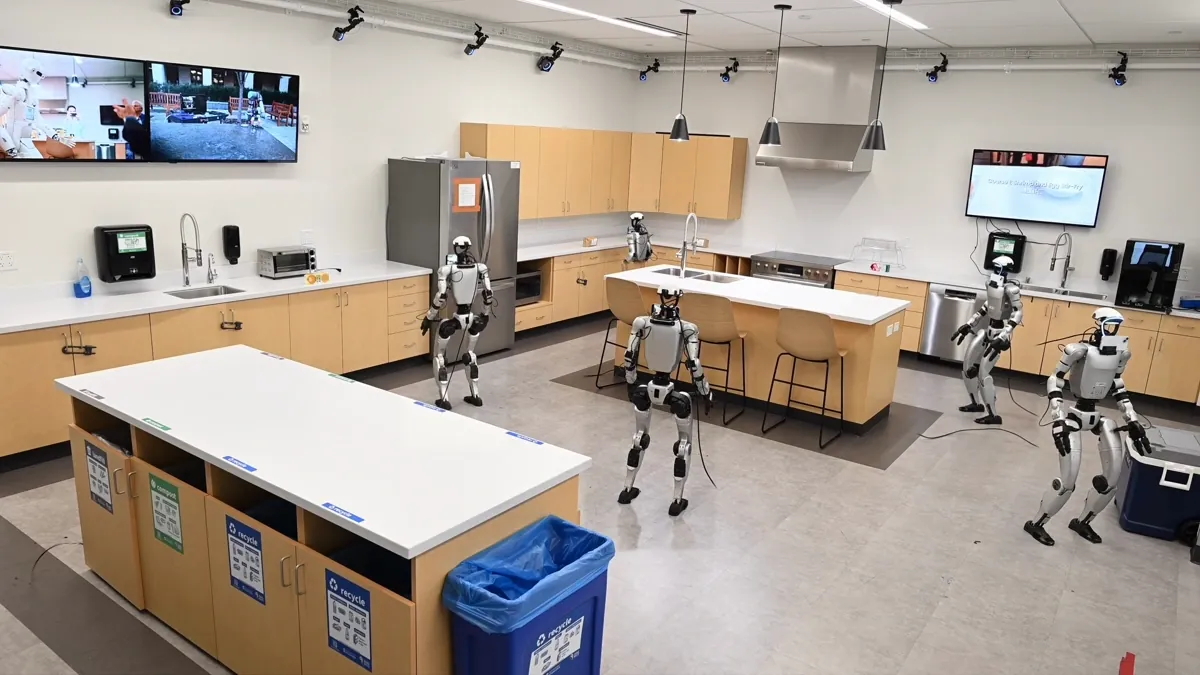
You are a kitchen robot, please explore the space!(你是一个厨房机器人,请探索这个空间!)
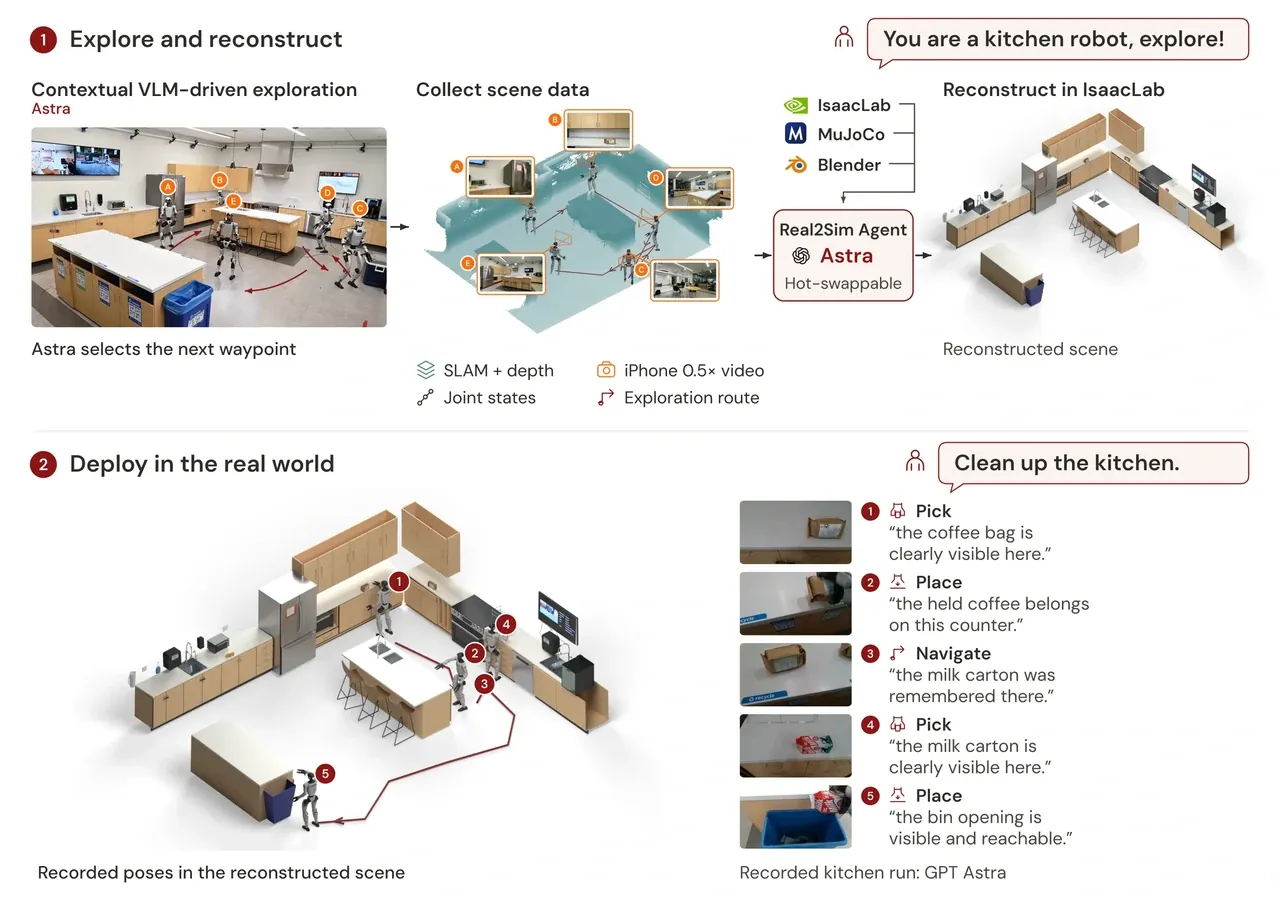
先告诉人形它的角色,再让它探索一间没见过的环境。HomeBody 收集 0.5× iPhone 视频、D435i 相机观测、带 SLAM 的 LiDAR 扫描、关节位姿,以及由 Astra 选出的航点。探索从人形自己的视角捕捉房间,把空间上下文落在它边走边看、边交互所见之物上;物体离开自身视野之后,这份上下文仍然保留。
Step 2 · Real2Sim
HomeBody 用 Astra 充当 Real2Sim agent,从人形自己采到的数据在 Isaac Sim 里建出数字孪生。这让它的观测落在一个世界的空间模型上,帮助高层 VLM 推理自身视野之外的位置。
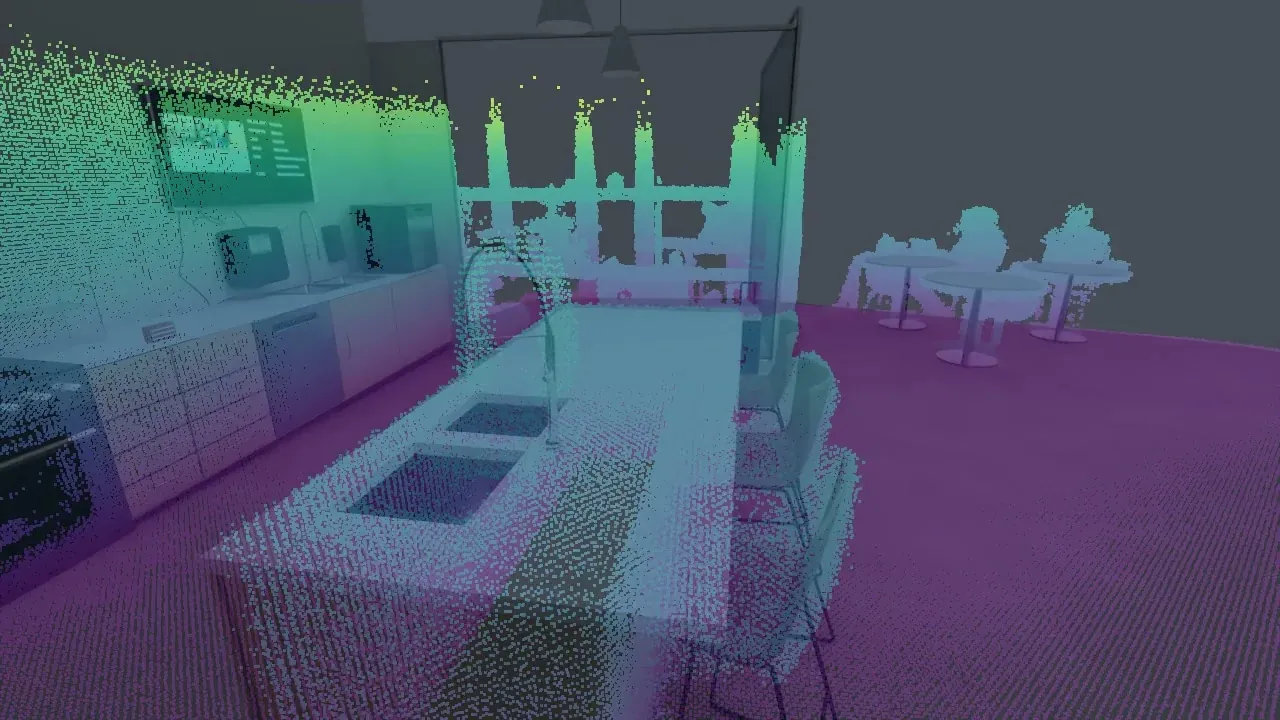
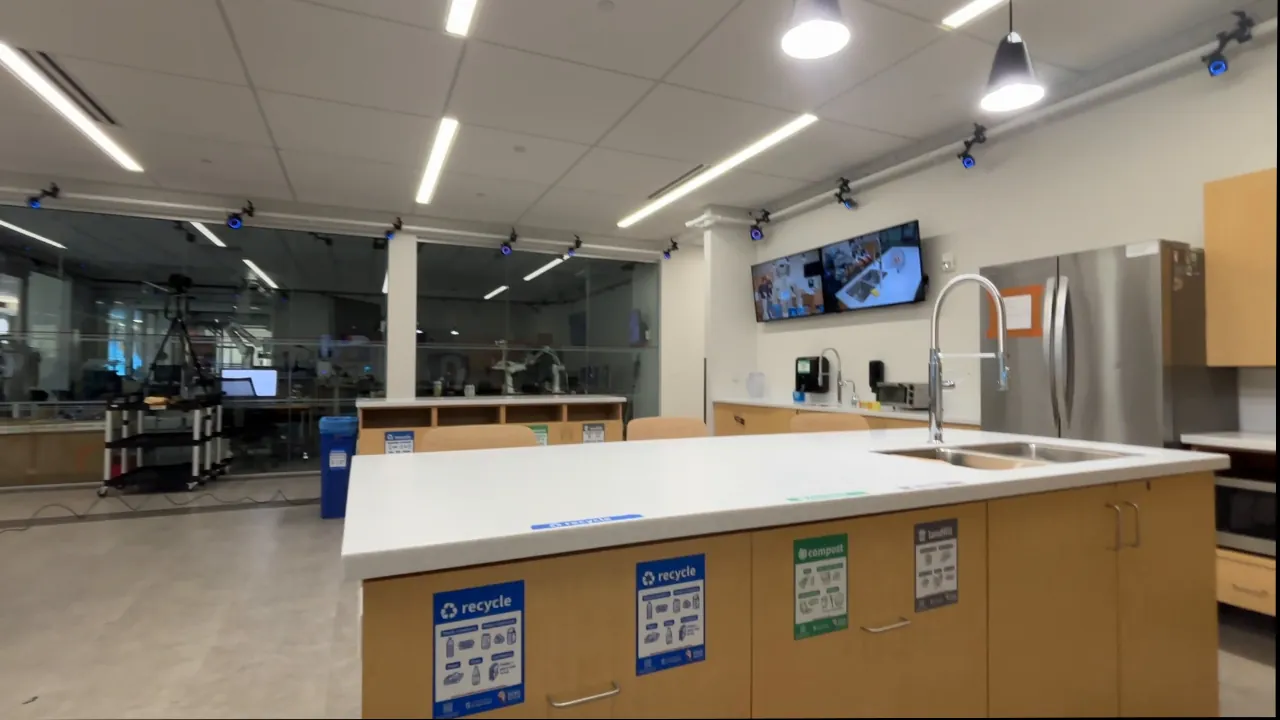
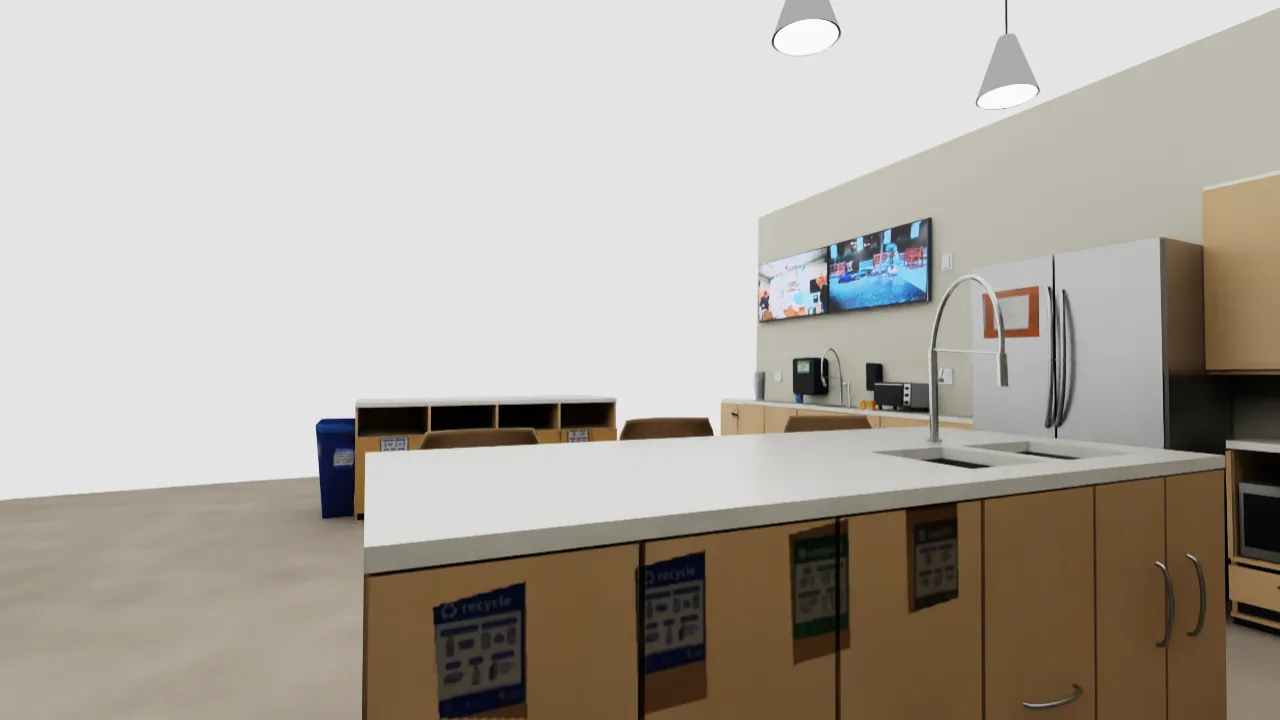
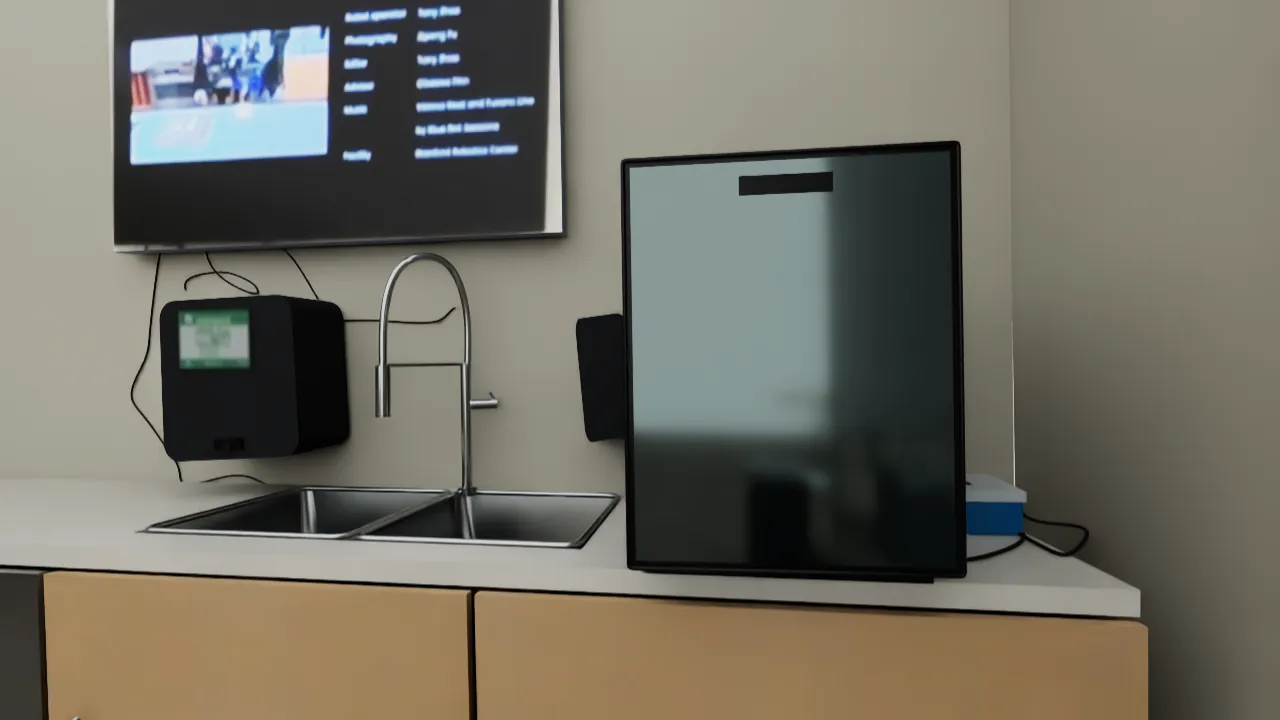
项目页用一个三档对照回答「精确的 Real2Sim 重建需要什么」:只有人手录的视频时,外观很富但房间尺寸只能靠外观估;只有 SLAM 时几何是实测的但没有外观;HomeBody 把相机观测、实测 SLAM 几何、关节位姿与选定航点一起交给 Real2Sim agent,于是数字孪生在几何、语义、视觉三个维度上都站得住。
| 重建输入 | 外观 | 几何 | 结果 |
|---|---|---|---|
| 人手录视频 | 丰富视觉细节,用于对齐房间外观 | 尺寸只能从外观估计 | 看得像,量不准 |
| SLAM 参考 | 无 | 实测几何约束尺寸 | 量得准,看不像 |
| HomeBody(本文) | 机器人自采相机观测 | 实测 SLAM 几何 + 关节位姿 + 选定航点 | 几何、语义、视觉三者都准 |
下面两组同机位对照(冰箱墙、玻璃转角水槽)就是这句话的证据:左为真实厨房照片,右为数字孪生中同一视角的渲染。
Step 3 · 给一个日常任务
Tidy up the kitchen. Put the coffee bags on the island and throw away the spoiled cartons.(收拾厨房。把咖啡袋放到中岛上,把变质的纸盒扔掉。)
给一句这样的指令即可。HomeBody 用它的空间上下文自选动作与目标,不需要动作级脚本。
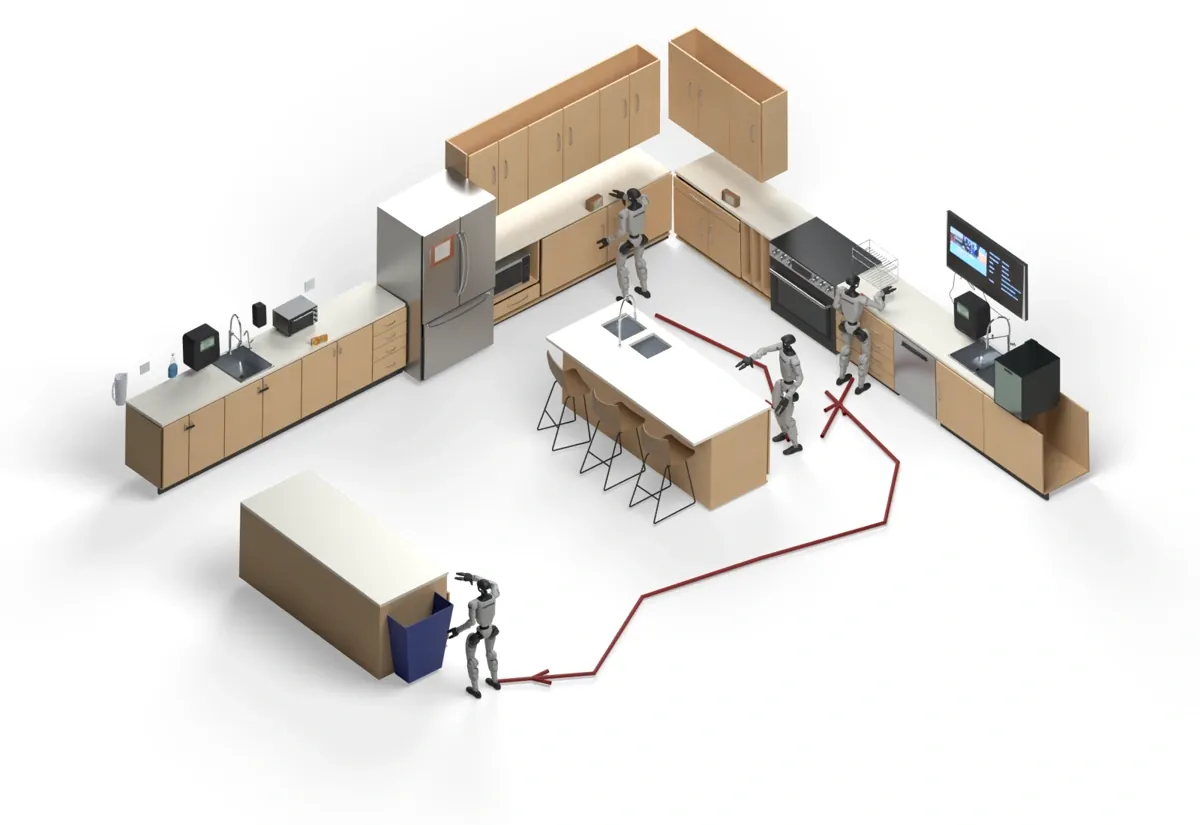
项目页给出的一条记录运行里,GPT Astra 的决策序列与理由是这样的:
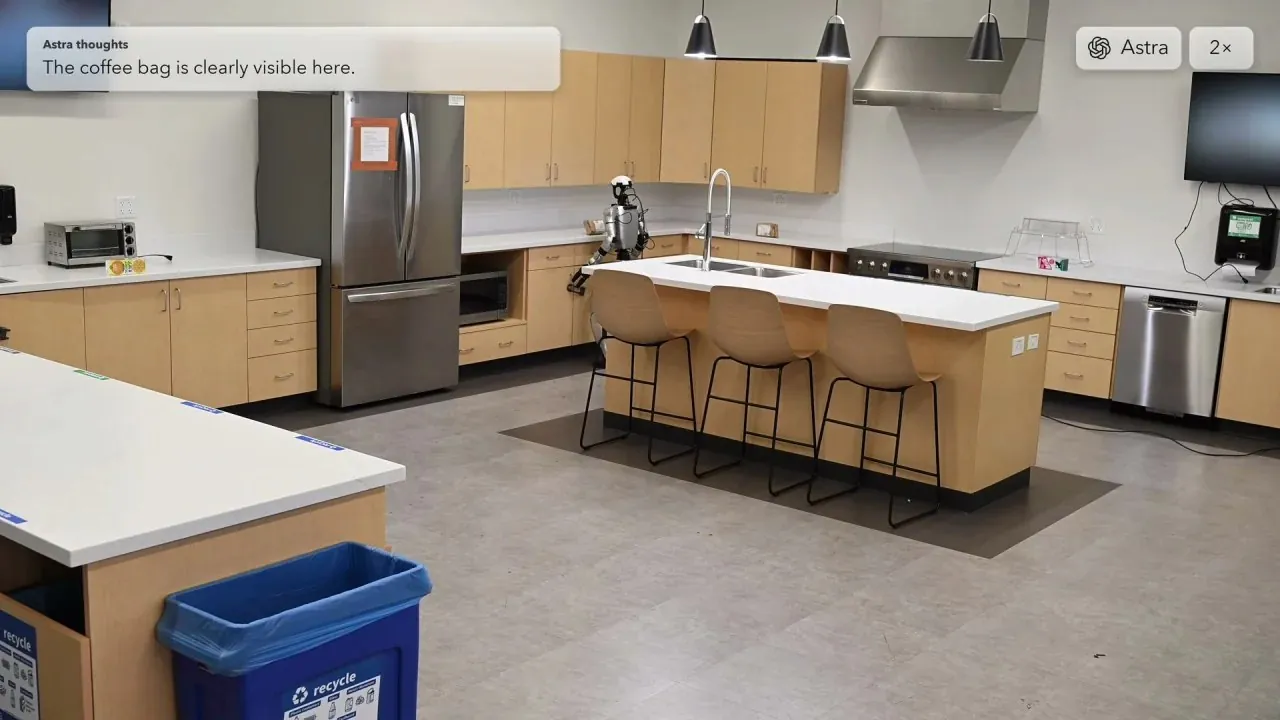
Pick —「the coffee bag is clearly visible here.」
Place —「the held coffee belongs on this counter.」
Navigate —「the milk carton was remembered there.」
Pick —「the milk carton is clearly visible here.」
Place —「the bin opening is visible and reachable.」
04. 技能库:五个动词与一个共享接口
导航、抓取、放置、开抽屉构成 HomeBody 的动作词汇表。技能共享同一套目标与执行结果接口,VLM 因此能在部署时把它们组合起来;本地重试与视觉反馈负责纠正执行误差。
| 技能 | 目标规格 | 执行要点 |
|---|---|---|
| Pick | 归一化到 0–1000 的图像点 + 用哪只手 | 分割 → 双目深度 → 标定投 3D → 解析抓取 → 样条 + IK + 扫掠碰撞检查 |
| Place | 哪只手 + 躯干坐标系下的 3D 释放点 + 释放距离 | 把持物体移到目标后开手 |
| Open drawer | 把手对齐目标 | 把手对齐、钩挂姿态、后退行走合在一个技能里 |
| Pick from drawer | 抽屉内的图像点 | 伸入开着的抽屉,把物体提出边缘 |
| Navigate | 地图坐标(米)里的 2D 目标点 + 朝向点 | 沿规划路线走到 Real2Sim 地图中的位置 |
以下预览多为 7–10 秒的加速版本;开抽屉与抓取保留了记录到的重试。抽屉取物预览从开着的抽屉开始、重试连续保留,到最后一次成功抓取才放慢(14× → 4×)。
技能库是开放的:通过共享接口接入一个学出来的策略、一个经典算法或另一个控制器,HomeBody 的 VLM 就能把它与既有技能串起来完成新任务。
05. 从 VLM 决策到物理动作
HomeBody 用空间目标把任务推理与物理执行接起来。VLM 从当前自观、地图上下文、夹爪状态、召回的观测与上一次结果里选出技能与目标,通过一次结构化 tool call 传下去,运动留给技能自己规划与执行——VLM 因此不需要知道技能的底层实现。
flowchart TD
  A["VLM 选中技能与目标: 图像点 0-1000 + 左右手"] --> B["SAM 2 分割该点"]
  B --> C["Fast-FoundationStereo 由 D435i 双目估深度"]
  C --> D["相机标定把掩膜几何投到 3D"]
  D --> E["解析预测抓取位姿"]
  E --> F["最小加加速度样条参考 + 沿路径 IK"]
  F --> G["扫掠运动碰撞 clearance 检查"]
  G --> H["执行, 结果回报给 VLM"]
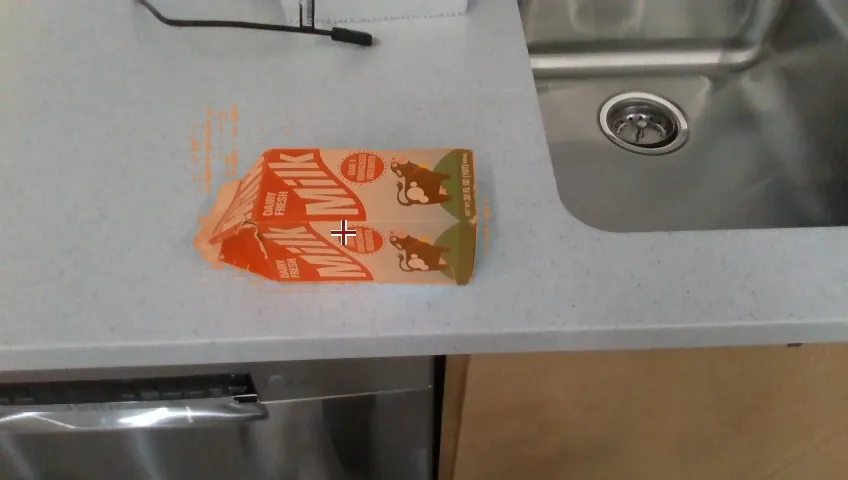
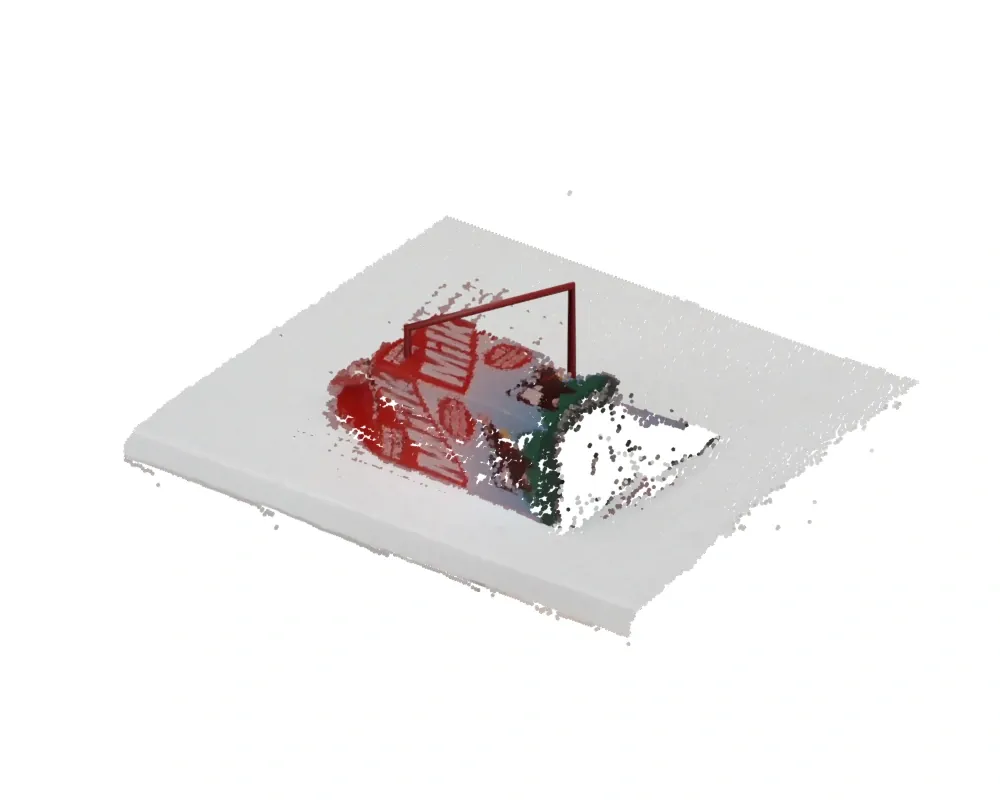
其它技能的目标各随其动作:导航要地图坐标(米)里的 2D 目标点与朝向点;放置要哪只手、躯干坐标系下的 3D 释放目标与释放距离;开抽屉则把把手对齐、钩挂姿态与后退行走合成一个技能,协调从「够」到「拉」的过渡。
06. 定位与重试:共享坐标系与有界重试
要规划如何完成任务,HomeBody 需要知道相关物体在哪、G1 相对它们在哪。为把这些决策落在同一个坐标系里,它用 Super Odometry 定位 G1,再用 ICP(iterative closest point)把 SLAM 地图与重建出的仿真对齐;自观相机观测连同描述性内容存在这个共享坐标系里,HomeBody 因此能回到记录过的位置。
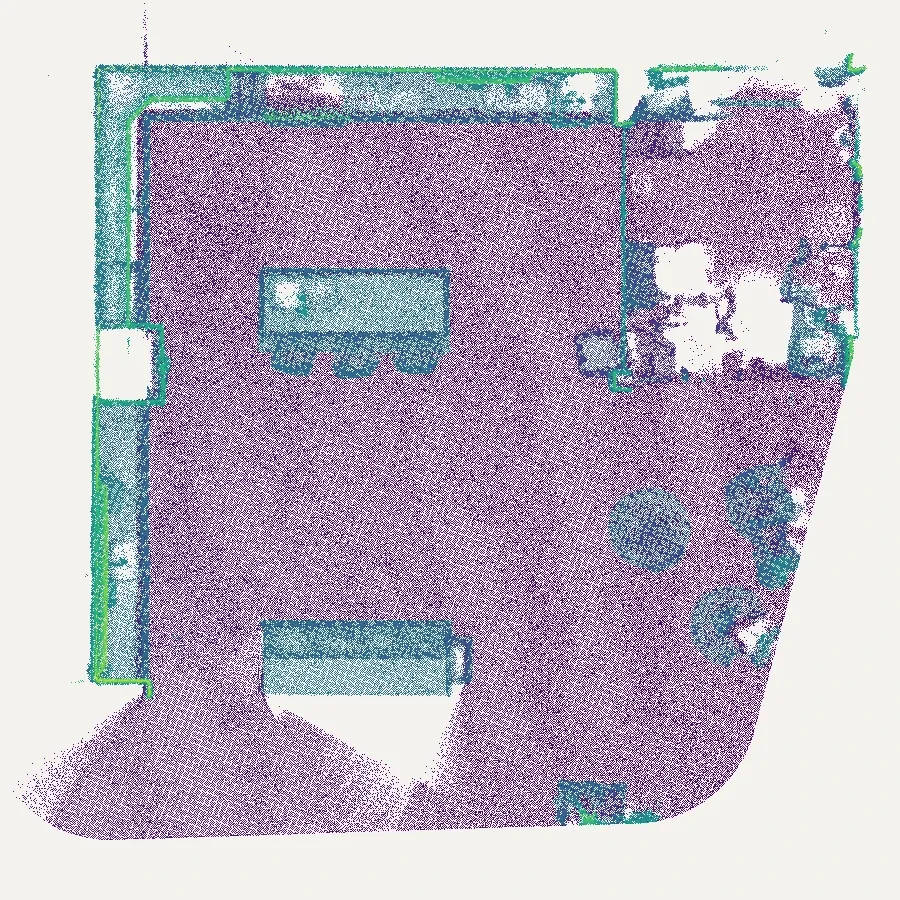
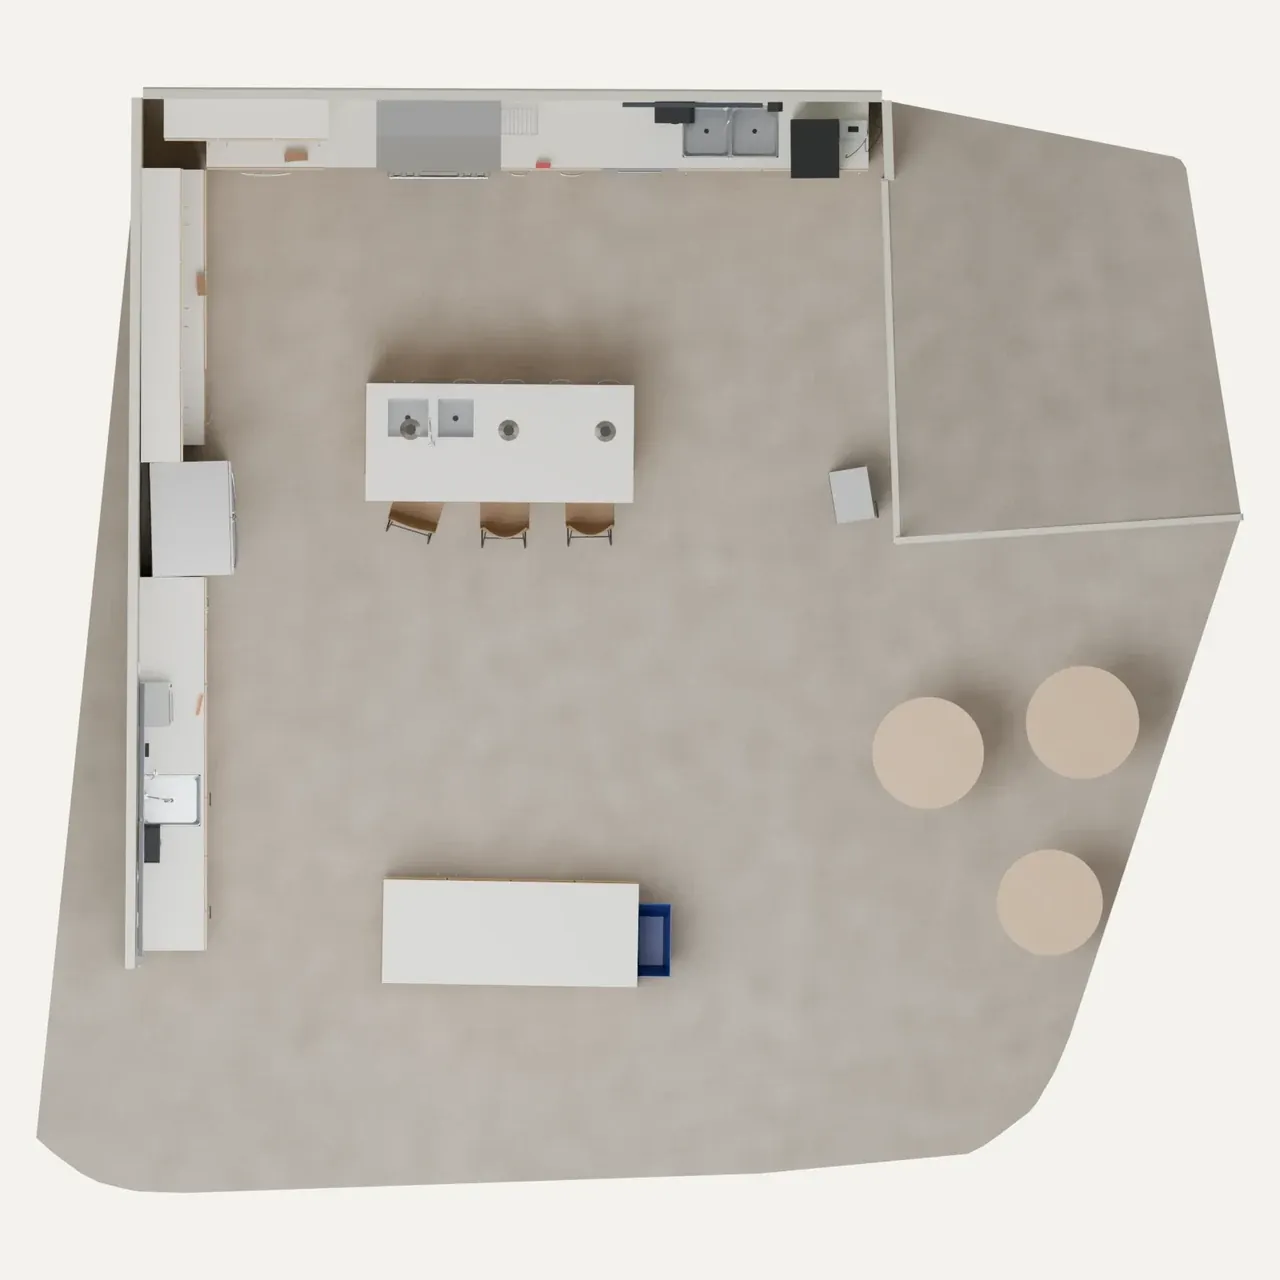
目标会在接近过程中于画面里漂移。分割先认出物体,SAM 2.1 跟踪配合 SAMURAI 的记忆选择在其后的帧里跟上它;视觉伺服用这些跟踪更新在接近途中修正对齐,不需要每次调整都再问一次 VLM。
若夹爪空合,pick 技能可以换另一个抓取候选,或调整站姿重新规划;这些本地重试是有界的。重试耗尽、或失败需要换一种动作时,技能把原因返回给 VLM,由它重新站位、换目标或改计划。
07. 全身控制与算力账本
长时序 loco-manipulation 要求上身够与抓的同时维持平衡。HomeBody 用预训练的 AMO 做「知道上身在干嘛」的下身控制——协调下身时把臂目标算进去。臂与手的命令跑在 250 Hz,AMO 策略每五个控制 tick 更新一次,即 50 Hz。
当前这套技能与感知、运动规划一起跑在一台带 RTX 4090 的 Razer Blade 笔记本上;GPT Astra 远程运行,把技能请求与目标发给笔记本、接收执行结果。本地执行技能、网络访问前沿模型,构成一套足够轻量的野外配置。
| 回路 | 频率 | 职责 |
|---|---|---|
| 臂 / 手命令 | 250 Hz | 跟踪样条参考,完成抓取与放置 |
| AMO 全身策略 | 50 Hz(每 5 个控制 tick) | 上身感知的下身协调,维持平衡 |
| VLM 决策(远程 Astra) | 技能粒度 | 选技能与目标、读执行结果、失败后改计划 |
08. 边界、代价与我们的读法
项目页对边界写得很直白:Real2Sim 重建带来额外的 setup 时间与 API 成本;任务长度受人形的够取范围、操作能力与硬件耐力约束——包括长时间工作后指关节伺服过热;GPT Astra 的推理延迟在技能之间留下停顿;当前本地栈需要 RTX 4090 级笔记本 GPU,加入更重的感知模型或技能可能需要更多算力。
我们的读法(本版本补充):HomeBody 真正交换的是成本的位置。学 VLA 的路线把成本压在采集与训练上,换来了部署时的便宜推理;HomeBody 把成本移到每间房一次的重建与前沿模型的 API 账单上,换来的是零任务训练——新房间、新指令都不需要再学一遍。在这笔交换里,承重墙是空间记忆:没有那份「关键帧 + 随帧描述 + 对齐坐标」,VLM 的每次决策都只能站在当前帧上,长时序任务会退化成一连串孤立的短任务。同时也要看清证据的强度:两条演示是定性的成功记录,重建是每间房一次的离线工序,技能之间的停顿仍由模型延迟决定。它更像对「VLA 是否必需」的一次存在性证明,与靠大规模第一人称数据喂 VLA 的路线互补,而不是替代。
flowchart LR
  V["GPT Astra (System 2)"] -->|"skill + target"| S["技能库 (System 0 执行)"]
  S -->|"observations + outcomes"| V
  M["空间记忆: 关键帧 + 随帧描述 + SLAM 对齐坐标"] --> V
  S -->|"新观测写回"| M
09. 致谢、引用与开源计划
Gio Huh 由 Caltech 以 Mark Reinecke SURF Fellow 支持,在斯坦福 The Movement Lab 从事长时序人形 loco-manipulation 研究,并参加了斯坦福本科生访问研究实习(UGVI)项目。作者感谢斯坦福机器人中心(SRC)提供厨房场地、TML 提供 API 额度,感谢 Alan Yu 与 Sarthak Kamat 的讨论。
引用文献:[1] Super Odometry: IMU-centric LiDAR-Visual-Inertial Estimator for Challenging Environments;[2] NVIDIA Isaac Sim;[3] SAM 2: Segment Anything in Images and Videos;[4] Fast-FoundationStereo: Real-Time Zero-Shot Stereo Matching;[5] SAMURAI: Adapting Segment Anything Model for Zero-Shot Visual Tracking with Motion-Aware Memory;[6] AMO: Adaptive Motion Optimization for Hyper-Dexterous Humanoid Whole-Body Control。
代码以 Apache 2.0 开源于 github.com/Stanford-TML/homebody。按 README 的发布计划:MuJoCo SIM 后端已于 2026-10-05 发布(可复现 SRC 厨房的长时序运行,完整物理、Unitree G1 + Dex3 手,GPU 可选);REAL2SIM 与 REAL 后端计划分别于 2026-10-12 与 2026-10-19 发布。README 还记录了一次「记忆拷问」测试:把纸盒挪位之后,Claude Opus 两次都找到了被挪走的纸盒,其中一次花了 29 分钟。
| 代号 | 模型 | 状态 |
|---|---|---|
| astra | GPT-6 Astra | 默认,已验证 |
| opus | Claude Opus 5.5 | 已验证 |
| sol / luna / terra | GPT-5.6 Sol / Luna / Terra | 仓库可配置,未验证 |
| fable / sonnet / haiku | Claude Fable 5.1 / Sonnet 5.5 / Haiku 4.5 | 仓库可配置,未验证 |
来源:Stanford The Movement Lab 项目页《HomeBody: A Humanoid That Explores, Remembers, and Acts on Its Own》(tml.stanford.edu/homebody/,2026 年 9 月),作者 Gio Huh、Cayden Gu、Takara E. Truong、C. Karen Liu、Guy Tevet;代码与 README 见 github.com/Stanford-TML/homebody(Apache 2.0)。本文为全文翻译与改编,全部图片与视频来自项目页与仓库;Real2Sim 对照表、技能目标表、控制频率表、模型表与两张流程图为本版本补充。
原文来源:Stanford TMLhttps://tml.stanford.edu/homebody/