
0 元搭出舞台级 3D 动漫 MV:GPT、Muse 与 Opus 5.5 的完整制作链
Hailey 用 GPT 拆分角色与分镜、Muse 生成舞蹈、Claude Opus 5.5 编写 Three.js 舞台,把绿幕动作接入节拍与镜头,展示 AI 视频走向可编辑制作链的方法与局限。
“0 元”指的是没有额外买素材
Hailey 这篇文章最有价值的地方,不是又展示了一支 AI 生成的舞蹈视频,而是把生成式视频从“反复抽卡”改造成了一条可以分工、可以回改的制作链。她让 GPT 负责角色设计、剧本、分镜和编舞思路,让 Muse 生成绿幕舞蹈或完整 MV,再让 Claude Opus 5.5 编写代码,完成抠像、Three.js 舞台、音乐分析、灯光、粒子、运镜和人物合成。
标题里的“0 元”需要准确理解。作者的意思是,这次制作没有额外购买素材、音乐或生成额度,使用的是已经拥有的工具和订阅额度。它不等于任何人都能零成本复现。Muse、Claude Opus 5.5、GPT 等工具仍然需要相应订阅、积分或 API 预算;如果反复重生成视频,消耗还可能迅速上升。真正被省掉的是摄影棚、演员、3D 场景资产和传统后期团队,而不是所有算力与软件成本。
这篇文章真正提出的问题不是“哪个模型能一键生成 MV”,而是“怎样让不同模型各自做擅长的事,并把结果接到一条可编辑的时间线上”。
这正好解释了为什么成品里既有生成视频的自然动作,又有传统 3D 场景的稳定镜头。人物舞蹈由视频模型负责,舞台的几何、材质、灯光与镜头由代码负责。前者擅长生成不确定但富有表现力的内容,后者擅长重复执行精确、可修改的规则。两者没有被塞进同一个提示词里,而是通过时间线连接起来。
先拆资产,再谈一键生成
如果把“做一支 MV”直接交给一个视频模型,提示词往往要同时承担角色一致性、舞蹈、镜头、灯光、场景、歌曲和剪辑。任何一项不满意,都可能需要重新生成整段视频,前面已经合格的部分也会被一起丢掉。Hailey 的做法是先把成片拆成三类可以独立替换的资产。
| 资产 | 主要工具 | 输出 | 修改方式 |
|---|---|---|---|
| 角色与剧本 | GPT | 人物设定、性格、服装、分镜、动作意图 | 改文字设定,再重新生成对应素材 |
| 动作与声音 | Muse、Grok Bot、Suno 等 | 绿幕舞蹈、完整 MV 或音乐 | 换片段,不必重做整个舞台 |
| 舞台与合成 | Claude Opus 5.5、Three.js | 抠像层、棱镜场景、灯光、粒子、镜头、同步系统 | 改代码或参数,结果可重复 |
角色设计不是一句“银发赛博偶像”就结束。文章中 NOVA 的设定同时包含身份、年龄、性格、视觉关键词、正面与侧面视图、面部表情、眼部细节、发色、服装材质、配件和舞蹈风格参考。这样做不是为了做一张漂亮的人设图,而是为了让后续每次生成舞蹈或分镜时,模型都有足够稳定的视觉约束。
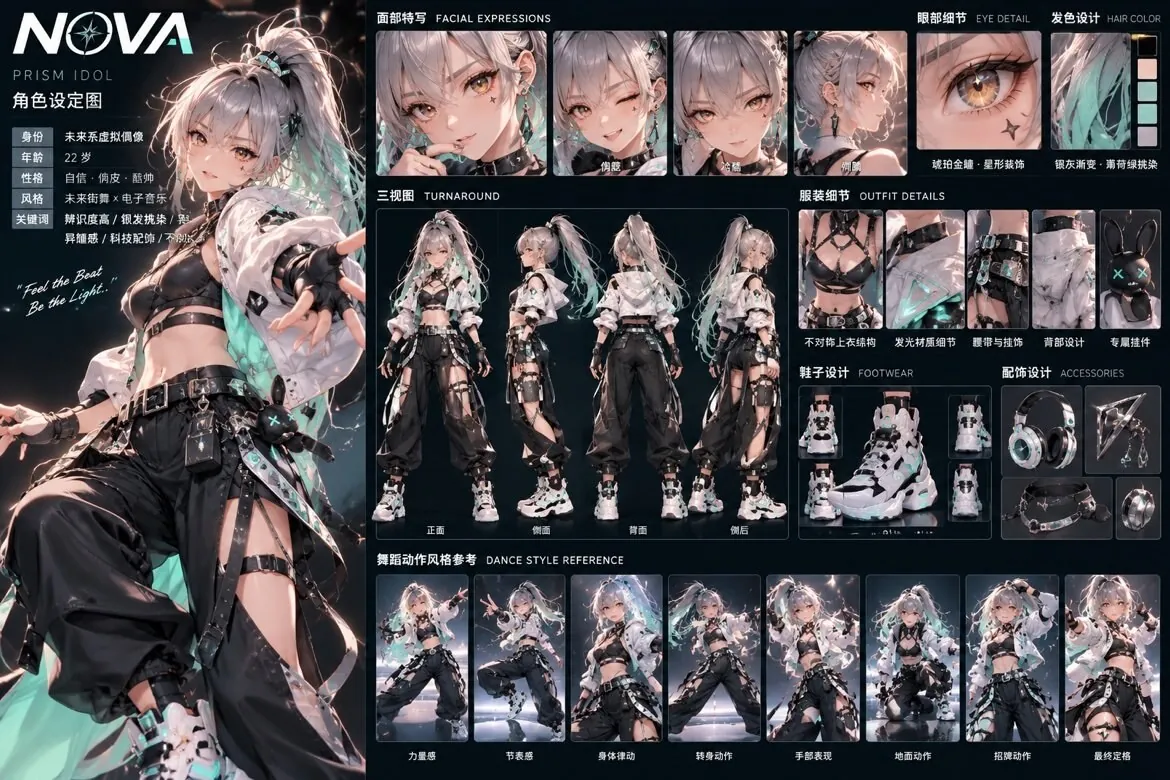
这一步的工程意义很像软件开发里的接口定义。角色卡定义了输入约束,分镜定义了时间约束,音乐和动作事件则定义同步接口。只要这些接口稳定,底层生成模型可以替换,舞台代码也可以继续迭代。真正昂贵的不是某一次生成,而是当需求改变时,能否只重做一小段。
路线一:先生成舞蹈,再让音乐追动作
Hailey 展示的第一条路线,是先得到一段绿幕舞蹈,再分析动作和音乐节拍,让舞台效果跟着动作走。它适合已经有满意舞蹈片段的情况。人物动作是创作的核心,音乐、灯光和镜头围绕已经发生的动作组织。
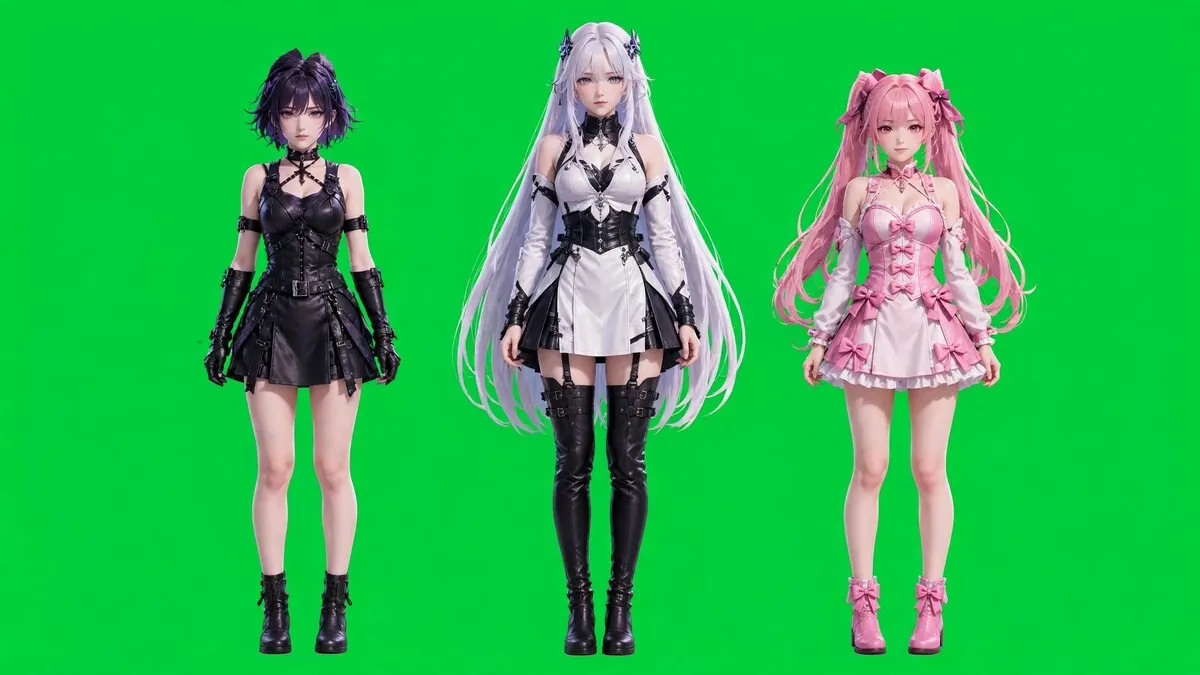
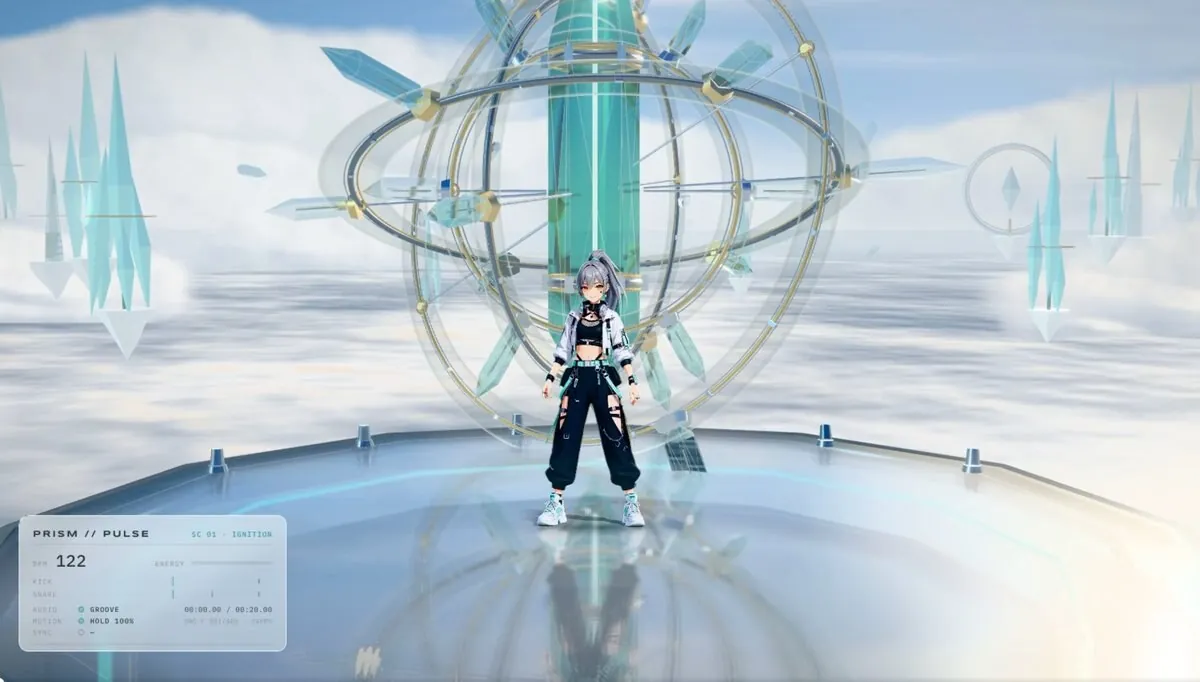
人物片段先被当作“动作容器”,而不是锁定成最终画面。代码读取视频帧,识别人体姿态、动作阶段和时间位置,再把动作整理成事件。文章提到,其中一个版本识别出 38 个动作事件,并在音乐与动作之间找到 20 个同步节点。这里的“事件”可以理解为一次抬手、一次转身、一次下蹲、一次队形变化或一个明显的姿势停顿;“同步节点”则是动作到达关键姿态时,音乐、灯光或镜头也应该发生变化的时刻。
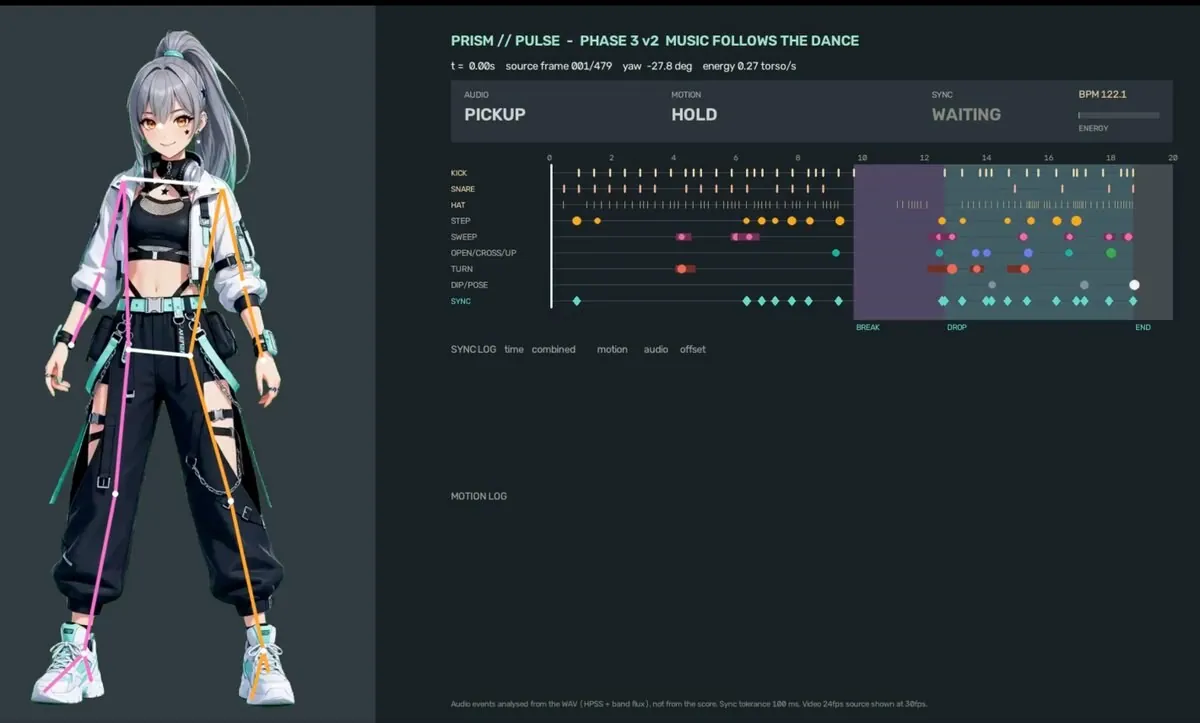
截图里的分析面板同时显示音频事件和动作事件,并区分 pickup、hold、waiting 等状态。最下面特别注明,音频事件分析的是 WAV,而不是来自乐谱;它使用 HPSS 与频带滤波寻找瞬态,并以约 100 毫秒的容差做同步。这个细节很关键:系统并不是“听懂音乐”,而是在检测底鼓、军鼓、镲片、能量变化和节拍位置,然后把这些可计算的信号映射到视觉参数。
早期版本还以 157 BPM 的曲目为例,把底鼓、军鼓和节奏表盘做成实时可视化。到了后续版本,界面显示约 122 BPM,动作时间线被分成 break、drop 和 end 等段落。不同版本的数字不必强行统一,因为作者在多次迭代中更换了音乐和动作片段。真正稳定的思路是:先得到节拍与动作的共同时间轴,再让舞台参数成为这条轴上的函数。
| 同步信号 | 可以驱动什么 | 为什么有效 |
|---|---|---|
| 底鼓与低频能量 | 地台脉冲、镜头轻微震动、体积光闪烁 | 低频冲击适合短促、幅度明显的视觉反馈 |
| 军鼓与高频瞬态 | 粒子爆点、棱镜闪烁、灯光切片 | 尖锐声音与高亮、细碎的视觉元素容易形成联觉 |
| 动作阶段与关键姿态 | 镜头切换、场景颜色、队形灯位 | 视觉重心跟随人体动作,卡点不会只剩机械闪烁 |
| 段落边界 | 舞台结构变化、背景材质与镜头距离 | break、drop、结尾需要不同层次的场景,不只是参数变大 |
这条路线最重要的优势,是音乐和画面不会只是“踩同一个拍”,而是能形成因果感。人物先抬手,灯光随后掠过;人物定格,镜头也短暂停住;进入副歌时,舞台几何和粒子密度同时变化。代码的作用是把这些关系写成可复用规则,而不是每一帧都手工调整。
路线二:先生成音乐,再按分镜生成舞蹈
第二条路线反过来,先把音乐定下来,再让 GPT 根据歌曲结构设计剧情和分镜,最后让 Muse 按分镜生成舞蹈。文章展示了约 55 秒、15 个镜头的版本,分镜表把每一段精确到秒,并给每个镜头指定人物、景别、动作与镜头运动。
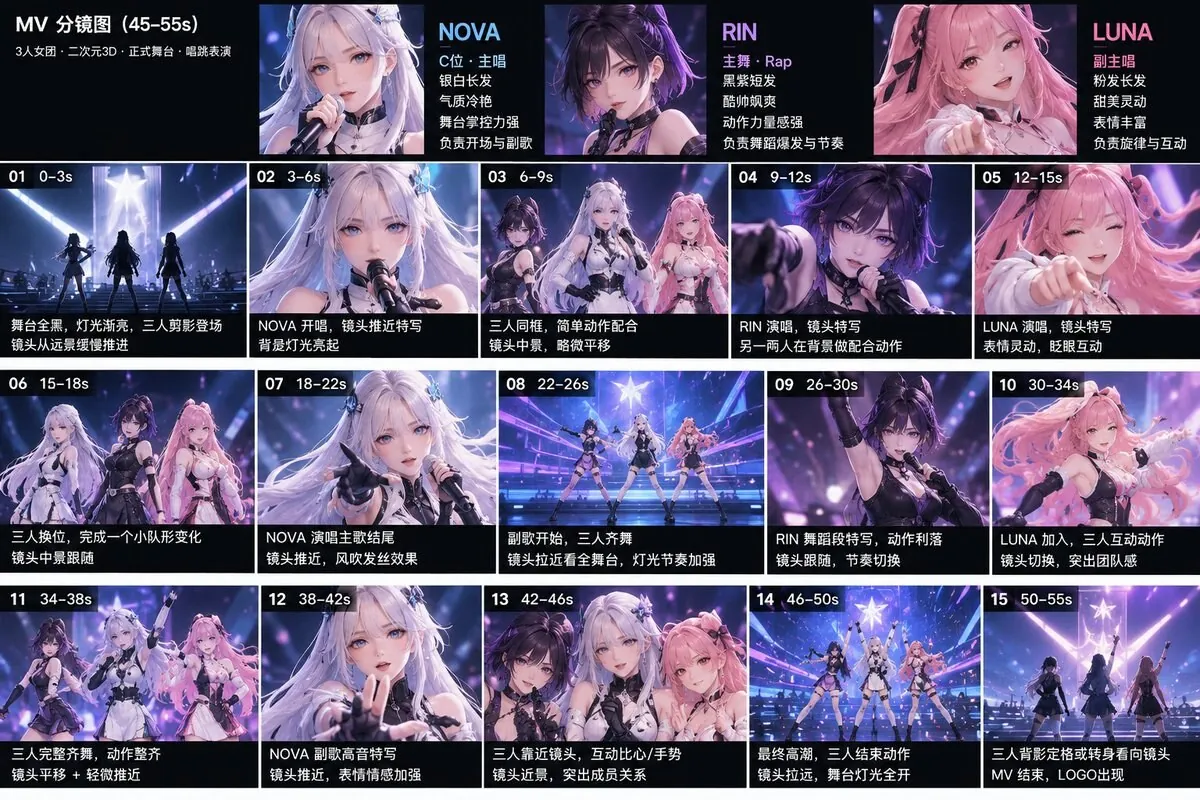
这张分镜表的价值在于把“请生成一个酷炫女团 MV”拆成了可以逐段执行的描述。例如 0 至 3 秒是舞台全黑、灯光渐亮、三人剪影由远及近;3 至 6 秒切到 NOVA 开唱特写;6 至 9 秒切到三人同框;9 至 15 秒分别给 RIN 和 LUNA 独唱;之后进入换位、副歌齐舞、成员互动和最终定格。每个镜头都带着时间范围和镜头目的,生成结果就不再完全依赖一次长提示词。
角色分工也被写进剧本。NOVA 是 C 位与主唱,负责开场和副歌;RIN 是主舞与 Rap,负责舞蹈爆发;LUNA 是副唱,承担甜美表情和成员互动。这样生成时就不会出现三个人都做同一动作、镜头却无法建立角色识别的问题。对于多人 MV,角色功能比单纯堆叠“更精致、更华丽”的形容词有用得多。
音乐先行的好处是结构清楚。GPT 可以依据前奏、主歌、预副歌、副歌、bridge 和结尾,为每个段落安排不同的镜头密度和舞台状态。Muse 生成舞蹈时,也就有了明确的段落、节拍和情绪,而不是拿到一整首歌后自行猜测哪里应该爆发。代价是音乐与具体动作之间的逐帧贴合仍然需要后期检查,尤其是切镜点和人体重心变化未必天然一致。
代码舞台:把随机生成变成可改的系统
整个项目最值得借鉴的部分,是 Claude Opus 5.5 用代码搭出的 Three.js 舞台。人物视频仍然是二维视频面片,但舞台、棱镜、地台、灯光、粒子和相机都是真正的三维对象。代码可以完成绿幕抠像,把人物从背景中分离出来,再放进一个与镜头共享透视关系的场景。
这种结构和“让视频模型直接生成带舞台的成片”有本质区别。视频模型每次生成都会改变细节,舞台无法稳定复用,改一个灯光颜色也可能让整段人物动作重新采样。代码舞台则是确定性的:同一个场景参数会得到同一个几何结果,灯光可以单独调,镜头可以单独改,粒子密度和触发规则可以版本化。人物素材不满意时换人物,舞台不需要重做;舞台不满意时改代码,人物动作也不会被浪费。
// 概念示意:不是原文代码,而是文章所示同步系统的最小结构
const timeline = buildTimeline({
  audioEvents,
  motionEvents,
  syncNodes,
});

for (const node of syncNodes) {
  timeline.at(node.time, () => {
    stage.setEnergy(node.audioEnergy);
    lights.pulse(node.beatStrength);
    particles.emit(node.motionLabel);
    camera.applyShot(node.shot);
  });
}
这段伪代码概括了文章展示的分层方式:音乐分析、动作分析、同步节点和视觉执行彼此分开。真正的实现会涉及视频解码、绿幕阈值、溢色处理、透明边缘、视频纹理更新、Three.js 材质与后期合成。代码不是“替代审美”,而是把已经确定的审美关系稳定地执行出来。
绿幕抠像也有明显边界。首先,人物是二维视频面片,不是真正的三维人体。一旦镜头绕到侧面,人物不会像实体模型一样产生新的观察角度。其次,脚底接触、地面阴影、透视变化和前后遮挡需要人工调整,否则很容易出现“人漂浮在舞台上”的感觉。第三,头发、半透明服装和快速运动会产生边缘溢色,粗糙阈值会把细节一起吃掉。
所以这篇文章展示的不是“代码已经解决所有视频合成问题”,而是一个成本更低的折中:用视频模型获得人物动作,用代码获得可控空间。对于短 MV、概念片和社交平台内容,这个折中非常有效;对于需要真实环绕镜头、精确物理交互或长时间特写的项目,仍然需要真正的 3D 角色、动作捕捉或更复杂的合成流程。
三种模型组合,各自解决不同瓶颈
Hailey 没有把某一种模型组合说成唯一答案,而是比较了三种路线。这个比较比单纯的工具推荐更有用,因为三种组合的瓶颈并不相同。
| 组合 | 优点 | 主要问题 | 适合场景 |
|---|---|---|---|
| Grok Bot + Muse | 人物融合自然,流程简单,成本较低 | 分辨率、卡点和精细舞台控制较弱 | 快速制作完整感强的短视频,优先追求出片速度 |
| Muse + Opus | 舞台完全可控,可以写代码复用,灯光与镜头自由调整 | 人物与三维场景的合成难度更高,绿幕细节需要人工处理 | 需要独特舞台、稳定品牌视觉或反复改版的 MV |
| Grok Bot + Muse + Opus | 音乐、人物和舞台都能分别调整,整体上限更高 | 链路最长,资产传递、时间同步和版本管理最复杂 | 可以投入多轮迭代的完整项目,而不是当天出片 |
第一种组合把更多决定权交给视频模型。它能快速得到人物、场景和音乐融在一起的完整片段,流程短,但也很难只改一个元素。第二种组合把舞台从生成模型手里拿回来,代价是绿幕人物天然带有二维素材的限制。第三种组合最有扩展性,却要求作者同时管理文字设定、视频片段、音频事件、动作事件和代码版本。
这也是“AI 让创作变简单”经常被误解的地方。工具确实减少了建模、渲染和剪辑的操作成本,但并没有消除项目管理。相反,资产越多,越需要清楚的命名、时间轴和回退机制。一个成熟的工作流应该知道哪一步可以接受随机性,哪一步必须确定性执行。
先音乐还是先舞蹈
两条路线没有绝对优劣,取决于创作者最先确定的是什么。如果先有满意的舞蹈,就让音乐和舞台去追动作。此时人物表现力最强,但音乐需要重新适配动作,节拍点也必须跟随已经发生的姿势,后期同步成本较高。如果先有完整音乐,就让分镜和舞蹈去服从歌曲结构。此时段落推进最稳,但每个镜头都必须按照音乐长度和节拍切分,生成舞蹈的可控性成为主要风险。
| 判断项 | 舞蹈先行 | 音乐先行 |
|---|---|---|
| 创作起点 | 一段满意的绿幕动作 | 一首完整歌曲或明确段落结构 |
| 同步方法 | 识别动作事件,再寻找音乐节点 | 先切分歌曲,再生成 15 段分镜动作 |
| 最大优势 | 人物动作自然,舞台可以围绕动作爆发 | 结构清楚,镜头密度和情绪推进容易统一 |
| 最大风险 | 音乐可能为了动画而失去完整性 | 动作可能为了卡点而显得机械或断裂 |
更现实的做法,是先生成 15 至 30 秒的短样片验证动作和舞台,再决定是否扩展到完整歌曲。短样片能暴露最贵的问题:角色是否一致、脚底是否滑动、绿幕边缘是否可接受、镜头是否破坏人物比例、节拍点是否过于密集。如果这些问题在 15 秒内没有解决,直接生成 55 秒只会把错误放大。
完整 MV 与街头风格变体
除了代码合成路线,Hailey 还展示了 Muse 直接生成完整 MV 的版本,以及 Suno 提供音乐、Muse 根据音乐生成画面的三人女团版本。它们说明同一个创意可以在不同自动化程度上完成。直接生成流程更像“把模型当成完整导演”,代码合成流程更像“把模型当成素材供应商”。
54 秒的 K-pop 版本和 30 秒的街头风格版本进一步说明,提示词写作不是只描述“歌曲风格”。人物关系、舞台空间、镜头节奏、服装材质和舞蹈类型都会改变最终画面。街头版本把场景移到涂鸦墙与湿地面,服装也换成更松散的街头造型;这些变化需要角色设定、场景描述和动作风格同时调整,而不是只换一个背景词。
失败版本为什么值得保留
文章也放出了最初用 SVG 或关键帧尝试动作的失败画面。画面里的节奏表盘、人物和界面都出现了,但人物动作没有达到舞蹈视频应有的身体感。保留这个失败版本很有价值,因为它证明“把节拍画出来”与“让身体真的跳舞”是两件不同的事。
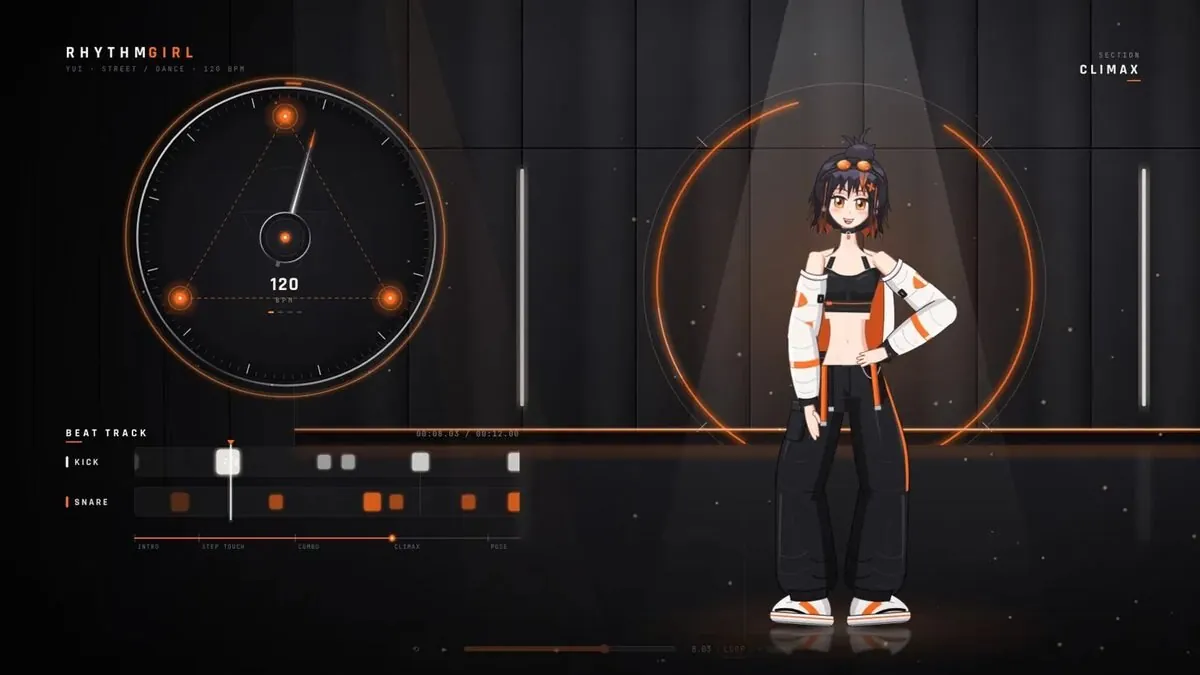
这正是生成视频模型仍然不可替代的地方。代码擅长时间、结构和重复,视频模型擅长从大量人体动作中生成连贯的姿势变化。把它们放在正确的层级,才能同时获得身体表现力和舞台稳定性。如果强行用代码逐关节模拟舞蹈,项目会迅速变成动作捕捉和角色绑定工程;如果强行让视频模型一次完成所有舞台和镜头,又会失去可编辑性。
这套方法对机器人学习有什么启发
这篇文章不是机器人研究,不能把 MV 合成直接等同于机器人能力。但其中“把示范拆成事件,再用确定性系统执行”的结构,和机器人学习里的部分问题有相通之处。视频里被识别的动作事件,可以类比为从人类演示中提取阶段、关键帧和接触状态;Three.js 舞台和同步逻辑,则类似仿真环境、控制器和调度器。
机器人也可以采用类似分工:学习模型负责从视觉与语言中理解任务、生成候选动作,确定性控制器负责保证关节限制、碰撞、时序和安全约束。真实系统不能像视频合成一样只追求视觉合理,还需要满足物理可行性、闭环反馈和失败恢复。因此这里能迁移的是架构思想,不是生成视频本身。
更具体地说,有三个可复用的原则。第一,把高维示范压缩成事件序列,降低时间对齐的难度。第二,让生成模型输出带时间和语义标签的中间资产,而不是只输出一个不可解释的最终结果。第三,在中间资产之后接确定性执行层,这样才能重复、比较和回滚。对机器人而言,这个执行层必须比代码舞台更严格,因为错误会发生在物理世界。
复现时应先控制哪些变量
如果要用类似方法做一支短片,不建议第一天就生成完整歌曲。先把变量压到最少:一个角色、一个固定舞台、8 至 15 秒音乐、一个明确动作段落、一个镜头。确认角色、绿幕边缘和地台阴影成立后,再增加第二名角色和切镜。
- 固定角色卡。服装、发型、配色和脸部特征要能在不同镜头中被识别,避免每次生成都变成另一个人。
- 固定视频规格。统一帧率、画幅和人物占比。混用横屏、竖屏或不同透视的素材,会让舞台合成迅速失控。
- 先做时间轴。把音乐段落、动作事件和镜头切点写在同一张表里,再开始堆叠灯光与粒子。
- 先做可读性。远景、中景、特写要有明确功能。每一秒都闪烁和爆炸,最后反而没有高潮。
- 保留回退。人物、音频、舞台代码和合成工程分开保存,任何一层不满意都可以单独替换。
- 把预算算全。生成次数、存储、转码、人工修边和合成检查都是成本,额外素材费为零不代表总工时为零。
文章的多条成品也说明,最有效的改进往往不是把提示词写得更长,而是改变资产边界。例如人物动作不合格时,不该继续给整个舞台加形容词,而应该只重新生成舞蹈;舞台不够有层次时,也不该重新生成人物,而应该调整代码中的空间、材质和灯光。这种“只改坏掉的那一层”的能力,才是整套流程比单次生成更成熟的地方。
结论:从抽卡式生成走向制作系统
Hailey 的教程展示了一条很清楚的演化路径:第一阶段是让模型生成一个完整视频,第二阶段是把角色、动作、音乐和舞台拆开,第三阶段是用代码把可确定的部分稳定下来。越往后,单次生成看起来越不神奇,但制作过程越接近真正的创作系统。
GPT 在这里不是最终导演,Muse 也不是完整后期,Claude Opus 5.5 更不是自动审美。它们分别承担文本规划、视觉生成和程序实现。价值来自接口,而不是某一个模型单独的能力。角色卡给视频模型约束,动作事件给舞台代码输入,音乐分析给时间线证据,Three.js 再把它们组织成镜头。
这套方法仍然需要人工判断:哪一段舞蹈值得保留,哪一个切点真正有力量,哪一处合成看起来像贴纸,哪一次灯光变化只是噪声。AI 降低了尝试成本,却提高了对素材筛选和系统组织的要求。对想做高质量 MV 的人来说,最重要的转变不是寻找“一键生成”的提示词,而是开始像管理一个小型制作管线那样管理模型输出。
来源
原文:Hailey (@HaileyAILabs) 的 X Article“0 元挑战!用 AI + 代码做一支舞台效果炸裂的 3D 动漫 MV,完整教程来了!”,发布于 2026 年 11 月 1 日。
关联演示与过程记录:早期 157 BPM 节奏舞台、Muse + Opus 成品总结、代码抠像与动态舞台、Grok Bot 音乐 + Muse 完整 MV、Suno + Muse + GPT 三人女团、54 秒 K-pop 版本、30 秒街头风版本。
原文来源:X Article / Hailey (@HaileyAILabs)https://x.com/HaileyAILabs/status/2116733405518061828