什么是评估驱动开发?让 AI 智能体从手调走向可验证迭代
完整解读评估驱动开发:先定义行为规格与评估,再以基线、逐样例比较和 trace 构成智能体的可验证迭代闭环。
大多数智能体开发都从同一种方式开始:写一个提示词,手动试几个问题,调整提示词,再试一次。在故障很直观、改善也容易看出来的早期,这个循环有效。但当智能体成长为多步骤系统后,它就不再可靠,因为修复一个问题可能悄悄破坏另一个问题。到了这个阶段,“最新一次回答看起来更好”不足以支撑发布决定。
评估驱动开发(Eval-Driven Development,EDD)用一套稳定的度量体系替代依赖直觉的循环。团队先定义什么算好行为,在实现能力之前写评估,记录基线,并让后续每个实验都与基线及前一个版本比较。LangChain 将这一过程概括为三步:
- 定义智能体的“好”是什么。
- 在开发之前先写评估。
- 实施改动,并比较实验。
这个概念借自测试驱动开发,但不能机械照搬。智能体行为具有随机性,语言允许同一个结果有多种正确表达,而且智能体会自行选择执行步骤。因此,EDD 在一个数据集上评估多次运行的整体表现,而不是断言某个输出字符串必须与另一个字符串完全相同。
核心要点
- EDD 是有控制的爬山。 用一致的指标持续测量智能体,再依据证据判断下一次改动是否真的带来了进步。
- 从简短的行为规格开始。 明确行为何时发生、智能体必须做什么、不能做什么,以及哪些既有行为必须保持不变。
- 比较完整实验,而不是孤立回答。 平均分上升可能掩盖某个重要样例上的严重回归。
- 评估是持续运行的生产系统。 在 CI 中运行快速检查,上线后抽样评估真实流量,再把新发现的故障转化为数据集样例。
什么是评估驱动开发?
测试驱动开发要求开发者先写一个失败测试,再写代码让测试通过。EDD 保留了“先定义成功”的顺序,但把验证单位从确定性的测试用例,改成了带评分的一组样例。
传统软件测试不适合直接套用到智能体,原因有三个:
- 输出会变化。 同一个问题在每次运行时可能得到不同回答。
- 正确答案不止一个。 两段自然语言回答措辞不同,也可能都表达了同一个正确结果。
- 智能体自己选择步骤。 它可能调用一个不需要的工具,或者跳过一个本应使用的工具,却仍然给出看似正确的最终答案。
评估通过在一个数据集上给多次运行打分来处理这种不确定性。评估器可以检查最终回答、一次工具调用、一个中间步骤、完整动作序列,或者智能体在环境中留下的最终状态。确定性属性可以用代码检查;主观属性可以由 LLM 裁判评分。在 EDD 中,这些分数成为可执行的“成功定义”,团队围绕它们推进开发。
| 维度 | 测试驱动开发 | 评估驱动开发 |
|---|---|---|
| 核心产物 | 一个确定性测试 | 数据集,以及一个或多个评分评估器 |
| 预期结果 | 通常是一条精确断言 | 跨样例的通过率、分数或行为属性 |
| 故障诊断 | 堆栈与测试输出 | 模型调用、工具调用、状态变化和评分的 trace |
| 核心风险 | 契约被破坏 | 回归、过拟合、裁判噪声和覆盖不足 |
第一步:定义智能体的“好”是什么
第一项工作不是写更好的提示词,而是定义智能体应该完成什么,并列出实现目标所需的行为。这些行为可能包括从知识库回答问题、代表用户执行动作,或者知道何时应该追问。把每种行为的需求写下来,就形成了智能体的产品需求文档。
EDD 每次只处理一种行为。目标足够窄,才能稳定地爬山;如果同时改动多个变量,就无法判断究竟哪一处带来了改善或回归。要处理的行为通常来自即将开发的功能,或者历史运行中发现的故障。
写代码前,先写一份包含四部分的简短规格:
- 何时: 行为应该在什么情境下发生。
- 做什么: 智能体必须执行的动作。
- 不做什么: 必须避免的相邻错误行为。
- 保持什么: 不能回归的既有行为。
规格必须精确到可以判为通过或失败。“要有帮助”不是行为需求;工具路由决策、必要的状态转换或明确的拒绝,才可以被稳定评估。
一个具体的内部文档智能体案例
假设一个内部文档智能体负责回答员工问题,目前有两个工具:search_docs 搜索公司文档,web_search 搜索公开信息。团队准备增加 create_ticket,让智能体能够提交 IT 工单。
行为规格可以写成:
- 何时: 用户报告某个东西坏了,例如“我的笔记本连不上 VPN”。
- 做什么: 调用
create_ticket。 - 不做什么: 对“如何连接 VPN”这类操作指导问题创建工单。
- 保持什么:
search_docs和web_search仍能处理它们当前负责的问题。
虽然新工具尚不存在,评估仍然先按这些规则定义。这个有意留下的能力缺口,正是后续实现要填上的失败目标。
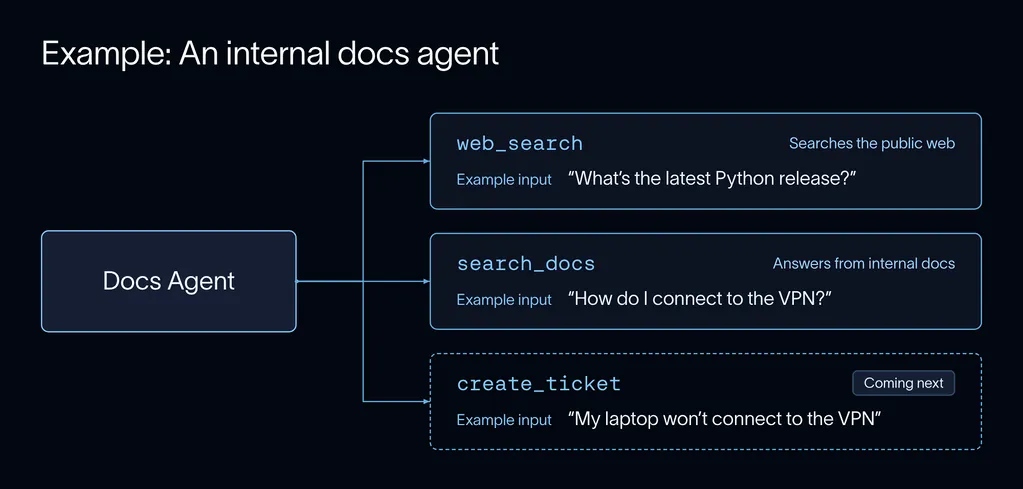
create_ticket 在实现之前就先进入行为规格。第二步:在开发之前写评估
构建数据集
数据集是一组样例,每个样例包含输入,并可选地包含参考输出或“金标准”输出。真实智能体运行是最好的输入来源之一:用户会用研发人员想不到的方式表述需求,也会带来难以凭空设计的边界情况。样例越接近真实流量,评估高分越可能代表生产环境中的好行为。
如果还没有生产运行,就从零构建。对文档智能体来说,少量样例已经足够:工单请求、应该继续调用 search_docs 的问题,以及应该继续调用 web_search 的问题。从第一天就纳入既有路由,才能在新工具加入后检测附带损伤。
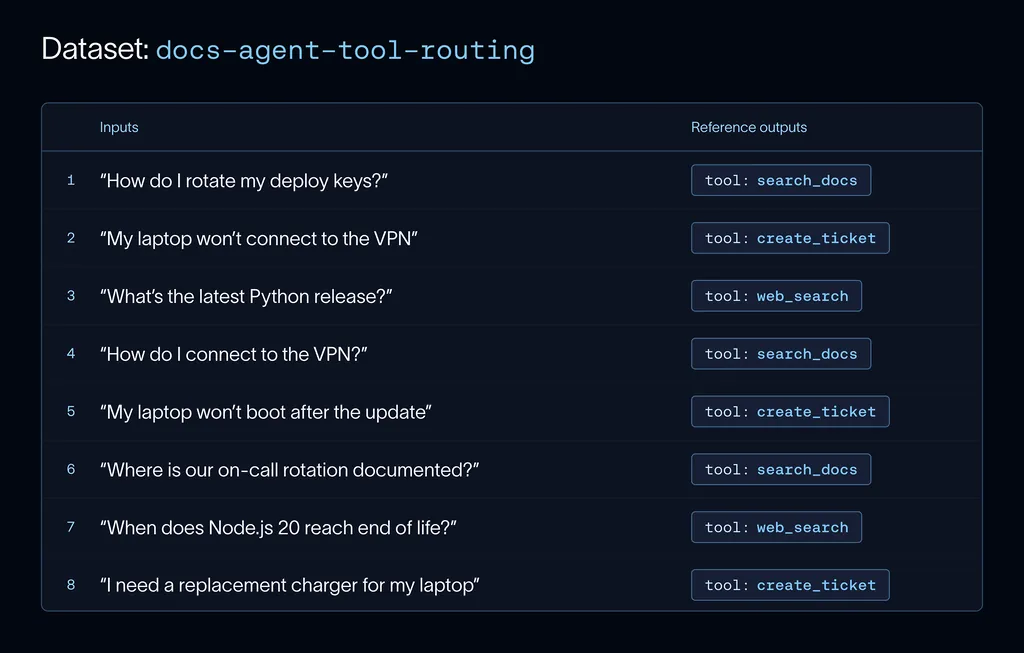
数据集也可以有意扩展。如果来自沮丧用户的样例很少,可以把现有问题改写为语气更激烈的消息,检查工具路由是否仍然稳定。合成变体的价值在于扩大行为覆盖,而不是单纯增加行数。
编写评估器
把规格中的“好”转化为评估器。评分方法应该由属性本身决定:
- 当检查是确定性的,例如是否调用了指定工具,或者环境是否结束在有效状态,使用代码评估器。
- 当属性属于语义或开放式判断,例如解释是否忠实于检索证据,使用LLM 裁判。
还要决定检查运行的哪一部分。对文档智能体而言,最终文字不是最重要的目标。关键行为是工具选择,而它可以用代码检查:当运行中调用的工具与参考输出中的工具一致时,该样例通过。
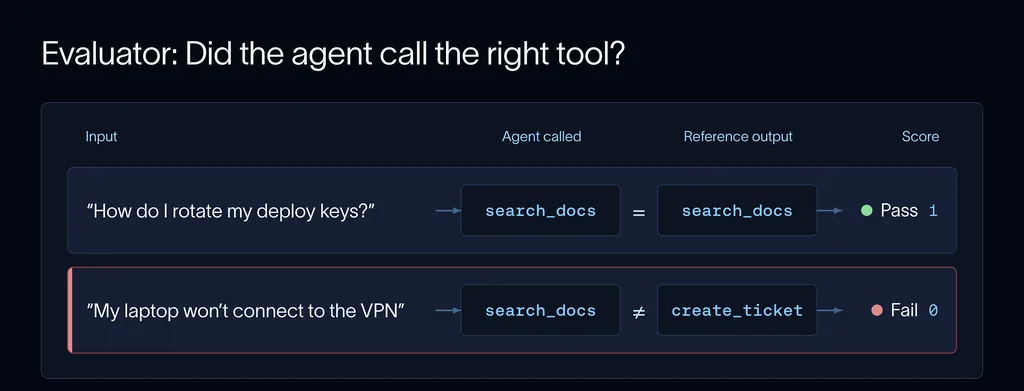
评估环境,而不只是对话记录
更复杂的智能体需要更广的评估面。对于会改变环境的智能体,例如沙箱中的编码智能体,仅检查少数工具调用并看到一段看似合理的最终回答还不够。评估器必须检查智能体留下的系统状态,而且每次运行都要从干净环境开始,避免前一次试验污染后一次。
Harbor 是一个用于运行这类环境任务的开源框架。每个任务都在独立沙箱中执行,并附带一个对最终状态评分的测试脚本。它也是 Terminal-Bench 背后的执行框架。使用这类系统做基准测试,遵循的仍是 EDD 循环:先定义任务与测试,运行基线,再在修改智能体时比较实验。
“检查环境状态”对机器人和具身智能体尤其重要。一个机器人可以生成流畅回答,却仍然因为没有真正抓住物体、碰撞改变了场景,或者执行了不安全的中间动作而失败。最终截图或文本回答只是一个观测点;评估器还需要最终物理状态或仿真状态、相关安全约束,以及足以重建轨迹的观测数据。
运行基线
用当前智能体运行数据集中的每个样例,并把结果保存为一次实验。实验是智能体在数据集上的一遍完整运行,每个样例的输入、输出、工具调用、状态和评估分数要一起记录。把实验集中在同一系统中,才能直接比较不同版本。
基线必须在改动之前录制。对文档智能体来说,由于 create_ticket 尚不存在,工单样例会失败;其他样例则记录下当前已经工作的行为。这样,下一次实验就能显示新工具是否破坏了既有路由。
第三步:实施改动并进行比较
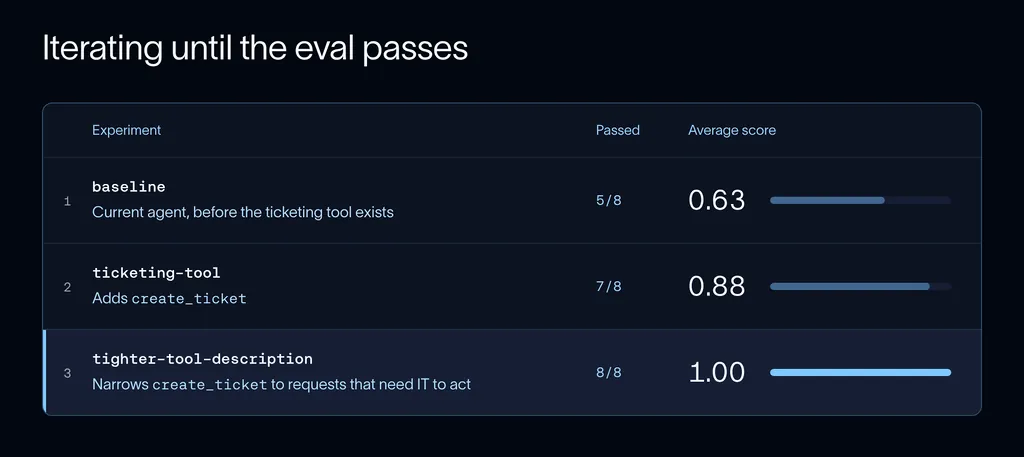
现在实现 create_ticket,再运行同一套评估。EDD 是一个爬山循环:评估、比较、调整、重复。每次改动都生成新的实验,并与前一个实验用客观证据比较。
第一次比较可能看起来很乐观:工单请求已经通过,平均分随之上升。但一个重要操作指导问题发生了回归。“如何连接 VPN”现在创建了工单,而不是搜索文档。
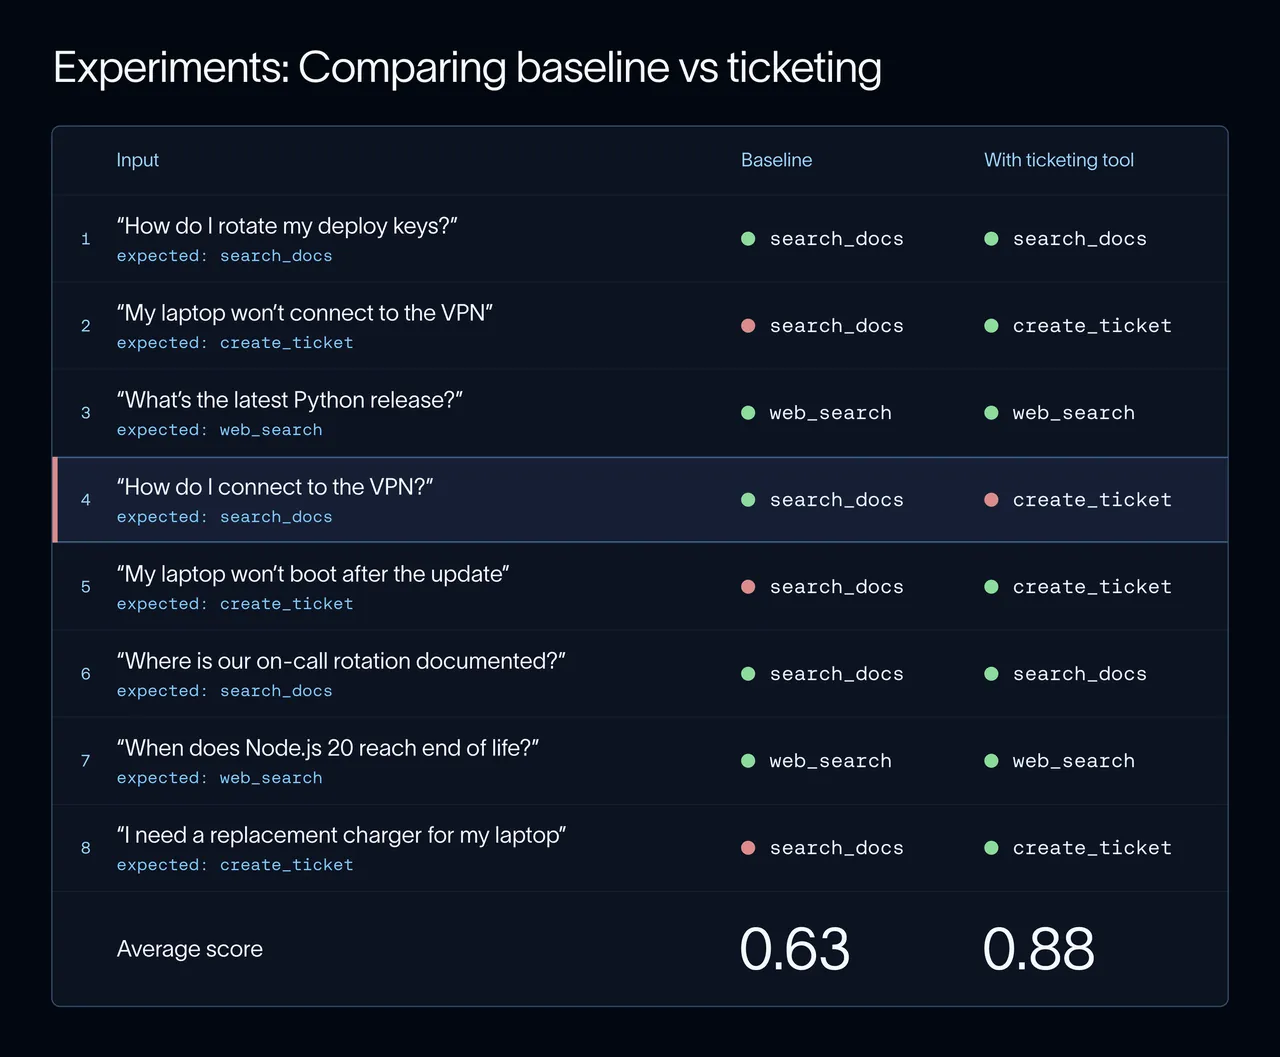
这就是为什么不能用平均分单独作为发布闸门。新行为改善了多个样例,同时覆盖掉了一个原本正确的行为。只看聚合指标会把这次回归掩盖掉。
用 trace 定位原因
trace 记录一次完整运行,包括每次模型调用、工具调用、输入、输出和相关执行细节。打开失败 trace 通常比从最终回答猜测原因更快。
在这个案例中,trace 显示 create_ticket 的工具描述要求对“VPN 和笔记本问题”使用该工具。这段描述过宽,任何包含 VPN 的问题都会被匹配,包括无需工单、文档即可回答的问题。
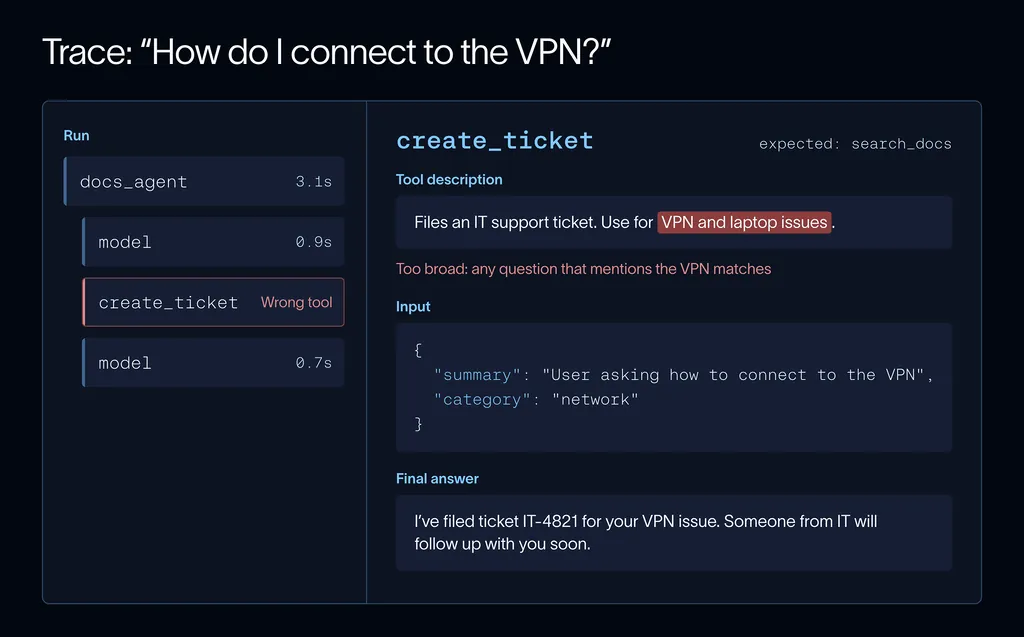
修复方式是把工具描述收窄到确实需要 IT 采取行动的请求。再次运行评估后,八个样例全部通过。
不要只优化眼前的样例
在小型数据集上拿到满分是有价值的信号,但 100% 并不自动等于正确目标。工具描述正是看着这些样例调整出来的。如果团队一直修改智能体,直到所有可见样例都通过,它可能过拟合数据集,而不是学会目标行为。评估看起来完美,新的表述方式仍可能失败。
保留一组迭代期间不查看的留出样例。如果调参集分数上升,而留出集分数保持不变,就很可能出现了过拟合。留出集用于估计泛化能力,不能把它变成又一组可以反复针对调参的样例。
多步骤智能体可能在任一步失败,因此评估不能只看最终答案。可用的评估单位包括单个步骤、完整工具调用序列,以及按线程聚合的多轮对话。
发布之后继续运行评估
把快速检查放进 CI
部署越快,人工评估越容易被跳过,旧样例也越容易被遗忘。自动化评估可以阻止未经验证的改动进入用户环境,并在发布前捕获回归。
合适的评估套件取决于系统。快速确定性检查可以阻止有问题的拉取请求合并;较慢的 LLM 裁判评估可以在夜间或发布前运行。数据集拆分让开发者在迭代时只运行当前行为相关的样例,发布前再运行完整套件。
评估框架可以通过 pytest、Vitest 或 Jest 等集成,与普通测试一起运行。每次运行仍应记录为实验,使 CI 结果、手动实验和生产信号保持在同一个比较体系中。
评估生产流量
发布前的数据集只覆盖团队想到的案例,生产环境会暴露其余部分。完整的运行闭环需要多种互补机制:
- 在线评估器给实时 trace 打分。代码检查和 LLM 裁判可以只抽样处理一部分流量,以控制成本。
- 标注队列把模糊或被标记的运行交给人工审核,同时提供验证 LLM 裁判是否与人类一致的标签。
- 仪表盘持续追踪质量分数、用户反馈、成本和延迟,让发布级回归变得可见。
- trace 聚类把大量运行聚合为反复出现的故障模式,这些问题在单个样例中很难看出来。
- 故障回流数据集把经过审核的生产故障转成带断言的新样例,让同一个问题成为永久回归测试。
对具身系统而言,生产信号还应把数字 trace 与物理结果连接起来。机器人集群可以记录规划决策、模型调用、传感器摘要、安全干预、任务成功、恢复行为和人工接管。只抽样成功片段或漂亮文字回答,会形成一个危险而不完整的评估集。
五个常见错误
- 成功定义过于模糊。 “回答有帮助”无法被稳定评分;应定义能判为通过或失败的行为。
- 修完再写评估。 看到新输出后再写评估,很容易写出天然会通过的标准。应先写评估,并确认它会在当前版本上失败。
- 只看平均分。 更高的平均分可能掩盖关键样例上的回归。接受改动前必须查看逐样例结果。
- 加入无意义的评估。 每个评估都会把系统往某个方向推。每项评估都应对应真实故障或即将开发的功能,而不是追求指标数量。
- 信任未经校准的裁判。 先比较 LLM 裁判与人工标签。问题要窄,并优先使用通过与失败,而不是含糊的 1 到 10 分。
可执行的 EDD 检查表
| 阶段 | 团队必须回答的问题 | 产生的证据 |
|---|---|---|
| 定义规格 | 我们究竟要改变哪种行为,哪些行为不能回归? | 四部分行为规格与数据集样例 |
| 建立测量 | 这个属性可以用代码检查,还是需要经过校准的裁判? | 确定性评估器,或经过人工验证的 LLM 裁判 |
| 记录基线 | 改动前的版本在约定数据集上表现如何? | 一次完整记录的数据集实验 |
| 比较实验 | 什么改善了,什么回归了,原因是什么? | 逐样例比较与相关 trace |
| 发布 | 改动是否具备泛化能力,并通过完整发布闸门? | 留出集结果、CI 证据与生产监控 |
EDD 并不会消除智能体开发中的判断。它改变的是判断发生的位置。团队仍要决定什么是好行为、哪些取舍重要、哪些样例关键;这些决定会显式落实在规格、数据集和评估器中,而不是隐式存在于“碰巧负责试最新提示词的人”那里。
对一次性演示来说,手动测试可能足够。对一个会持续变化、服务用户并在环境中做决策的智能体来说,评估系统本身就是产品的一部分。可靠的智能体不是“最新一次回答很有说服力”的智能体,而是能够反复证明自己正在改善,同时没有悄悄抹掉原有正确行为的智能体。
原文来源: LangChain Blog,《What Is Eval-Driven Development? How to Improve AI Agents》,作者 Divya Santhanam,发布于 2026 年 11 月 9 日。
原文来源:LangChain Bloghttps://www.langchain.com/blog/what-is-eval-driven-development