EmbeddingGemma 2 解读:7.4 亿参数,把图片、录音和视频变成 Agent 本地可检索的向量
Google 开源 EmbeddingGemma 2:740M 参数把文本、代码、图片、音频、视频映射进统一 768 维空间,纯文本仅 270M。本文拆解模块化加载、MRL 截维与本地 RAG 落地。
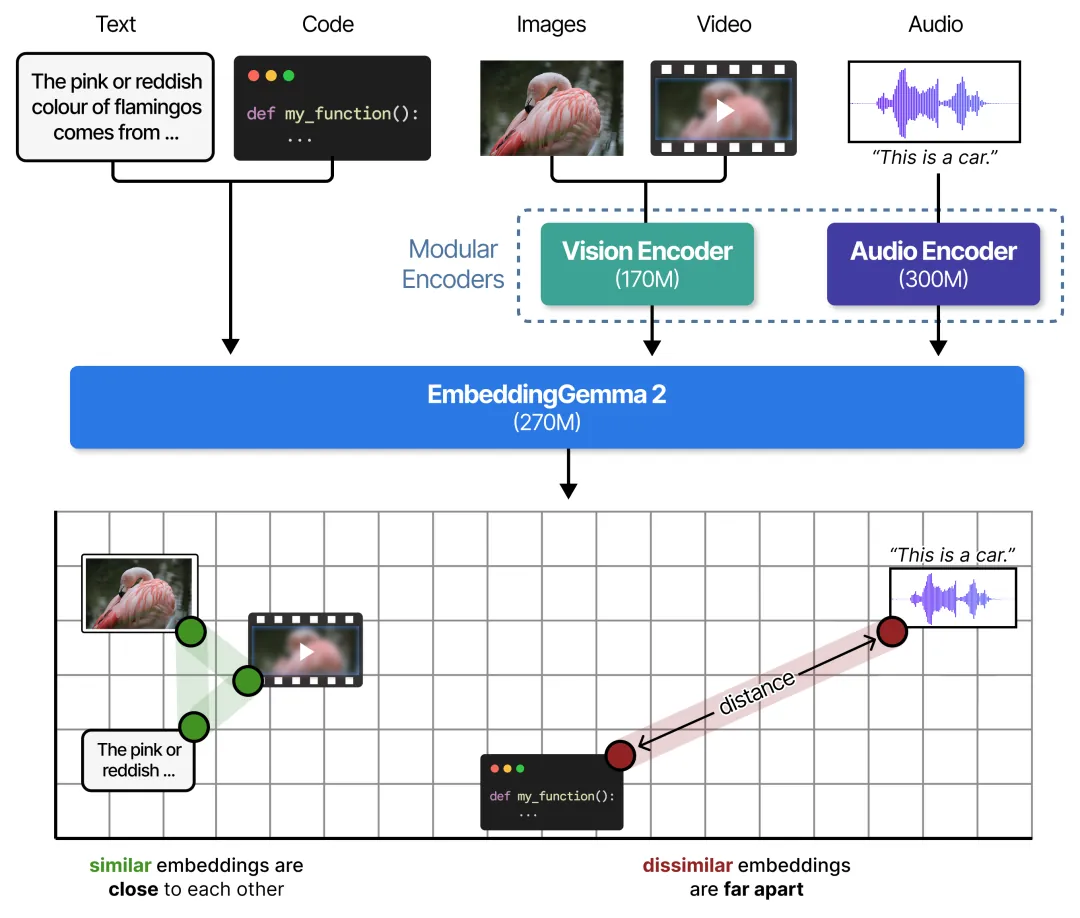
只会回答问题的 Agent 只完成了一半的工作,另一半是把答案所依赖的材料找出来。而这些材料很少是一段整齐的文字:它可能是聊天记录里的一张截图、一场四十分钟的会议录音、或者机械臂终于把接头装到位的那十二秒视频。2026 年 10 月 6 日,Google 发布了 EmbeddingGemma 2:一款基于 Gemma 4 架构、以 Apache 2.0 许可开放的多模态嵌入模型,完整版约 7.4 亿参数,把文本、代码、图片、音频和视频映射到同一个 768 维向量空间,并且是为手机与笔记本这类本地设备设计的。
先说清它不是什么。EmbeddingGemma 2 不是一个新的聊天助手,也不是装好就能接管整块硬盘的搜索软件。它是这些产品底下的那一层:把资料变成可比较向量的组件。下文所有的取舍都来自这个定位。
01 不必先把所有东西都变成文字
多模态检索的常见做法是一场接力:先给每张图片生成文字描述,把每段录音转写成文字,再把得到的文本交给文本嵌入模型。这条路线能跑通,也有不少生产系统在用;但接力的每一棒都是多一个要维护的模型、多一跳延迟,也多一次语义在转写中流失的机会。描述写的是「公园里的狗」,而查询问的是「狗接住飞盘的瞬间」——那个瞬间活在帧里,不在描述里。
EmbeddingGemma 2 提供的是另一条路:直接编码每一种模态,让图片描述模型与语音转写模型退出关键路径。搜索「海浪拍打岸边」时,候选既可以是照片也可以是声音素材,与同一条查询向量排序比较。这是字面意义上的跨模态检索,也带着一个诚实的前提:语义相近不等于必然命中,某些查询依然会漏,而漏检率正是你在自己语料上必须先量出来的东西。
架构上的重点不是「每种模态都输出 768 个数」——任何投影头都做得到。重点是这些表示经过对齐:查询向量与片段向量之间的余弦相似度跨模态成立,这才让一份索引服务所有文件类型。
这里有一个被宣传口径模糊掉的概念需要拆开。官方把 PDF、幻灯片与图表列在它支持的视觉文档里,但这不等于每条接入路径都能直接接收 .pdf 文件。实际接入时,你要把页面渲染成图片、或把文本抽出来,再编码接口真正接受的东西。省掉描述模型,省的是生成式中间环节,不是文件解析、图片缩放与视频抽帧。
02 7.4 亿是完整版,纯文本只需要 2.7 亿
模型是模块化的,而模块化正是一个 7.4 亿参数的多模态嵌入模型能装进手机的原因。基础文本模块约 270M 参数,视觉编码器约 170M,音频编码器约 300M;你的负载碰到哪个编码器,才加载哪个:
| 使用场景 | 加载的组件 | 参数规模 |
|---|---|---|
| 文本、代码检索 | 文本模块 | 270M |
| 文本、图片、视频帧检索 | 文本模块 + 视觉编码器 | 440M |
| 文本、音频检索 | 文本模块 + 音频编码器 | 570M |
| 完整多模态检索 | 全部三个组件 | 740M |
这些配置来自同一个检查点、共享同一个向量空间,于是出现一种有用的不对称:用便宜的纯文本配置编码查询,去匹配用完整多模态配置建立的索引。搜索框不该因为语料里有录音,就为音频编码器付内存。
Google 给出了量化版本在设备上的具体数字:Pixel 11 Pro 上,纯文本权重的活跃内存占用可低至约 191MB,完整多模态模型约 567MB。请按它的本义读这两个数:它们描述的是一台设备、一种量化配方下的活跃权重。媒体处理管线、推理运行时、向量索引,以及并行运行的生成模型,都另外计费。「567MB 的模型」装在 4GB 预算里,与「567MB 的应用」不是一回事。
上下文是共享预算,不是每种模态各自的额度。模型接受 8,192 token,是第一代 EmbeddingGemma 的四倍;按官方默认设置,大致装得下 29 张图片、58 个视频帧或约 5.5 分钟音频。混合输入由各个部分共同分配同一份预算,所以一小时的录音、一部电影长度的视频,仍然要分段建索引。MRL 与模块化都改变不了这条算术。
03 向量索引也可以更小:套娃表示学习
模型权重是一次性下载,向量索引才是会一直长大的那部分。EmbeddingGemma 2 采用套娃表示学习(Matryoshka Representation Learning, MRL):训练时强制向量的前缀维度自身就携带意义,于是 768 维嵌入事后可以截短为 512、256 或 128 维。截短之后必须重新归一化,而且查询侧与索引侧必须采用相同维度——否则你比较的是两个不同空间里的向量。
| 维度 | 100 万条 float32 向量的裸存储 | 相对 768 维的压缩 |
|---|---|---|
| 768 | 3.07 GB | 1.0x |
| 512 | 2.05 GB | 1.5x |
| 256 | 1.02 GB | 3.0x |
| 128 | 0.51 GB | 6.0x |
算术是「条数 × 维度 × 4 字节」,并且只覆盖向量本身:不含索引结构、元数据与原始媒体。官方说的「最多缩小 6 倍」指的正是这一项——对本地向量库来说它常常是大头,但它不是「整个应用缩小六倍」的承诺。
压缩不是免费的,模型卡也写得很直白:128 维会明显损伤多模态质量,更适合文本优先的负载。合理的选型流程并不花哨:先用 768 维建基线,在自己的查询上量召回;再跑 512 与 256 维,留下能守住召回下限的那一档。图片、视频与音频检索,尤其不该为了一个存储数字被牺牲掉。
04 代码检索是真正的涨幅;基准分数不等于准确率
| 基准 | EmbeddingGemma(第一代) | EmbeddingGemma 2 | 变化 |
|---|---|---|---|
| MTEB Code | 68.76 | 78.68 | +9.92 |
| MTEB 多语言 | 61.15 | 61.36 | +0.21 |
把这两行放在一起读,故事是具体的而不是笼统的:多语言文本能力基本持平,代码检索跳涨近十分。这不是一份「全面提升」的新闻稿。真正值得关注的涨幅是代码,加上新增的多模态覆盖;而代码涨幅带着最直接的产品后果——本地代码库索引、语义代码搜索、以及编码 Agent 的检索层。
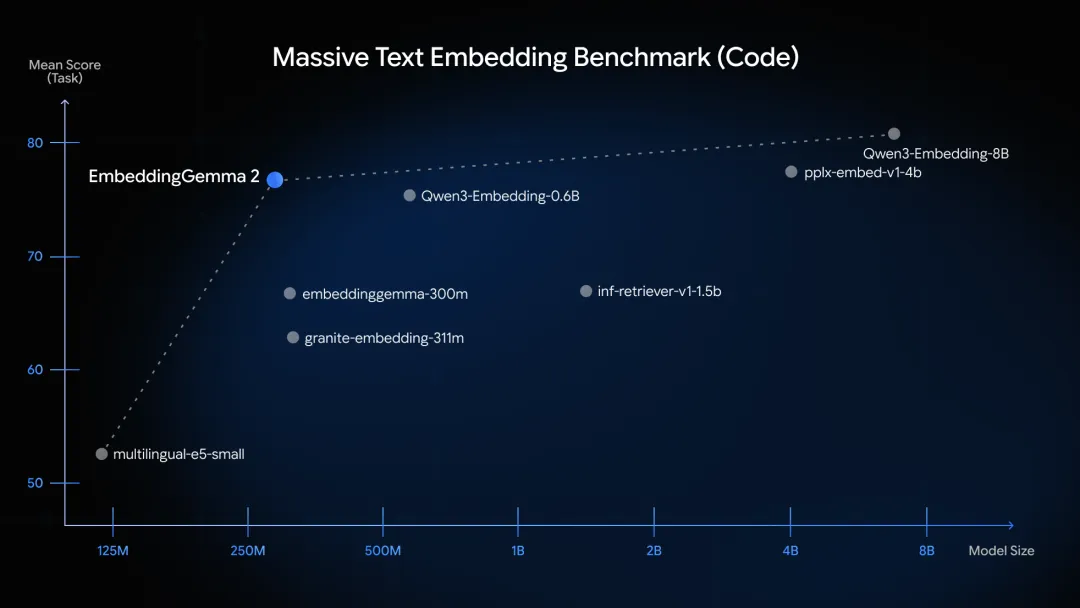
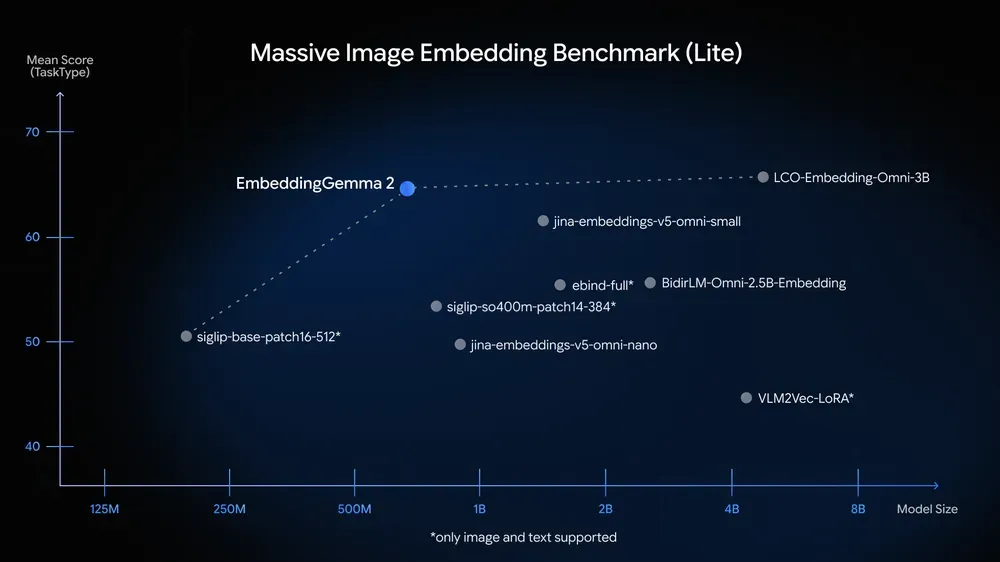
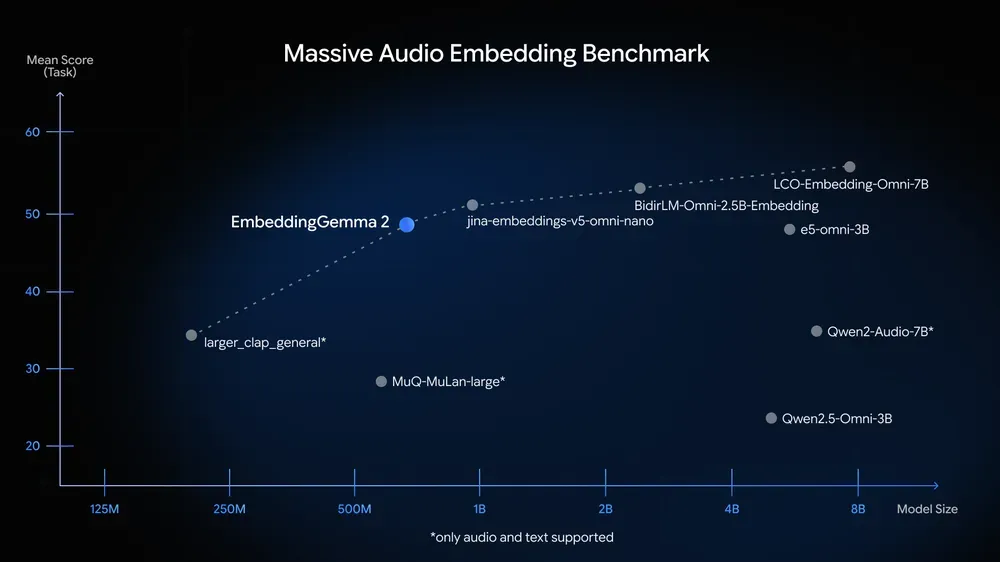
对落地项目而言,把问题从榜单上移开更有用:在相同的延迟与内存预算下,它能否找回你现有栈漏掉的资料?用自然语言描述一个功能,能否搜到对应实现?问一个实验结果,能否找到论文第九页的那张图?一段录音能否被定位到足够短、足够相关的片段,交给生成模型去读?这三个问题比任何公开基准都更适合做测试集,而且用你自己已有的材料就能便宜地搭起来。
05 对 Agent 的价值,是扩大「可检索的上下文」
Google 随发布给出了参考应用,形态很说明问题。AI Edge Gallery 里的 Instant Media Search 用文本或图像查询对本地图库排序;Video Moments Finder 用文本或音频查询定位视频里的时刻;macOS 上的 AI Edge Foresight 则把 EmbeddingGemma 2 与 Gemma 4 配在一起,做本地会议辅助与资料检索。由于嵌入模型建在 Gemma 4 之上、共享同一文本 tokenizer 与音频编码器,两个模型可以作为一条管线运行,合计内存 footprint 低于两个互不相干的模型。
从这些例子往前一步,就是一种科研助手的设计:把论文页面、实验截图、会议片段与代码文件分别建成索引,再让一条查询跨所有集合召回。问「上周讨论的那套检索方案,有哪些实现与实验依据」,系统可以在一份排序列表里同时返回代码 diff、会议片段与结果图表,而不是只搜到某人当初写下的摘要。
flowchart LR
  Q["查询:文本或代码"] --> TB["文本模块 270M"]
  I["图片 / 视频帧"] --> VE["视觉编码器 170M"]
  A["音频"] --> AE["音频编码器 300M"]
  TB --> BB["共享骨干"]
  VE --> BB
  AE --> BB
  BB --> V["768 维向量,MRL 可截至 512/256/128"]
  V --> IDX["本地向量索引"]
  Q --> QV["查询向量:纯文本配置"]
  QV -->|"余弦相似度 top-k"| IDX
  IDX --> HIT["召回片段:带来源、页码、时间戳"]
  HIT --> G4["Gemma 4 读证据并组织答案"]
这张图也标出了嵌入能买到的边界。检索与理解仍是两步:嵌入模型输出向量,而向量不会读证据、不会组织答案。Google 自己的本地 RAG 配方把分工写得很明确——EmbeddingGemma 2 负责检索,Gemma 4 负责推理。工程上的后果很具体:保留原始文件,保留每个片段的权限、页码与时间戳,并把真正的内容交给具备相应模态能力的模型。向量相似不等于证据成立;检索到视频也不等于理解了视频。
06 最小示例:用一句话同时匹配图片和声音
官方开发者指南给出了 Sentence Transformers 的调用路径,多模态加载器要求 6.1.0 或更高版本。最小的诚实示例是:在脚本旁放一张图片和一个音频文件,编码一条文本查询,再给两种媒体打分。
pip install -U "sentence-transformers[image,audio,video]>=6.1.0" transformersfrom pathlib import Path
import torch
from sentence_transformers import SentenceTransformer
# 替换为自己的本地文件。
media = {"image": Path("beach.jpg"), "audio": Path("waves.wav")}
for path in media.values():
if not path.is_file():
raise FileNotFoundError(f"缺少媒体文件:{path.resolve()}")
use_cuda = torch.cuda.is_available()
device = "cuda" if use_cuda else "cpu"
dtype = (
torch.bfloat16
if use_cuda and torch.cuda.is_bf16_supported()
else torch.float32
)
model = SentenceTransformer(
"google/embeddinggemma-2",
device=device,
model_kwargs={"torch_dtype": dtype},
)
query = model.encode(
"海浪拍打岸边",
prompt_name="SearchQuery",
normalize_embeddings=True,
)
for modality, path in media.items():
candidate = model.encode(
{modality: str(path)},
normalize_embeddings=True,
)
score = model.similarity(query, candidate).item()
print(f"{path.name}\t相似度:{score:.4f}")这段代码不生成图片描述,也不把音频转成文字:比较完全发生在向量空间里,打印出来的数字是语义相似度,不是「匹配正确的概率」。要把它变成搜索系统,还需要保存候选向量、建立索引并做排序——而第 03 节的 MRL 维度选择,正是从这一步开始变得重要。
有两个部署细节容易被忽略、重新发现时代价又很高。其一,官方要求 bfloat16 或 float32:直接改成 float16 可能出现 NaN 或静默的质量下降。其二,这个示例是桌面路径、全精度权重;第 02 节的 191MB 与 567MB 描述的是量化后的设备端构建,与这个进程的常驻内存无关。
最后带走什么
EmbeddingGemma 2 没有让 Agent 更会说话,它让资料中非文字的那一半变得可找——对多数真实助手而言,这恰恰是更难的一半。一个小的开放模型、一个对齐的五模态空间、加上一份设备端的内存画像,合起来是一条不必把语料送出去就能跑的检索路径。剩下的工作从来都是你自己的:定义你的查询里「相关」意味着什么,在截短维度之前先量召回,并保住从向量回到文件、页码与时间戳的证据链。
来源:ChallengeHub 微信公众号原文《Google 开源 EmbeddingGemma 2:7.4 亿参数,让 Agent 在本地搜图片、录音和视频》(mp.weixin.qq.com/s/nGMVHB7po_tkitfc4RKWUw);Google 官方公告《EmbeddingGemma 2: an open, lightweight multimodal embedding model》(blog.google,2026-10-06);Hugging Face 模型权重与模型卡(litert-community/embeddinggemma-2-740m-litert-lm)。文中配图为原文转载的 Google 官方图。
原文来源:ChallengeHub (WeChat)https://mp.weixin.qq.com/s/nGMVHB7po_tkitfc4RKWUw