Dream Machines 实证报告:在真实制造任务上微调 π0.5 的 11 组实验
Dream Machines 在双臂执行器装箱-插盘任务上微调 π0.5:21 小时数据 76%,加一个干净小时到 90%,仅调 RTC 服务设置到 93%,而 LoRA 与从头训练都远不及全量微调。
通往通用机器人的道路,要穿过真实工作场所里一个个具体任务的落地部署。当领域里的大多数工作在优化"一个策略把很多任务都做得还行"的通用策略时,部署需要的是机器人能把某一个任务做到足够可靠、可以无人值守地运行。在 Dream Machines,我们专注于把这个差距补到 100%,并且不绑定任何特定模型。这篇文章分享我们最近的一部分实验结果。
截至目前,真实机器人领域最强的开源视觉-语言-动作模型(VLA)仍然是 Physical Intelligence 的 π0.5(参见 RoboDojo 真实世界排行榜,2026 年 8 月),也是我们本文关注的对象。无论是论文还是官方 GitHub 仓库都没有给出微调建议,其他使用该模型的公司也没有公开结果;据我们所知,唯一的高质量参考是 Hugging Face 的 Unfolding Robotics 博客。我们记录在一家德国制造商的真实任务上微调 π0.5 的实证发现,目的是帮后来者省下反复调参的时间,并为更好的数据采集提供依据。
任务、数据与评测协议
1.1 任务
执行器(actuators)以纸箱形式到货,需要被转移到一个托盘中,托盘会固定它们的位置与朝向,供下游产线使用。每个执行器插入时底部触点必须朝向正确,两种相差 180° 的旋转都可接受。在这批初始实验中,我们只使用源箱的最上层:40 个执行器,既提供足够的多样性与评测样本,又保持迭代速度。
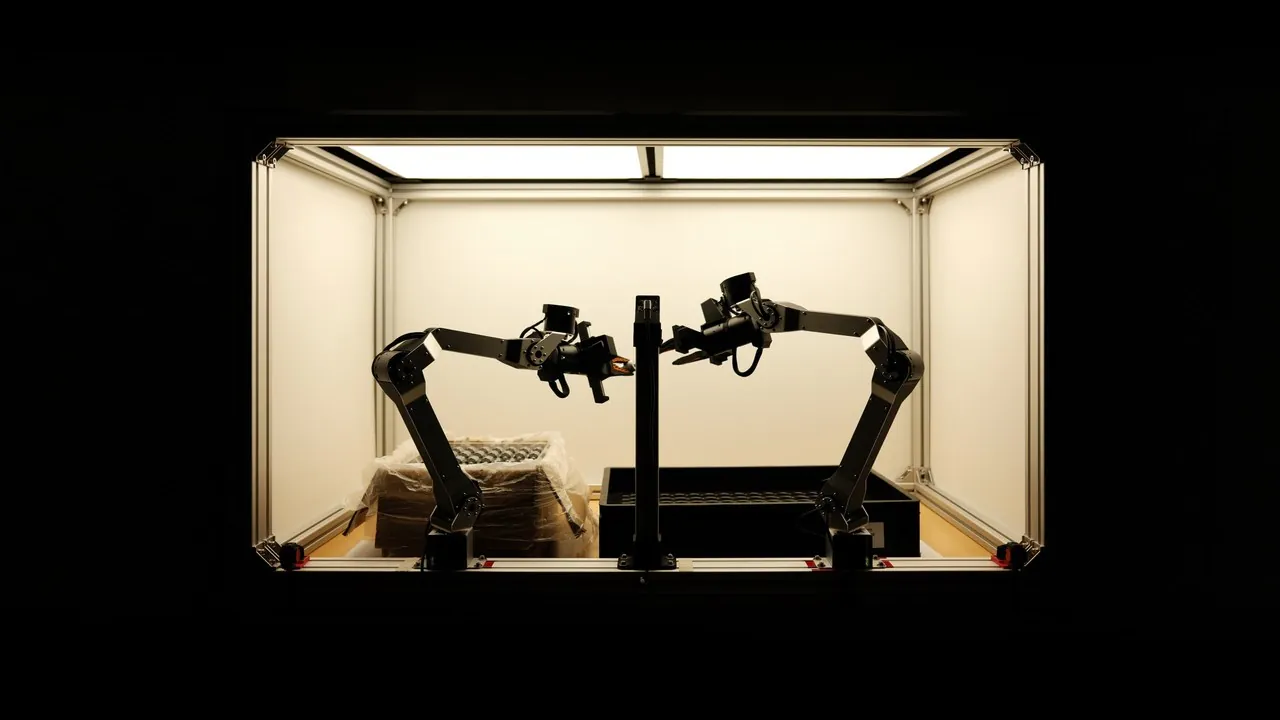
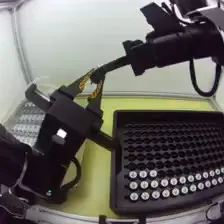
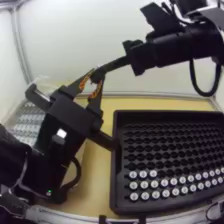
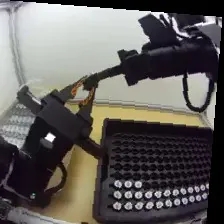
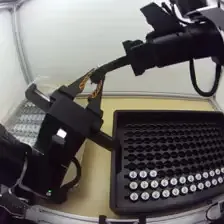
该任务需要两条机械臂:既要覆盖整个工作空间,也要在插入前重新调整执行器姿态。左臂从箱中拾取执行器并递交给右臂,右臂将其插入托盘 135 个孔位(9 行 × 15 列)之一。顺序是固定的:执行器从箱中按从右到左、从下到上离开,托盘则按从左到右、从下到上填充。这个任务今天就在我们正洽谈的一家德国制造商的工厂里执行。图 1 展示一个训练回合在三台机架相机下的画面。
1.2 数据采集与过滤
我们在双臂 TRLC-DK1 工作站上以 50 Hz 录制,使用三台鱼眼相机(2 台腕部、1 台全局),分辨率 640×480,MJPG 格式。两名遥操作员分别使用 Gello 主手臂和 VR 头显采集数据(我们也在 GitHub 开源了 VR 遥操作套件),数据在四张办公桌与一个灯箱之间均匀分配。采集覆盖不同光照条件,白天与夜间都有。箱子与托盘的位置在约 11×11 cm 的区域内独立随机化。操作员在每个回合中都遵循 1.1 节固定的取放顺序。
每个回合按 1 到 5 分评级:1 分是不可恢复的失败;2 分是需要纠正的明显失误;3 分是轻微失误,例如碰到相邻执行器;4 分是带有小瑕疵的干净回合;5 分是干净的执行。图 2 给出每个评分等级的一条标定片段。
每个回合都以静止位姿开始和结束。部署系统会省略这一点,但这里保留它是为了简化实验、便于相互比较。
预处理非常少:只保留评分 3 及以上的回合,裁掉首尾的空闲时段,并把每帧中心裁剪到 224×224,与 π0.5 的 SigLIP 编码器输入尺寸一致。过滤后数据集包含 7,271 个回合、共 21 小时。本文用到的所有数据集都在 Hugging Face 上公开(附录表 3)。图 3 展示评分在两名操作员之间的分布:两人都有超过 80% 的回合评为 5 分,过滤器总共剔除不到 100 个回合。图 4 展示裁剪后的回合时长分布:多数回合为 8 到 12 秒,两名操作员速度相近。
1.3 评测协议
所有评测都在灯箱中进行,箱子放在随机化区域的中心。顶层 40 个位置各评测一次,即每轮评测 40 次 rollout。部分实验做了多轮评测(一轮即顶层全部 40 个执行器),以降低不确定性。
主指标是二值成功率。此外我们记录每个回合的进度,即策略走到了哪一步,共分五个阶段:(1) 在抓起执行器之前失败;(2) 抓起了正确的执行器;(3) 干净完成交接,右臂保持抓取至少一秒;(4) 插入正确的孔位、两边都进去但倾斜或朝向错误;(5) 以正确朝向干净插入。每个阶段都以前面所有阶段为前提,因此抓错执行器但插对孔位算失败,偏离固定顺序也算失败。图 5 展示每个阶段各一条 rollout。
一条 rollout 在 45 秒后结束;若策略 10 秒没有任何进展、或明显卡在无法恢复的状态,则提前结束。这带来一定主观性,我们接受它:等一个注定失败的策略跑完,浪费的是我们更想用来做试验的时间,而且其影响相对 n = 40 的噪声底很小。
评测默认开启 Real Time Chunking(RTC)(Black et al., "Real-Time Execution of Action Chunking Flow Policies", Physical Intelligence, 2025,arXiv:2506.07339),即 Physical Intelligence 的异步服务方案:上一个动作块还在执行时就生成新的动作块,并与其混合。2.10 节描述并调整这些设置。模型默认超参数见附录表 2。
实验结果
除非另有说明,我们在全部 21 小时数据上微调 π0.5,采用 warmup-stable-decay(WSD)学习率调度,共 50k 步,其中最后 10k 步做二次退火。参照 Hugging Face 的叠衬衫文章,批大小设为 256;考虑到我们的学习率调度不同,最大学习率从 1e-4 降到 5e-5。下文成功率的误差棒为该柱 n 次 rollout 的二项 95% 置信区间(CI,Wilson score),n = 40 时约 ±15 个百分点。原文中每张图都可切换到进度视图,即按到达的最远阶段统计的回合占比(1.3 节)。
2.1 成功率很早就进入平台期,验证误差区分不了 checkpoint
第一个问题很简单:微调需要训多久?
π0.5 自带余弦退火调度,把学习率与总步数预算耦合在一起,使不同长度训练运行的 checkpoint 难以比较。我们改用 WSD 以获得更干净的对比。
我们训练了一个单一模型,在稳定学习率下跑 210k 步、只对最后 10k 步退火,并每 10k 步以 n = 40 评测一次。图 6 显示结果:成功率在约 30k 步前快速上升,随后进入带强振荡的平台期。其中没有任何证据支持训练超过 30k 步。
尽管如此,本文其余所有运行仍训练 50k 步。我们第一遍检查这些 checkpoint 时(后来把混淆因素追溯到夹爪塑料件的形变,见这条推文,并重跑了全部评测),曾以为成功率在 50k 步时仍在上升,并据此把"50k 步 + 退火"定为预算。等重跑结果显示那次上升是假象时,大部分训练已经启动,于是我们保留预算而没有重做。因此,后文作为基准的 76% 并不是这条阶梯上的某个 checkpoint:它是按上述配方单独跑的一次 50k 步运行(最后 10k 步退火),经过三轮评测(n = 120)。
在 210k 步阶梯(图 6)中,0k 点是微调前的预训练模型,完全不会做这个任务。20k 步之后,端到端(E2E)成功率在 32.5% 到 75% 之间来回跳动、没有趋势,围绕阶梯均值 53% ± 15 pp(对所评测 checkpoint 取 ±1.96 二项标准差)。
参照 Allshire et al.("Scalable Behavior Cloning with Open Data, Training, and Evaluation", 2026,abc.bot),我们在留出的 5% 回合上记录验证动作误差(生成动作块与真值动作块的 L2 距离)。我们发现它对判断训练何时开始饱和非常有用,但如图 7 所示,它在此之外并不能指示性能,最可能的原因是我们的评测样本量无法可靠分辨模型间的微小差异。用验证误差对机架成功率做普通最小二乘(OLS)拟合,在全部 checkpoint 上只能解释约五分之一的方差;去掉最早的两个 checkpoint(它们同时具有最高误差与最低成功率)后几乎解释不了任何方差。验证损失(同一留出回合上的 flow-matching 目标)表现更差:它在整个训练过程中持续上升,而成功率保持平稳。
回答开头的问题:在我们的设置下,21 小时数据、批大小 256、约 30k 步就足够了;训得更久、或用验证误差/验证损失挑 checkpoint,都买不到任何 40 次 rollout 的评测能看见的收益。
2.2 LoRA 远不及全量微调,即使 rank 256
π0.5 的全量微调需要约 37 GB 显存,因此需要数据中心级 GPU。我们办公室里是 32 GB 的 RTX 5090,于是想知道能否在这些卡上训练。低秩适配(LoRA)只训练小的低秩适配矩阵来表示权重更新,在我们使用的 rank 64 下只需 18 GB。表 1 展示它随 rank 的扩展情况。在 5090 上,编译后的模型技术上可以以批大小 4 训练,不编译时约 39(显存与速度数字来自我们在六种 GPU 上的单卡 π0.5 基准:RTX 5090、RTX PRO 6000、A100-40/80、H100、H200)。梯度累积可以把塞进 GPU 的批大小变成任意有效批大小(EBS)用于梯度更新。
| Rank | 可训练参数 | 峰值显存 |
|---|---|---|
| 16 | 38M(1.1%) | 17.1 GB |
| 32 | 76M(2.3%) | 17.3 GB |
| 64(我们的) | 151M(4.5%) | 17.9 GB |
| 128 | 303M(9.0%) | 18.7 GB |
| 256(我们的) | 605M(18.0%) | 20.7 GB |
| 512 | 1.21B(36.1%) | 30.0 GB |
| 全量微调 | 3.35B(100%) | 任何 batch 之前约 37 GB |
表 1:按 LoRA rank 划分的可训练参数与峰值显存。LoRA 加在视觉-语言模型(VLM)与动作专家的每一个线性层上,与我们的运行一致。峰值显存是在 RTX 5090 上、批大小 8、不编译、开梯度检查点,测五个训练步得到。全量微调的 37 GB 只是静态开销(权重、梯度与 AdamW 状态),不含任何 batch 的激活。
Jon Schulman 的工作(Schulman et al., "LoRA Without Regret", Thinking Machines, 2025 年 9 月,thinkingmachines.ai/blog/lora)认为:只要把 LoRA 应用到所有层、并选取足以吸收数据信息的 rank,LoRA 在 LLM 上可以达到与全量微调相同的性能。我们训练了三个满足这些条件的实验臂,全部采用 all-linear 目标(三个臂的适配器缩放因子 lora_alpha 均为 32;LoRA 把适配器更新乘以 α/r,即 alpha 除以 rank,因此改 rank 时要固定 alpha。我们第一次 rank-256 尝试把 alpha 随 rank 缩放到 128、保持 α/r 不变,在 Adam 下这会把适配器上的有效步长放大约 √(r₁/r₀);其梯度范数从约 110k 步开始指数增长,该运行被放弃。alpha 32 的 rank 256 训练正常)。第一个臂保持 EBS 256,在 rank 64 上采用推荐的 10 倍学习率乘子(5e-4,对比我们全量微调默认的 5e-5),即约 150M 可训练参数对 21 小时数据集。由于 Schulman 也发现 LoRA 不擅长大批大小,第二个臂把 EBS 降到 64、按平方根缩放学习率到 2.5e-4,保持总样本量不变(200k 步对 50k 步)。第三个臂保持该批大小、把 rank 推到 256(约 600M 可训练参数),检验适配器容量是否是约束瓶颈。
三个臂都没能弥合差距(图 8)。rank 64 下,EBS-256 臂落在 45%,EBS-64 臂落在 32.5%,对比全量微调的 76%。更小的批大小让结果更差而不是更好。rank 256 是三者中最好的,52.5%,仍比全量微调低 23 pp,正好处于 40 次 rollout 评测能分辨的边缘(1.3 节)。值得注意的是,rank-256 模型看到的样本只有另外两个臂的一半(批 64 跑 100k 步,6.4M 对 12.8M;我们在 100k 步停掉了 rank-256 运行,因为其验证动作误差已饱和,再花两倍算力在一个明显平台期的运行上不值得)。rank 256 + EBS 256 是我们唯一没试的组合,也是下一个自然的 LoRA 实验。
| 实验臂 | Rank / EBS / 步数 | E2E 成功率 |
|---|---|---|
| 全量微调(基准) | - / 256 / 50k | 76% |
| LoRA,10 倍学习率 | 64 / 256 / 50k | 45% |
| LoRA,平方根缩放学习率 | 64 / 64 / 200k | 32.5% |
| LoRA,高 rank | 256 / 64 / 100k | 52.5% |
表 1b:LoRA 与全量微调的 E2E 成功率(图 8)。rank-256 臂训练的样本量只有其他三个臂的一半(6.4M 对 12.8M)。
我们假设 LoRA 更新不够用,是因为我们的本体(embodiment)不在 π0.5 的预训练数据中:适配一台新机器人并不是 LoRA 所假设的那种小的低秩修改。我们没有继续 pursue 这条线。出于时间考虑,训练本来就在云上跑,而 LoRA 在云上几乎没带来什么:rank-64 EBS-256 臂比全量微调少用约 10% 的 GPU 小时;而在四张 H100 上把 EBS 对齐到 64 时,适配器每步反而比全量微调更慢(rank 64 为 0.90 步/秒、rank 256 为 0.65,对比 0.95)。适配器省的是优化器显存,不是算力。
2.3 在测试范围内对学习率与批大小不敏感
接下来我们问:微调对学习率和批大小有多敏感?我们跑了同时变化这两个超参的实验,没有看到改进,也没有看到统计显著的恶化(图 9 与图 11)。模型在测试范围内对这两个设置都显得稳健。与 Hugging Face 文章一致的批大小 256、以及我们按 WSD 调整后的学习率 5e-5 对我们效果最好;尽管 1e-4 那次运行(三者中成功率最低)达到了最低的训练损失(图 10)。
关于样本量对齐的批大小阶梯(图 11):BS 64 以 lr 2.5e-5 跑 200k 步,BS 2048 以 lr 1.41e-4 跑 6,250 步(平方根缩放),BS 256 为基准。
2.4 相对关节目标与图像增广都没有改变什么
π0.5 预测绝对关节目标。常见的替代方案是预测相对当前关节状态的增量(delta),它把动作分布重新居中到零附近,使其与手臂当前处于工作空间何处无关。我们按这种方式重训了基准,夹爪保持绝对控制(delta 是相对实测夹爪开度取的,而夹着零件的夹爪永远不会读作"闭合",因此零 delta 意味着"保持零件宽度的夹持"并松开挤压力,而"完全闭合"则是无论夹着什么都相同的指令)。
另外,我们测试了图像增广,我们的配方默认不开它。LeRobot 的默认流水线从六种标准光度与几何变换中每帧随机抽三种、按固定顺序、各以随机强度应用(LeRobot 默认 image_transforms:亮度、对比度、饱和度与色调抖动、清晰度抖动、以及小幅随机仿射 ±5° 与 5% 平移;六种中每帧抽三种并按该固定顺序应用)。附录展示每种变换对训练帧的作用(图 26)以及完整流水线之后模型看到的画面(图 27)。
两者都没有带来可测量的差异(图 12)。相对关节目标达到 73%,图像增广 75%,对比基准的 76%。两者都远在 n = 40 的噪声底之内,因此本文其余所有运行保持绝对关节目标、不做增广。注意这是在数据采集的同一设置下做的评测;当部署场景与训练场景不同时,增广仍可能带来收益。
2.5 操作员之间的微小差异产生了非常不同的策略
我们训练三个模型来评估操作员与采集接口的影响:一个用操作员 1 的 10 小时、一个用操作员 2 的 10 小时、一个用等量采样的 10 小时混合数据。这一比较把操作员与接口混淆在一起,因为操作员 1 使用 VR 遥操作,操作员 2 使用 Gello 主手臂。
在操作员 2 数据上训练的模型比操作员 1 的模型低超过 30 pp(图 14),主要原因是交接失败。一旦交接成功,回合的其余部分两者相当。混合模型看起来主要继承了操作员 1 的交接策略,而不是融合两种行为,这解释了它为何表现相近。VR 与混合彼此在噪声范围内。值得注意的是,操作员 2 的交接行为源于 Gello 手臂的外形:它迫使操作员绕着手臂伸手,从而约束了动作。图 13 并排展示两种交接风格。
2.6 五倍数据把成功率从 63% 提到 76%
我们的目标是用一天的数据训出可部署的策略,因此评测了性能随数据集规模的扩展。我们在嵌套的 4 小时、10 小时、21 小时子集上训练,每个子集在操作员与工作位之间等量采样。
4 小时与 10 小时模型表现相近,21 小时模型更好(图 15)。但正如后续实验所示,数据的类型比数量更重要。
2.7 五个场景的 4 小时,比评测场景内的 4 小时高 30 pp
Shi et al.("Is Diversity All You Need for Scalable Robotic Manipulation?", 2025,arXiv:2507.06219)发现场景多样性比数据数量更重要。我们对此做了检验:比较两个 4 小时模型,一个只用灯箱数据训练(全部实验使用的评测设置),一个在四张办公桌、灯箱与两名操作员之间等量采样训练。图 16 展示五个场景。
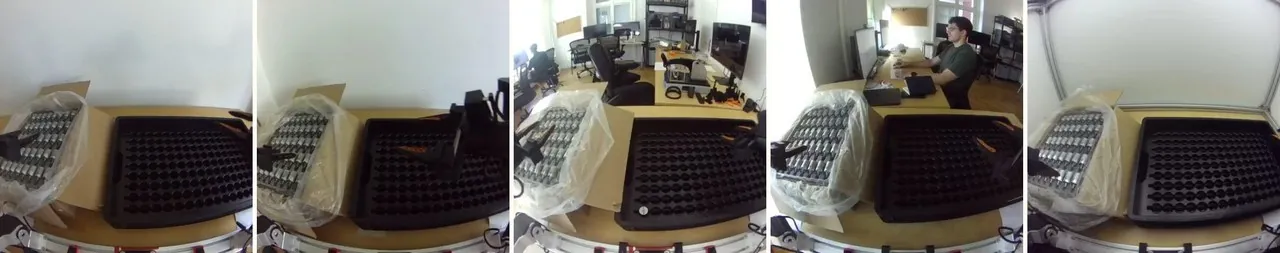
多样化模型比单一场景模型高 30 pp(图 17),尽管后者完全在评测环境中训练。30 pp 的差距具有统计显著性:对 50/80 成功(五场景)与 13/40(仅灯箱)做双侧 Fisher 精确检验,p = 0.0034。
2.8 在 21 小时之上加一个干净小时,把性能从 76% 提到 90%
多数失败发生在交接阶段。遥操作时我们养成了极快交接的习惯。常见失败是左夹爪在右夹爪闭合之前就松开,导致执行器掉落。把执行器重新捡起的恢复回合被标为 2 分,因此我们"3 到 5 分"的过滤器恰好把所需的恢复行为删掉了,而一次交接失败几乎总是意味着整次试验失败。我们还发现许多标为干净的回合其实并不完全无瑕。
为检验数据质量的影响,我们在灯箱中额外采集了一个小时、带严格约束的数据:全程速度一致、插入时越过托盘边缘(图 18)。这意味着平均回合时长大约翻倍。我们以两种方式使用它:只用这份数据从头微调 π0.5 10k 步;以及从 21 小时/50k 的 checkpoint 继续训练 5k 步、最后 1k 步退火、学习率降到 2e-5。
在这一个小时上微调 21 小时策略,把成功率从 76% 提到 90%(图 19)。从 π0.5 基础模型只用这一个小时训练,达到 28%,与仅灯箱 4 小时模型相差 5 pp 以内,而数据量只有后者的四分之一。虽然仍远低于 4 小时多样化模型,但它有力支持了那句机器学习老话:数据质量比数量更重要。
2.9 240 次带干预的 rollout,把 1 小时策略从 28% 提到 88%
数据集聚合(DAgger)式数据采集是少数被反复复现、并持续证明能提升策略性能的方法之一。受上一节结果启发,我们想知道一小份高质量数据能走多远,于是向 1 小时数据集中加入人工门控的干预数据(更多 human-in-the-loop 数据采集实验见 Arnold, "Human-in-the-Loop Data Collection", 2026,aurelarnold.xyz)。我们刻意从"1 小时从头训练"的策略出发,而不是从 21 小时 + 1 小时模型出发:问题是极少量的数据能买到多少性能。
我们让 1 小时从头策略 rollout 240 个回合,清空顶层托盘六次,并在策略即将犯错时介入。第一个托盘时,箱子放在评测朝向;其余托盘则像数据采集时那样变化位置与朝向。240 个回合中 212 个包含干预。下一次训练只使用这些回合中的干预片段,加上其余 28 个成功回合的完整轨迹。与初始 1 小时数据集合并后,共得到 1.7 小时训练数据。
在这份数据上微调后,标准评测设置下的成功率从 28% 提升到 88%(图 20)。为检验这一提升是否位置特异,我们还在更多样的箱子位置上评测,成功率从 11% 提升到 48%。值得注意的是,这个只用 1.7 小时数据训练的模型比 21 小时数据训练的模型高 12 pp。但需要说明:这 1.7 小时全部在灯箱中采集,而灯箱也正是两个模型的评测设置。
2.10 仅靠服务设置,同一个 checkpoint 从 76% 到 93%
看到交接失败,我们问:问题是否在于模型必须在两臂还相距很远时就对交接做出承诺?我们最初假设交接动作太快、学不会;但 2.8 节更慢的数据修复了大部分这类失败,这指向预测 horizon:动作更慢时,等模型预测交接的那一刻,两个末端执行器已经彼此靠近。
我们想知道改 RTC 设置能否获得类似收益。我们的系统以 50 Hz 运行,动作块为 50 个动作(1 秒)。两个设置决定调度:reinfer 是请求下一个块时队列中剩余的动作数,blend 是新块前多少个动作被引导向旧块的重叠动作。我们此前的默认是 reinfer = 30、blend = 16。推理约需 140 ms,因此新块到达时它的前 7 个动作已经成为过去、无论如何都从旧块执行;reinfer = 50 因此表现得像 reinfer = 43。原文图 21 是一个可交互工具,用于玩这些设置(一个简化:该工具把预测延迟与实际延迟当作同一个数,并给每个块相同延迟;RTC 用延迟估计确定冻结前缀长度,而真实延迟逐块变化)。
在基准调度中,新块在队列剩 30 个动作时被请求,7 个 tick 后到达,此时队列中还有 23 个。在它的 50 个动作中,前 7 个冻结到旧块,接下来 9 个向旧块混合,其余 34 个自由。
改变重推理频率影响很小,不过更频繁的重推理通过让策略更"跟手"而略好(图 22)。blend 的影响大得多:在立即重推理下,blend = 20 取得最好结果,把成功率提升到 93%。把这些设置应用到 2.8 节的 21 小时 + 1 小时模型上,性能进一步提升,从 90% 到 98%,40 次试验中只有一次失败。我们还编译了模型以缩短推理延迟、让重推理更频繁,但这没有帮助:图 22 中编译臂落在未编译孪生臂之下。看起来超过某个点之后,再快地重推理也买不到多少收益。
2.9 节的干预模型不在这次比较中:两个实验并行进行,因此它从未用改进后的设置服务过。
结合 2.8 节,这支持一个想法:模型在两臂相距较远时难以预测动作。更频繁的预测与更慢的动作都会缩小两次观测之间手臂移动的距离,因此交接是在两臂更近时被预测的。
一个显而易见的下一步,是把 21 小时数据、高质量小时、干预数据与最佳 RTC 设置合并进一个模型。但每次评测只有 40 次 rollout,结果噪声太大、不足以支撑有意义的结论,于是我们转向最后一个问题。
2.11 没有预训练 π0.5 权重,一次插入都没有成功
π0 论文(Black et al., "π0: A Vision-Language-Action Flow Model for General Robot Control", Physical Intelligence, 2024, Figure 11,arXiv:2410.24164)中有一个结果:从预训练 checkpoint 微调只比从头训练略好。因此我们测试 π0.5 是否也能从头训练,只初始化 PaliGemma 骨干。自 π0.5 之后,Physical Intelligence 没有发布新权重,但大幅改变了架构(更新的 Gemma 骨干、2 倍图像分辨率、2 倍大的扩散头)。如果性能差距仍然同样小,这些架构改进就可能抵消缺少预训练的损失。
得到的策略能产生看似合理的动作(图 24),但一次插入都没能完成(图 25)。40 次评测中 7 次没能抓起正确的执行器(或任何执行器),其余 33 次中 29 次在交接阶段失败,最后 4 次在插入阶段失败。值得注意的是,其交接模式与操作员 2 相似,而后者在我们的操作员实验中与更差性能相关。尽管只基于单一任务,这表明预训练 π0.5 权重的重要性远高于 π0 结果所暗示的程度。
结论与局限
我们对未来实验的主要建议是:优化场景多样性而非单纯的数据数量;遥操作在该快的地方保持快,但在需要精度的步骤之前放慢,让关键动作块从近距离观测中预测;以及不要一上来就采大数据集,而是先用少量数据训一个简单策略,再用干预数据、或针对它失败情形的补充演示来改进它。
这些实验的一个明显局限是全部结果来自单一任务。我们也只单独考察了各个超参,而没有考察组合,尽管它们的效应必然相互作用。真实机器人还有一个普遍局限:样本量小导致评测又慢又噪。尽管如此,我们仍然分享这些结果,因为关于"如何让策略在真实世界跑起来"的经验报告实在太少。
一些问题因时间不足而留白,但或许值得其他人研究:全局相机是否必要?对我们 4:3 图像做黑像素 padding,能否匹配或超过方形裁剪?flow-matching 步数能否减少以加快推理、或增加以提升性能而不损失其他方面?更长的退火是否有帮助?以及两阶段训练(先在所有评分上、再只在高质量回合上)能否得到既执行干净、又能从失败中恢复的策略?
下一步
随着我们在顶层上逼近 100% 成功率,仅靠 rollout 区分策略变得越来越难:剩余差异小于 40 次评测能可靠分辨的范围。因此我们转向整箱任务,与产线中实际运行的任务完全一致。
模仿学习是获得技能的有效方式,但它有上限。把差距补到 100% 不能靠人去补数据缺口或调超参,而需要模型从自身经验中学习。策略不仅要能从失败中恢复,还要恢复得越来越快、并学会完全避免失败。我们把补上这一差距看作强化学习问题,这也是我们接下来重心所在。
附录
来自参考 YAML 与论文的架构及训练默认值(表 2)。除非另有说明,这些设置在各实验间不变。
| 参数 | 取值 | 说明 |
|---|---|---|
chunk_size | 50 | 动作 horizon:50 Hz 下 1 秒 |
n_action_steps | 50 | 整块执行完才重新查询 |
n_obs_steps | 1 | 单个观测时间步 |
num_inference_steps | 10 | flow-matching 去噪步数 |
image_resolution | [224, 224] | SigLIP 输入尺寸 |
tokenizer_max_length | 200 | π0.5 默认(π0 用 48) |
normalization | QUANTILES | 状态 + 动作,对离群值稳健 |
time_sampling | Beta(α = 1.5, β = 1.0) | flow-matching 时间步分布 |
dtype | bfloat16 | 装下 3B 参数 VLM 所需 |
表 2:默认设置。
2.4 节测试的图像增广:LeRobot 的六种默认变换,其中每帧抽三种、按固定顺序应用。图 26 展示每种变换单独作用、取接近其范围强端的效果;图 27 展示完整流水线在同一帧上的五次随机抽样。
本文用到的所有训练数据集都以 LeRobot 格式公开在 Hugging Face 上(表 3)。小时数按 50 Hz 帧数折算。
| 数据集 | 回合数 | 小时 | 用于 |
|---|---|---|---|
| actuator_unboxing_20h_345 | 7,271 | 21.4 | 2.1(210k 步阶梯)、2.2(rank 64、EBS 256) |
| actuator_unboxing_20h_345_v2 | 7,271 | 21.0 | 2.1(50k 基准)、2.2(两个 EBS-64 臂)、2.3、2.4、2.6(21 小时)、2.10、2.11 |
| actuator_unboxing_10h_vr | 3,460 | 9.8 | 2.5(操作员 1) |
| actuator_unboxing_10h_leaderarms | 3,253 | 9.5 | 2.5(操作员 2) |
| actuator_unboxing_10h_diverse | 3,368 | 9.7 | 2.5(混合)、2.6(10 小时) |
| actuator_unboxing_4h_diverse | 1,344 | 3.9 | 2.6(4 小时)、2.7(五场景) |
| actuator_unboxing_4h_lightbox | 1,569 | 4.0 | 2.7(仅灯箱) |
| actuator_unboxing_1h_HQ | 198 | 1.0 | 2.8(两个臂)、2.9(基础策略) |
| actuator_unboxing_1h_HQ_dagger_intv | 512 | 1.7 | 2.9(上述一小时加 240 次 rollout 的干预片段) |
表 3:Hugging Face 上的训练数据集。两个 21 小时集合包含同样的 7,271 个回合;v2 是除列在第一条下的两个早期运行之外全部使用的导出。2.4 节相对关节目标臂训练用的是 v2 的本地重导出(动作为 delta),未上传。评测 rollout 不包含在内。
来源:Dream Machines — Empirical results fine-tuning π0.5 on a real manufacturing task
原文来源:Dream Machineshttps://dream-machines.eu/blog/pi05-fine-tuning