用 Claude 做图工程:从线性 Agent 到 Agent 舰队的 14 步
多数多智能体系统其实还是队列。这份路线图把工作流重画成图:节点干活、边传数据、独立节点并行、结果只在真实依赖处汇合,一路走到让 Claude 自己设计图。
今天大多数做多智能体系统的人,其实还在做队列。Agent A 干完,Agent B 才开始;Agent C 等着,Agent D 等得更久。诡异的地方在于:这些等待大部分完全没必要。任务之间是独立的,不独立的是架构。没有分支、没有路由、没有并行执行——只有一个上下文拖着所有步骤往前走,直到工作流变得又慢又贵,最终大到任何一个 agent 都无法干净地推理。
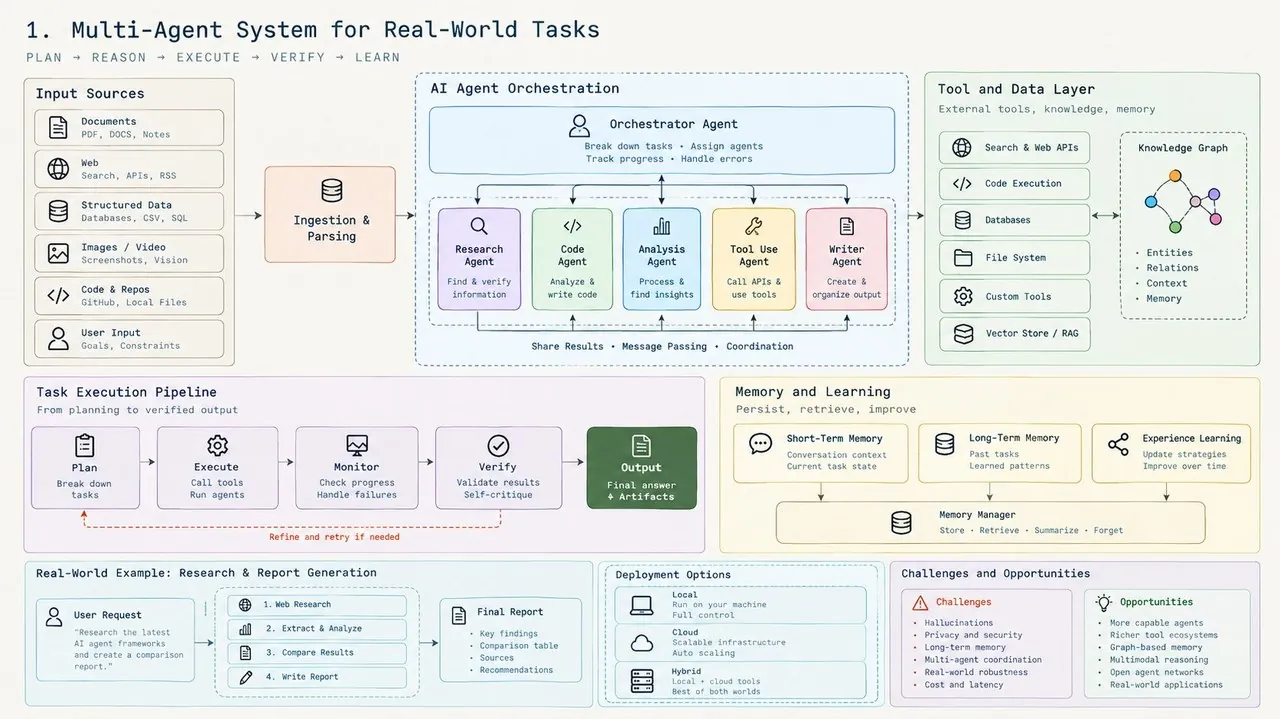
解法不是更好的 prompt,而是另一种形状。别把 agent 工作流当成列表,把它当成图:节点负责干活,边负责传数据,独立的节点同时运行,结果只在真正彼此需要时才汇合。一旦这样思考,单个 Claude 会话就不再像一个工人,而开始像一整支舰队的控制面。本文就是走到那一步的 14 步路线图。
01. 别再想步骤,要想依赖
多数工作流一开始长这样:A → B → C → D。它看起来合理,因为人类写指令就是这个写法。但顺序并不自动等于依赖。如果 B 不消费 A 产出的任何东西,B 就没有任何理由等 A。这是每次看到「然后」两个字时该问的第一个问题:下一个任务真的需要上一个任务的输出吗?如果答案是否,你大概率已经发现了可以并行的工作。
节点是一份有边界的工作。边只在一个节点的信息被另一个节点需要时才存在。这个区分听起来很小,但它会改变整个架构。
02. 线性 agent 只是最弱的那种图
A → B → C → D 技术上已经是一张图了,只是一张非常窄的图:每个节点都在等它前面那个节点,一个慢任务会拖住下游所有环节,一次失败可能阻塞整次运行。所以别急着重建你的 agent——先重画它。把每条连接拿出来问:这条边上真的有数据流过吗?你往往会发现更接近这样的结构:四份独立的工作可以同时执行,然后在某个最终节点需要它们的合并结果时再汇合。同样的工作,完全不同的墙钟时间。
flowchart LR
  subgraph linear["线性:一个上下文拖着一切"]
    A1[A] --> B1[B] --> C1[C] --> D1[D] --> E1[E]
  end
  subgraph graph["图:独立节点同时运行"]
    A2[A] --> E2[E]
    B2[B] --> E2
    C2[C] --> E2
    D2[D] --> E2
  end
03. 每个节点一份工作、一份契约
当 agent 返回不可预测的一大坨文本时,并行就变得危险。每个节点都应该有三样东西:有界的输入、唯一的职责、结构化的输出。如果一个研究节点应当返回标题、URL、置信度和摘要,就把这个形状明确定义下来。别让下一个 agent 去猜上一个 agent 是什么意思。schema 把含糊的对话变成组件。
与其说「去研究一下然后告诉我你发现了什么」,不如想成一份显式契约:
{
  "title":      string,
  "url":        string,
  "confidence": number,
  "finding":    string
}
这样下游的图就不需要人来解读输出了,它可以直接消费。
04. 边传数据,不传智能
浪费模型调用最容易的方式,是让 agent 去干普通代码瞬间就能干完的活。拍平数组?代码。去重?代码。排序?代码。过滤失败结果?代码。把一种 schema 转成另一种?大概率还是代码。agent 的 token 应该花在需要判断力的地方;一切确定性的工作都属于接线层。由此得到一条好用的规则:节点思考,边变换。你从 agent 身上拿掉的确定性工作越多,图就越便宜、越可预测。
05. 把一切独立的工作扇出
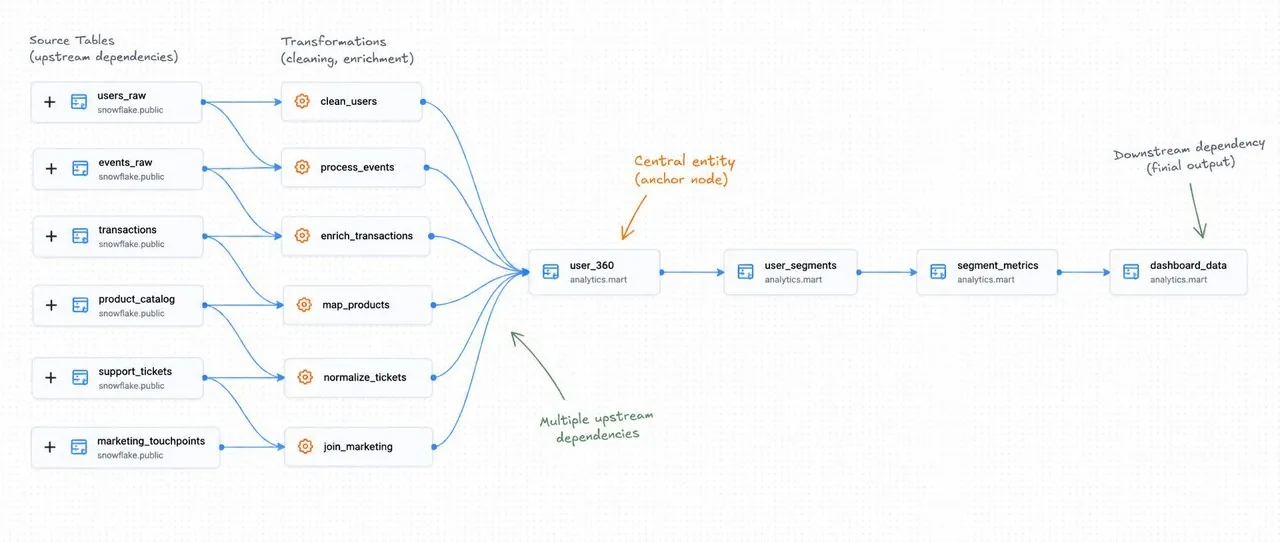
图架构从这里开始回本。假设你要检查 40 个文件。线性 agent 看到的是 文件 1 → 文件 2 → … → 文件 40;图看到的是 40 个独立节点:并发启动,每个节点拿到一个窄上下文、干一份活、返回结构化数据,然后消失。父会话永远不需要把 40 个文件塞进一个巨大的上下文——它只需要输出。这才是关键的扩展技巧:并行不只是省时间,它在分发上下文。不再是一个 agent 试图记住一切,而是几十个 agent 各自只记住自己节点关心的部分。
06. 只在图真的需要合并时才合并
并行工作最终要收敛,但别到处设屏障。屏障让下游工作等到所有上游任务结束。有时这是必要的:如果要把 50 条发现互相排序,你需要完整集合;如果要跨所有来源去重,你需要完整集合。但如果每个条目都能独立继续,强行让一切同步就只是白白浪费延迟。规则很简单:因为数据要求而同步,不是因为图画起来更好看而同步。
07. 学会菱形
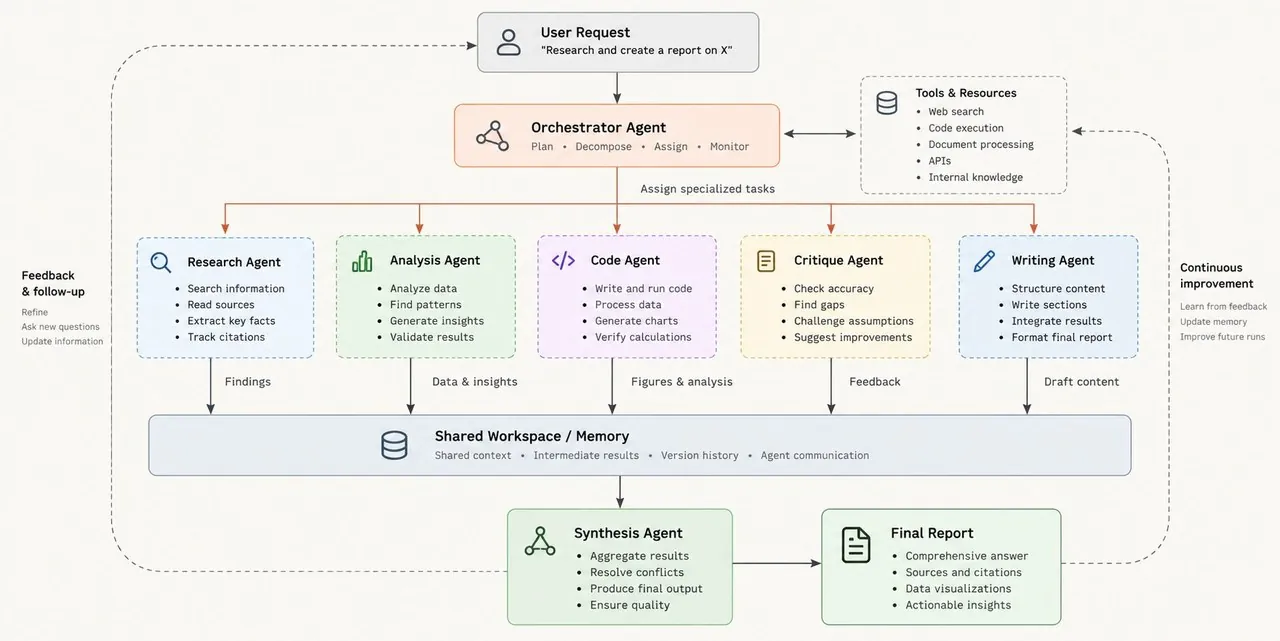
最可复用的 agent 拓扑长这样:split → 并行工作 → reduce → synthesize。一个任务进来,许多工人攻击不同部分,代码压缩它们的输出,最后一个节点综合出答案。这就是菱形,几乎到处都能复用:研究、代码评审、安全审计、市场扫描、竞品分析、文档处理、依赖分析、数据抽取。prompt 在变,拓扑几乎不变。一旦认出这个模式,「让 agent 做更多」就成了错误的问题。更好的问题是:这张图应该在哪里分开、在哪里收敛?
flowchart TD
  Q[任务进入] --> S1[工人 1]
  Q --> S2[工人 2]
  Q --> S3[工人 N]
  S1 --> R[确定性 reduce:去重、归一、排序]
  S2 --> R
  S3 --> R
  R --> SYN[综合节点:一个答案]
08. 动态路由,而不是什么都跑
有些任务不该走同一条路。假设一个 agent 检查了一次代码改动并返回 { "risk": "low" }:这可以触发一次轻量评审。但 { "risk": "high" } 可能触发五个独立评审者,覆盖安全、正确性、性能、测试与架构。智能负责判断情况是什么,代码负责决定接下来发生什么。这是一个强大的分离——Claude 在节点处提供判断力,你的图在节点之间提供确定性行为。
result = classify_node(diff)           # 判断:模型
match result["risk"]:                  # 行为:代码
    case "low":  run(lightweight_review)
    case "high": fan_out([security, correctness,
                          performance, tests, architecture])
09. 让发现经得起攻击
更多 agent 并不自动等于更好。验证才等于更好。与其问一个 agent「这条发现对吗?」,不如创建独立的批评者,它们的职责是摧毁这条发现:一个查正确性,一个试着复现它,一个找安全影响,一个搜相反证据。然后只有活过验证的发现才继续往下游走。这翻转了通常的 agent 模式——你不再要求模型们达成一致,而是在设计一个让弱结论难以存活的系统。对高风险的研究或代码分析,这个差别极其重要。
flowchart LR
  F[发现] --> C1[批评者:正确性]
  F --> C2[批评者:复现它]
  F --> C3[批评者:安全影响]
  F --> C4[批评者:相反证据]
  C1 --> V{"活过所有批评者?"}
  C2 --> V
  C3 --> V
  C4 --> V
  V -->|是| D[继续往下游]
  V -->|否| X[拒绝并记录]
10. 把失败设计成局部事件
一张好图应该预期节点会失败。如果你启动 30 个研究 agent、其中 2 个超时,另外 28 个不该因此变成废物。失败应当局部塌缩:下游节点要能容忍缺失的结果,并行写者要有隔离的环境,重试应当瞄准失败的节点而不是重启整个工作流。把每个节点当成一次性的,图才是持久的东西。这是相对传统单 agent 提示的一次重大架构转变。
11. 只在有停止条件时才加循环
图不必只往前走,有些问题需要环。找 bug、验证它们、用这些发现去搜相关 bug、重复。但一个不受控的循环只是一台昂贵的无限机器。每个环都需要收敛条件。一个好用的模式是:连续若干轮都没有新发现才停止——并且记录你已经见过的一切,包括被拒绝的发现。否则被拒绝的结果会在下一轮回来,你的 agent 会反复付钱重新发现同一批死胡同。没有记忆的循环不是探索,是带着 token 预算的失忆。
seen = set()           # 包含被拒绝的发现
dry_rounds = 0
while dry_rounds < 3:
    new = discover(exclude=seen)
    if not new:
        dry_rounds += 1
    else:
        dry_rounds = 0
    seen |= verify_and_keep(new) | reject(new)
12. 别再为便宜的活付旗舰模型的钱
图暴露了一件单体 agent 藏住的事:不同的工作需要不同等级的智能。从 100 份文档里抽字段,未必需要和最终综合相同的模型。分类可以便宜,格式化可以便宜,基础抽取可以便宜——最终判断可以保持昂贵。所以给图分层:重复的、有界的节点用更轻的模型,把最强的模型留给综合、仲裁、困难推理与含糊决策。你不需要让工作流变笨,你需要停止把智能花在没有用的地方。
| 工作类别 | 模型档位 | 原因 |
|---|---|---|
| 分类、格式化、字段抽取 | 轻 / 便宜 | 有界、重复、可由 schema 校验 |
| 逐文件检查、逐来源检索 | 轻 / 便宜 | 窄上下文、单一职责、结构化输出 |
| 含糊输入上的路由决策 | 中档 | 需要判断力,但选择集很小 |
| 综合、仲裁、困难推理 | 最强 | 出错会让整次运行买单的地方 |
13. 架构决定延迟
两个工作流可以包含完全相同的 agent,却在截然不同的时间里结束。为什么?拓扑。考虑一个跨 20 个条目的三阶段流程。用全局屏障:阶段 1 必须对全部 20 个条目结束,然后阶段 2 开始,然后所有人再等一次,然后阶段 3 开始。流水线的行为不同:条目 1 可以已经在进入阶段 3,而条目 14 还在结束阶段 1。除非存在真实依赖,否则什么都不等。这就是为什么图设计变成一个性能问题:你优化的不只是 prompt 和模型,还有关键路径。一旦开始用这个视角看工作流,不必要的等待会变得刺眼。
| 拓扑 | 条目 1 何时到达阶段 3 | 失败影响范围 |
|---|---|---|
| 全局屏障 | 等全部 20 个条目结束阶段 1 与 2 之后 | 一个慢条目拖住每个阶段 |
| 流水线(按条目的边) | 条目 1 结束阶段 2 的那一刻 | 一个慢条目只拖住它自己 |
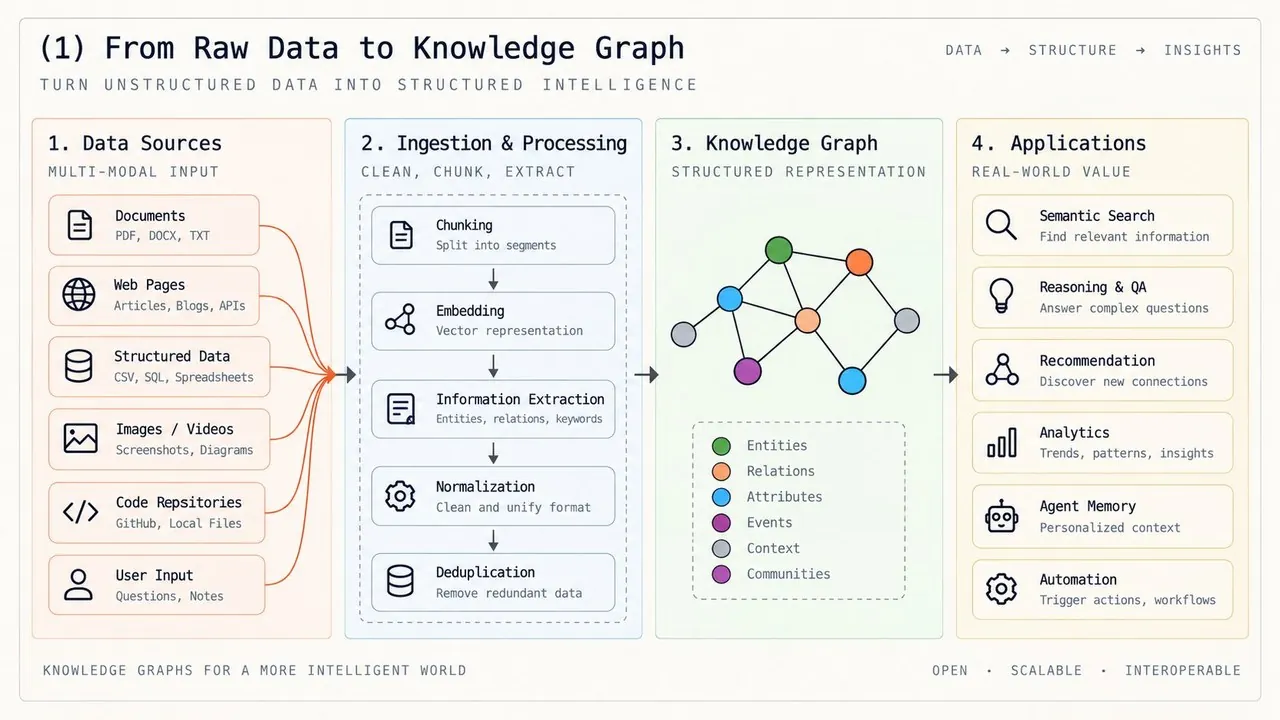
14. 最终,让 Claude 来设计图
最后一级,是你不再手工定义每一个拓扑。把目标交给 Claude:让它分解问题、识别独立任务、决定哪里该扇出、生成编排、启动专业工人、验证它们的输出;然后让一个最终节点综合结果。到那一步,你不再是在写一个长 prompt 告诉一个模型怎么思考——你是在描述一个临时软件系统的目标。Claude 构建系统,系统执行,任务结束时图就消失。这是一种与提示根本不同的抽象。
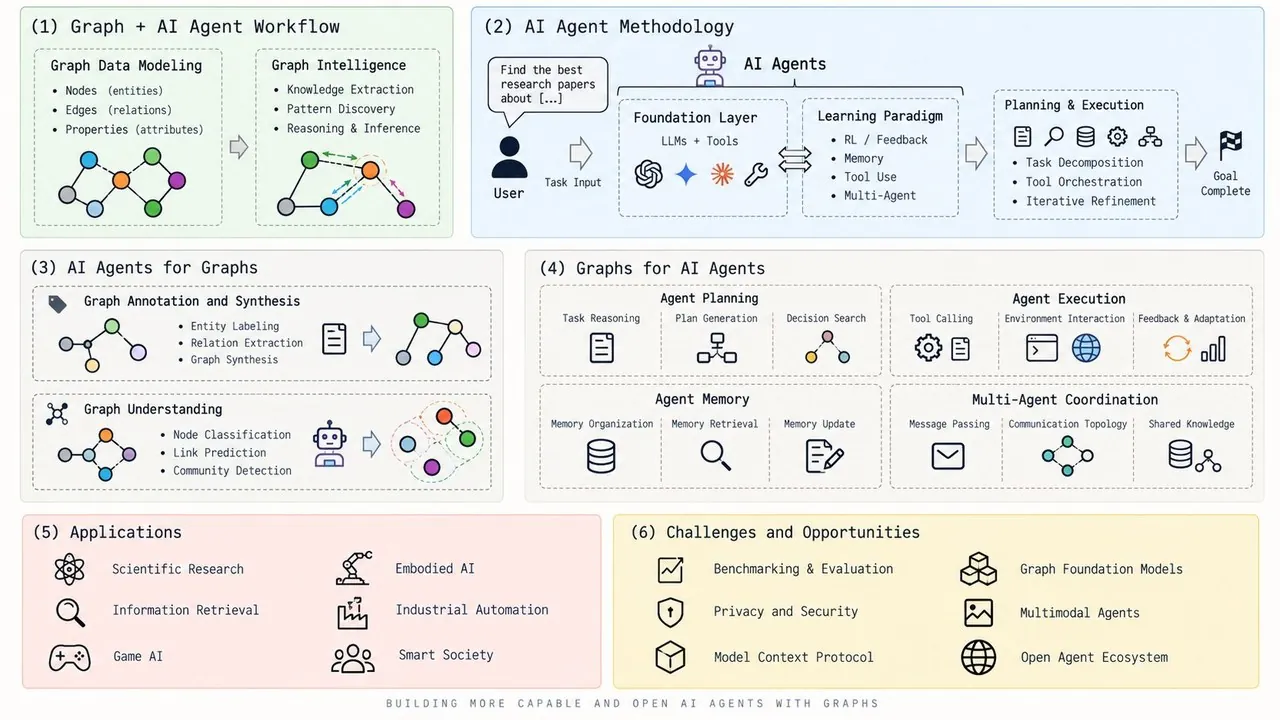
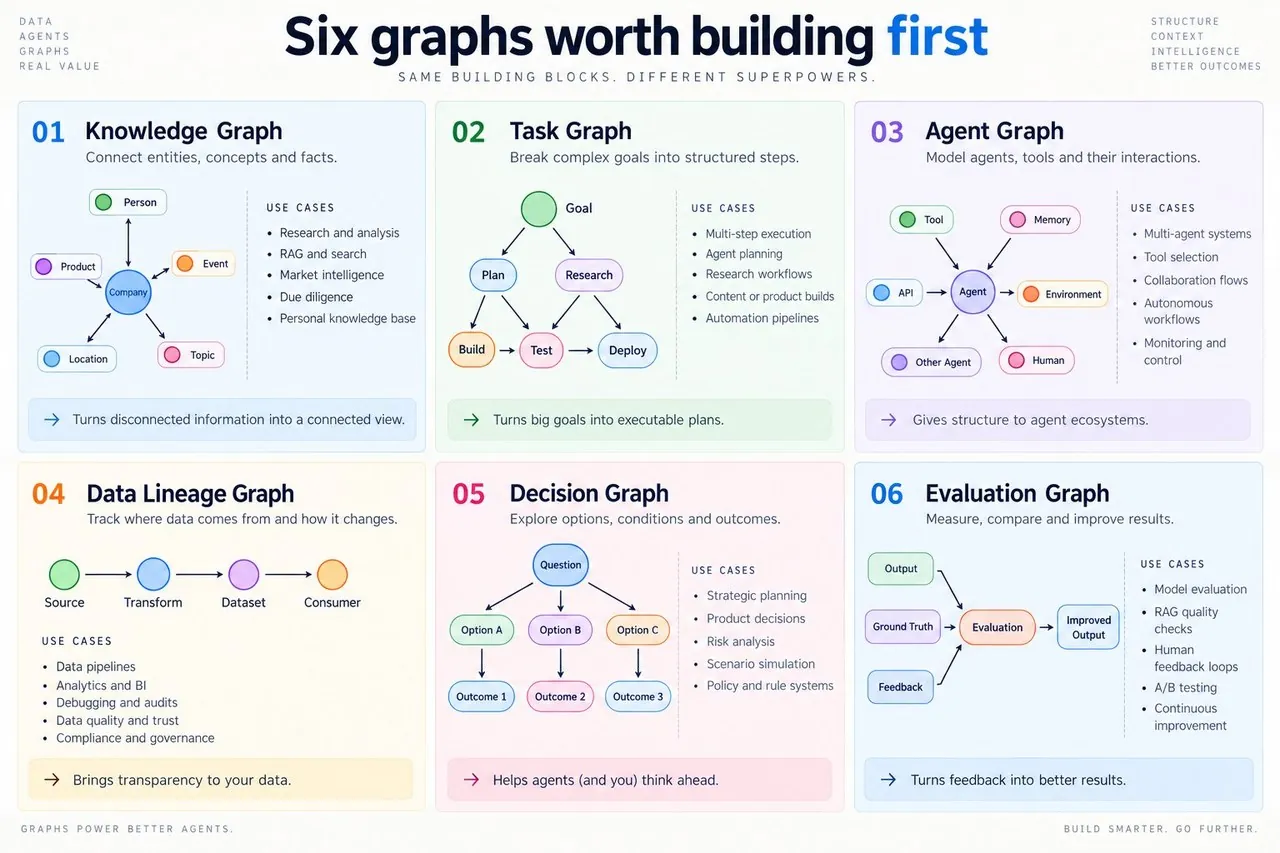
值得先建的六张图
- 仓库安全扫描。每个路由或模块一个工人,独立的漏洞检查,对每个上报问题加一层验证,只有活过评审的发现才进入最终综合。
- 深度研究引擎。把一个问题拆成互相竞争的研究角度,同时检索,用代码归一化来源,交叉核对重要论断,只综合经过验证的证据。
- 大规模代码迁移。每个文件或模块一个工人,每次变换后跑测试,失败路由进修复循环,只合并通过的工作。
- 多视角代码评审。先对 diff 的规模与风险分类:小改动走轻量路径,高风险改动扇出到正确性、安全、性能、架构与测试。
- 持续生态扫描器。同时检查发布、仓库、博客、文档与讨论,用代码去重,给有意义的变化排序,生成一份紧凑报告。
- 规模未知的 bug 发现。启动多个独立发现者,记录每一个候选,用不同视角验证新发现,把幸存者喂回发现环节,只在连续若干轮空手后停止。
更大的转变
初学者问:我该写什么 prompt?更好的构建者问:该由哪个 agent 来做这个任务?但架构层面的问题是:这份工作应该是什么形状?一个上下文不该研究一切。一个 agent 不该验证自己。一个模型不该承担每一类工作。独立的任务也不该仅仅因为你把它们写在了不同的行上就排队等待。
线性 agent 不会消失,它会变成更大的东西里的一个节点。一旦你开始把工作看成节点、边、分支、屏障、路由、验证者与环,天花板就移动了。你不再试图构建一个什么都能做的 agent,而是构建一张知道何时拆分工作、把智能花在哪里、验证什么、以及何时把舰队重新聚拢的图。
来源:X(Twitter)文章,作者 Promix(@Promixyz),《Graph Engineering with Claude: 14 Steps from Linear Agents to Agent Fleets》(x.com/Promixyz/status/2102424036416348494,2026-09-22)。本文为全文翻译与改编;全部配图来自原文,Mermaid 图与表格为本版本补充。
原文来源:Promix (X)https://x.com/Promixyz/status/2102424036416348494