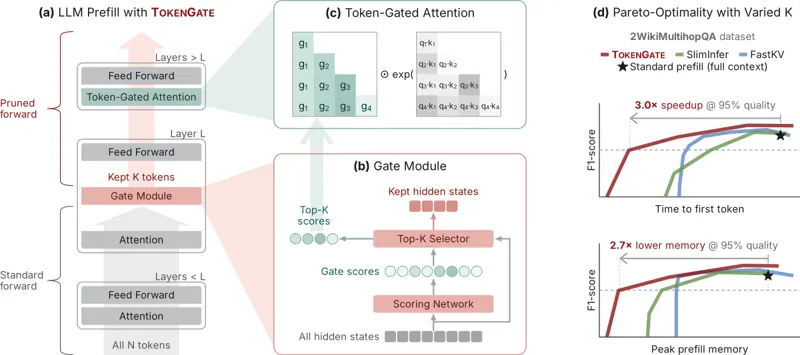
TokenGate: Learnable Token Pruning for Fast, Memory-Efficient LLM Prefill
TokenGate learns a residual scorer at a middle layer, retains top-K document tokens plus request scaffolding, and uses token-gated attention to train through the discrete selection. It reports 1.4-11.3x faster TTFT and 1.5-3.4x lower peak prefill memory on Qwen3 and Qwen3.5 without accuracy loss; robotics performance remains untested.
Liana Patel, Rishabh Ranjan, Ion Stoica · 21 views · Oct 19, 2026
Large Language ModelsToken Pruning
Oct 19, 2026