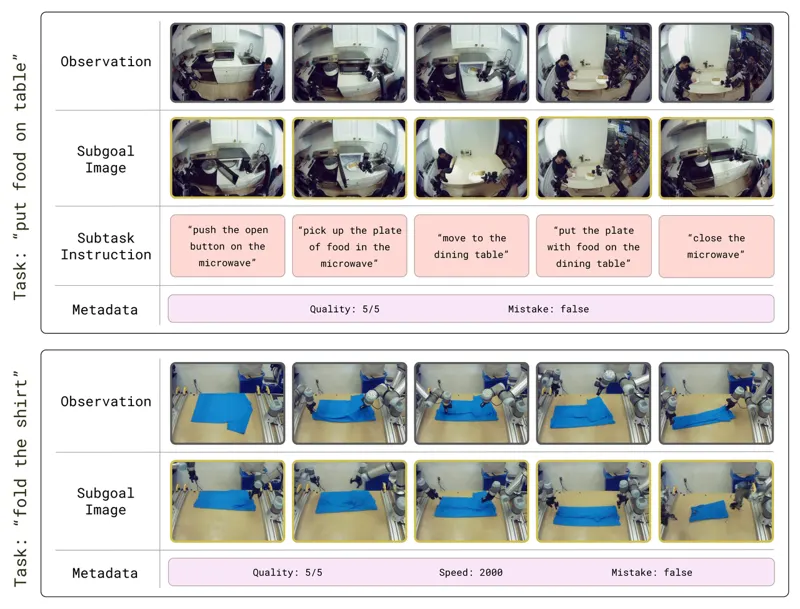
π0.7:可操控的通用机器人基础模型与涌现能力Physical Intelligence 提出可操控的机器人基础模型 π0.7:通过语言指令、子目标图像与任务元数据等多模态上下文条件化,在未见环境多阶段任务、零样本跨本体泛化中开箱即用,性能比肩 RL 微调专用策略,并展现涌现能力。Physical Intelligence, Bo Ai, Ali Amin·2026年4月16日机器人基础模型视觉语言动作模型vision-language-action2026年4月16日
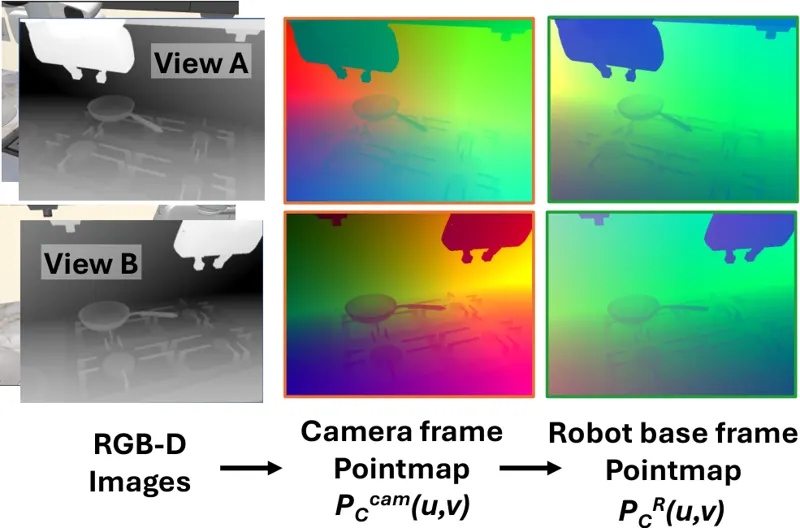
像机器人一样看:面向VLA模型的机器人中心点图本文通过引入机器人中心点图(pointmap)解决VLA模型中相机帧观测与机器人帧动作之间的坐标系不匹配问题。点图的像素存储场景点在机器人坐标系下的3D坐标,在保留图像结构的同时提供机器人帧3D几何,使策略能跨不同相机设置泛化。Byungkun Lee, Dongyoon Hwang, Dongjin Kim·2026年7月13日视觉语言动作模型Pointmapcross-viewpoint2026年7月13日