TANGO:用全身视觉-语言-动作模型在杂乱环境中导航
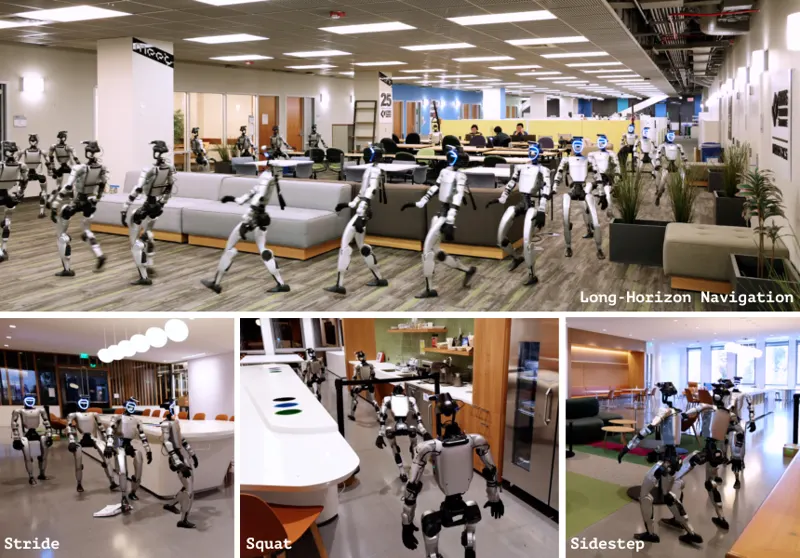
人形机器人在杂乱室内的导航不是 2D 路径规划问题:身体的几何形状在运动中持续变化,穿过狭窄通道需要手臂摆放、躯干调整与步态调制的连续协同。TANGO 是首个面向杂乱环境语言条件通行的全身视觉-语言-动作框架,输入自然语言指令与第一视角 RGB 观测,直接预测 29 自由度关节空间动作块交给下游全身控制执行。训练数据全部在仿真中合成:Plan-Edit-Track(PET)管线用全局路径规划、运动学全身动作生成、障碍感知动作编辑与强化学习跟踪自动产出 64,633 条动力学可行的无碰撞通行轨迹,仅耗 211 GPU 小时。TANGO 在 VLNVerse 上取得 54.69 / 52.89 的 seen / unseen 成功率,是对比方法中唯一具备真实物理控制能力的,并把杂乱场景碰撞率压到 9.90%(最强基线 15.81%,且对方额外使用了 LiDAR)。零样本部署到 Unitree G1 后,可在真实杂乱场景中完成语言引导通行,无需任何真实导航数据。已被 CoRL 2026 接收。
Anqi Li, Yuxin Chen, Zhaobo Li2026年9月8日
人形机器人视觉语言动作模型导航2026年9月8日