HAM-VLN:用分层智能体记忆实现零样本视觉语言导航
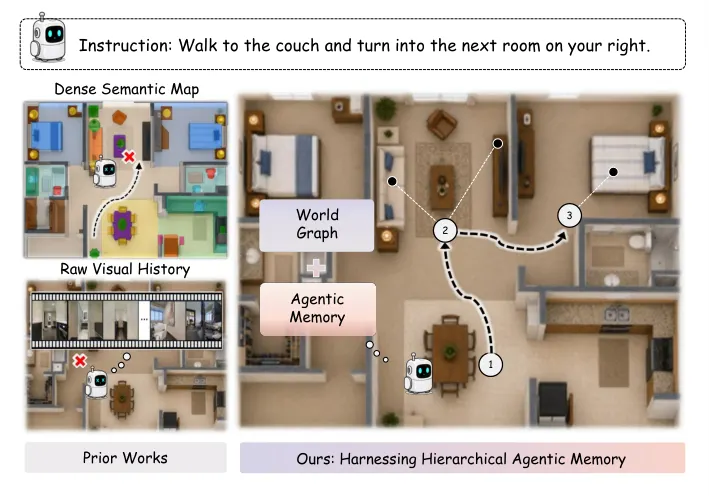
视觉语言导航(VLN)要求机器人在从未见过的环境中按自然语言指令走到目标位置或目标物体。近期出现了一条免训练范式:机器人把当前观测交给多模态大模型,由模型理解场景并规划下一步动作。但无论用图像流还是稠密地图做长程导航,都会不可避免地引入不断膨胀的记忆与推理瓶颈。本文提出 HAM-VLN——一种与决策耦合、由智能体自己撰写的记忆机制,为机器人配上一张持久的、由深度反投影落地的世界图。在选择下一个动作的同一次模型调用里,HAM-VLN 同时记录语义与反思信息,包括房间类型、看到的物体、指令执行进度以及失败原因。最近的航点在有限窗口内原文保留,更久远的历史只有通过检索才会重新进入上下文,检索按相关性、时近性与显著性打分,并做一跳拓扑扩展。这个设计不需要在逐航点决策之外增加任何大模型调用。相比已有方法,HAM-VLN 不仅提升了多项导航指标,还把上下文长度压缩了 65% 以上:在完全不训练的前提下,VLN-CE R2R 成功率 61.0%,VLN-CE RxR 52.7%,HM3D-v2 ObjectNav 79.7%。
An Liu, Bingxi Liu, Hongyu Ding2026年7月31日
视觉语言导航具身智能Zero-Shot Navigation2026年7月31日