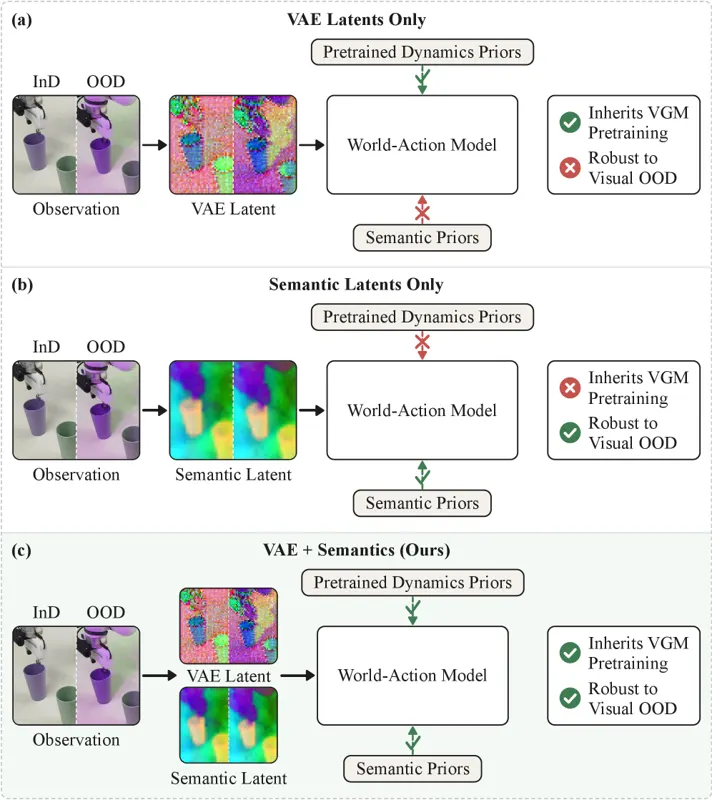
Robust-WAM:桥接世界-动作模型的生成式预训练与语义前瞻提出视频生成式世界-动作模型的通用后训练方法,保留 VAE 潜空间的生成路径并添加轻量语义前瞻对齐目标,用可学习查询 token 将未来场景语义引入动作流,使动作基于外观不变的动态表示,在 OOD 泛化仿真和真机上持续提升多种 WAM 基线成功率。Haodong Yan, Junfeng Li, Junjie He·2026年8月6日VAERobust-WAM世界模型2026年8月6日
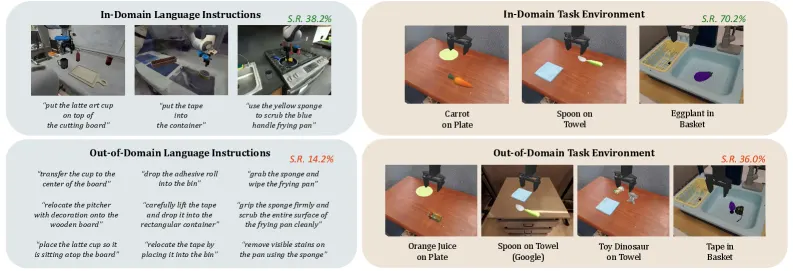
RL2-VLA:VLA 模型自适应 RL 潜空间组合引导与测试时扩展提出 RL2 自适应推理时引导框架,在 VLA 动作专家潜空间上训练轻量离线 RL 策略,推理时将其流速度与冻结 VLA 组合,仅在预测失败时激活引导,在 SIMPLER 和 PolaRiS 基准上 OOD 场景成功率提升达 17.3%,真机实验验证迁移有效。Derek Ming Siang Tan, Shailesh Shailesh, Srikrishna Iyer·2026年7月29日视觉语言动作模型RL2-VLA强化学习2026年7月29日