IMLE-VLA:用单步条件隐式最大似然估计加速视觉-语言-动作策略
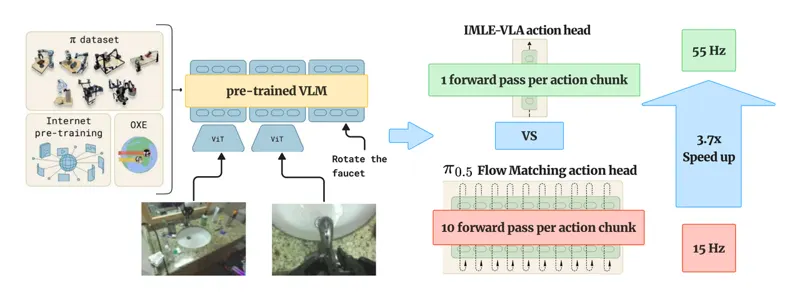
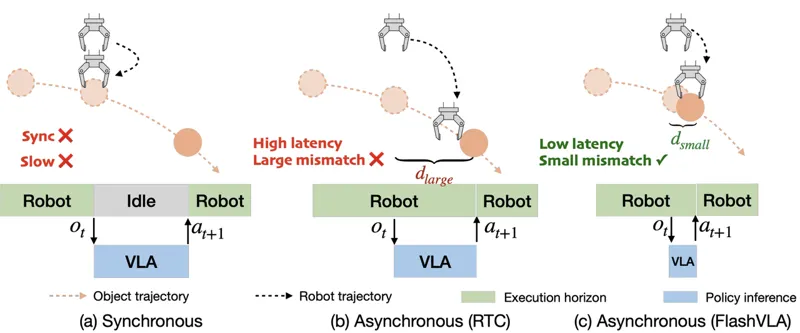
VLA 策略的推理瓶颈不在视觉语言主干,而在动作头:扩散/流匹配头要跑 10 步 Euler 积分才出一个动作块,机器人只能在等待里停-走-停。IMLE-VLA 把 π0.5 的迭代动作头换成单步条件生成器,用条件隐式最大似然估计(cIMLE)训练——每步采 m 个噪声候选,把专家动作只匹配给最近的那一个候选(最近邻分配不回传梯度),其余候选因此可以自由地去覆盖别的模式,天然避免朴素回归头的模式坍缩。改动只限于动作头,3B VLM 主干完全冻结并原样保留,因此推理频率从 15 Hz 提到 55 Hz(3.67×),配合更长执行时域 H 动作吞吐最高 11.0×。LIBERO 40 任务平均成功率 98.0%,是所有对比方法里最高且同时最快;LIBERO-plus 五个等级的测试时扰动下保持 π0.5 的鲁棒性,而 OpenVLA-OFT 等基线急剧退化。真机 Franka Panda 四个任务全部超过 π0.5(19/15、18/15、15/12、16/12,每任务 20 回合),本体感受 jerk 低 2.2×–3.0×,每回合 VLA 前向耗时降 3.9×–6.6×。局限:加大 H 是拿反应性换吞吐;m=1 时退化为条件均值回归;评测集中在 LIBERO 与单臂桌面任务。
视觉语言动作模型Efficient InferenceSingle-Step Action GenerationHosseinkhani, Kian, Peng, Qinhe, Shramko, George·2026年9月10日