
如何用 10 步搭好你的第一台本地 LLM(完整教程)
一份把本地 LLM 从零跑起来的 10 步路线图:内存与模型选择、Ollama 安装、量化、硬件选购、API 服务化、小模型路由,以及六个可直接照搬的实战负载。
大多数想在家跑模型的人,最后都落得一张花了 3000 美元、一天却闲置二十小时的显卡,配上一个聊了四页就忘掉上下文的聊天机器人。他们不知道模型到底要多少内存,不知道同一款模型那一千三百零三个版本该下哪个,也不知道为什么自己跑出来的速度只有别人在 X 上贴的三分之一。这份 10 步路线图,就是把这团乱麻变成一套你每天都会用的本地模型栈。
开源模型,就是文件任何人都可以下载、并在自己电脑上运行的 AI 模型。Qwen、DeepSeek、GLM、Gemma、Mistral、Kimi、Nemotron,以及 OpenAI 自家的 gpt-oss,都是开源的。很多年里它们只是爱好者的玩意。2026 年情况变了:Epoch AI 现在测算出最好的开源模型只落后闭源前沿大约四个月,而且其中好几款在普通笔记本上就能跑。
同样在这几个月,两大 AI 实验室都削减了订阅赠送的额度。开源模型越来越强,租用的反而越收越紧——这正是这份指南存在的原因。
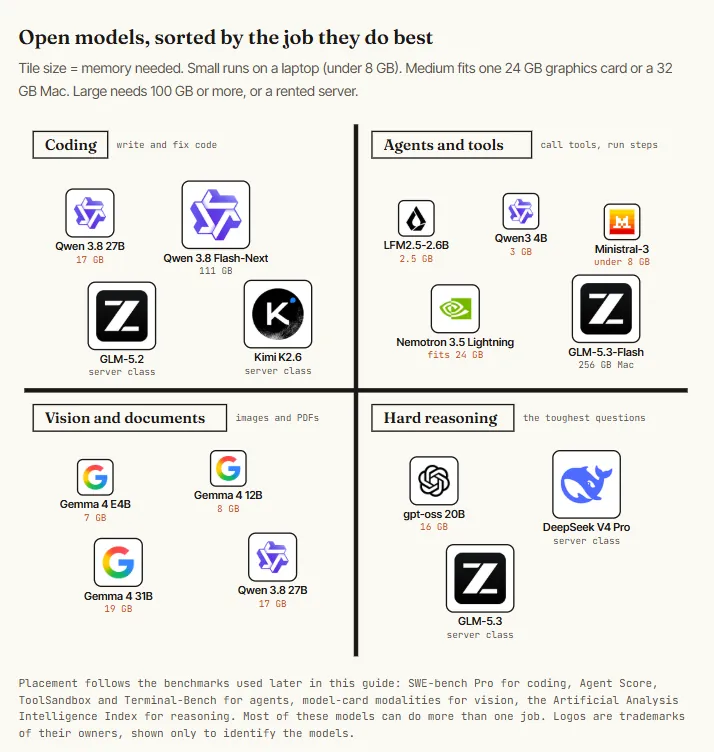
这就是地图。先挑出匹配你想做的事的那一格,然后在里面找最小的那一块瓷砖——那就是你现在这台机器今天就能跑起来的模型。
Hugging Face 的 Clement Delangue,谈为什么真实工作负载正在转向开源模型:「这比我预期的时间短得多——公司们终于意识到,对很多任务来说,自己训练和使用开源模型比用 API 更好、更便宜、也更快。」
你不需要先买任何东西,也不需要先搞懂一切。从第 0 步开始,让一个模型先开口回答你。指南的其余部分,不过是解释你刚才做了什么,以及接下来能往哪走。
容量决定能不能装下。带宽决定跑多快。利用率决定划不划算。
00. 第一次运行——一条安装命令,一句提问,一个回答
本地 LLM 就是一个你下载的文件,加上一个运行它的小程序。就这么多。文件是模型,程序这里用的是免费的 Ollama。你打一个问题,模型回答,而没有任何东西离开你的电脑。
- 先看自己有多少内存。内存决定了你能跑哪款模型,所以先查它。
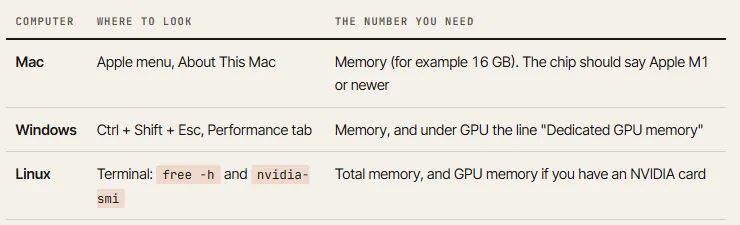
free -h。- 从这张表里挑你的第一款模型。背后的规则:下载体积不要超过内存的大约三分之二。
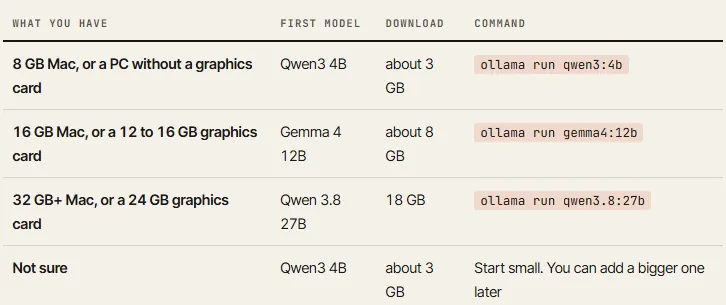
- M 系列芯片的 Mac 上,整块内存都可以给模型用。
- Windows 或 Linux PC 上,模型要的是显卡自己的内存(显存),普通内存只是慢速兜底。
- 没有显卡,就只能跑小模型。
- 安装 Ollama 并运行模型。Mac 上打开终端(Cmd + 空格,输入 Terminal),Windows 上打开 PowerShell(开始菜单,输入 PowerShell)。粘一行,按回车。
# Mac 或 Linux
$ curl -fsSL https://ollama.com/install.sh | sh

# Windows (PowerShell)
> irm https://ollama.com/install.ps1 | iex

# 然后,任何系统上都行:从表里下载并启动你的模型
$ ollama run qwen3:4b- 你会看到什么。一个进度条,文件下载一次。然后是一个等你的提示符。打一个问题,按回车。
pulling manifest
pulling 3e4cb1417446... 100% ▕████████████████▏ 2.6 GB
success
>>> 用两句话解释什么是上下文窗口。

上下文窗口是模型一次能看到的文本量,
包括你的问题和它自己的回答……

>>> /bye                # 退出对话。再运行同一条命令就能回来
这就装好了一个本地 LLM 并且能用了。关掉 Wi-Fi 再问一次:它照样回答。
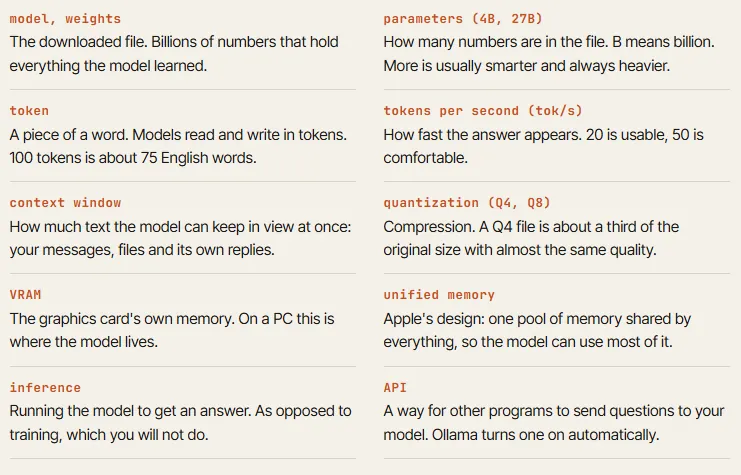
你会反复遇到的十个词。现在就把它读一遍。
01. 为什么——在买之前先搞清楚你在买什么
本地模型给你四样 API 给不了的东西:你的数据从不出机器、没人能改你的上限、每多一次请求的成本为零、模型在你决定换掉它之前一直不变。它不给你市面上最聪明的模型。
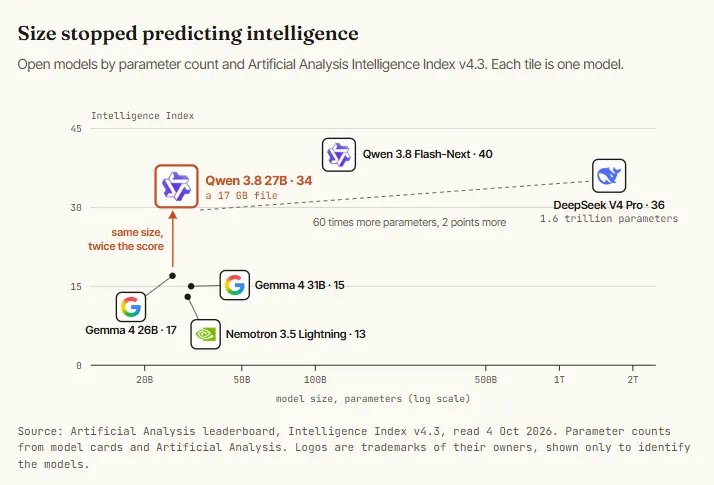
对最后这一点要说得精确。在当前 Artificial Analysis 智能指数上,Qwen 3.8 27B 得 34 分。DeepSeek V4 Pro,一个参数多六十倍、需要服务器的模型,得 36 分。最好的开源模型得 46 分,最好的闭源模型得 58 分。你桌上一份 17 GB 的文件,就能和远比它大的开源模型并驾齐驱,而且它是真正能写代码、能当 agent 用的模型。闭源前沿仍然明显领先。
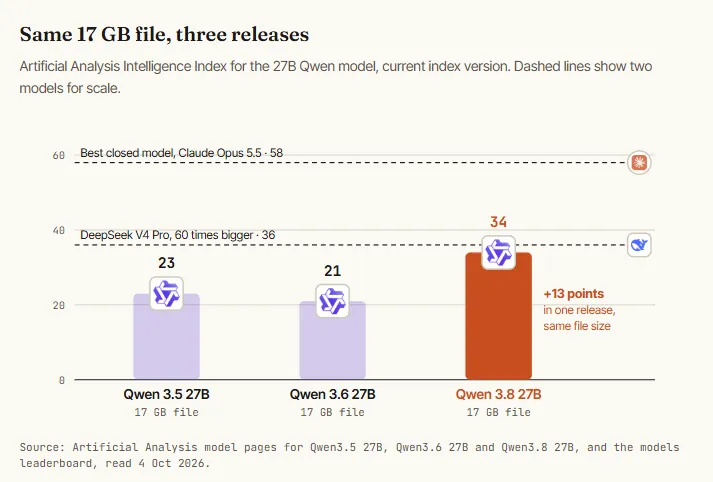
它在 2026 年 8 月发布时,用的是同一指数的上一版,得 52 分:和 OpenAI 的 GPT-5.6 Luna 持平,比 DeepSeek V4 Pro 和 GLM-5.2 只低一分。到了 9 月指数变难了,所以每个分数都往下掉。可周围的排名几乎没动。
差距也在收窄。Epoch AI 在 2026 年 5 月测算过:从 1 月起,最好的开源权重模型就一直落后闭源前沿大约四个月。你今天能下载到的,基本上就是去年春天你在付费买的东西。
02. 补贴——看看今天到底是谁在为你的 token 买单
包月套餐对重度用户是低于成本价卖的。2026 年 6 月的报道,把一个月度用满的 $200 ChatGPT Pro 席位背后的算力,估在每月约 $14,000;一个月度用满的 Claude Max 席位,约 $8,000。同一篇报道引用 SemiAnalysis 说,一个 OpenAI Pro 席位一旦用户消耗超过套餐允许量的大约 5.7%,就不再盈利。
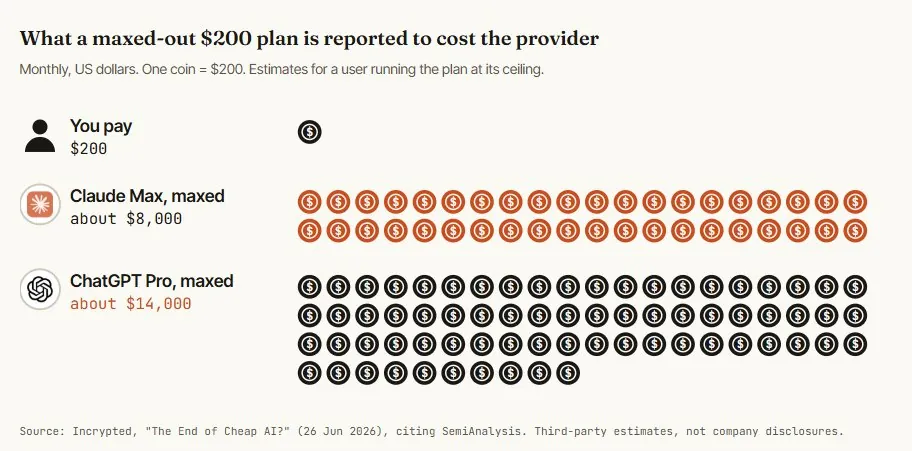
这么大的缺口,会从厂商那一头去补。2026 年 9 月 14 日,Anthropic 的 Claude Code 每周额度从夏季峰值下调了 17%。OpenAI 在 $200 档同价下调了额度,又在上面加了个 $500 档。没什么戏剧性——而这正是关键:你给 agent 工作的预算,是由别人的利润率定的。
LLMJunky,谈到新的 256 GB M5 Ultra Studio 能以接近一个 Max 订阅的价格租到:「一个月 $257,你就能拥有永远不会用完 token 的端侧智能,还很省电。」
本地并不比便宜的 API 每 token 更便宜。2026 年 9 月有一份分析,把 M5 Ultra Mac Studio 摊到每百万输出 token 的价格算在 €1.71 到 €2.22(硬件按三年摊销、全天候运行),而同样的开源模型走云 API 只要 $0.47。你上本地,是为了控制和不受计量限制的量。你不是为了在比价单上赢。
03. 目标——先挑活儿,再挑硬件
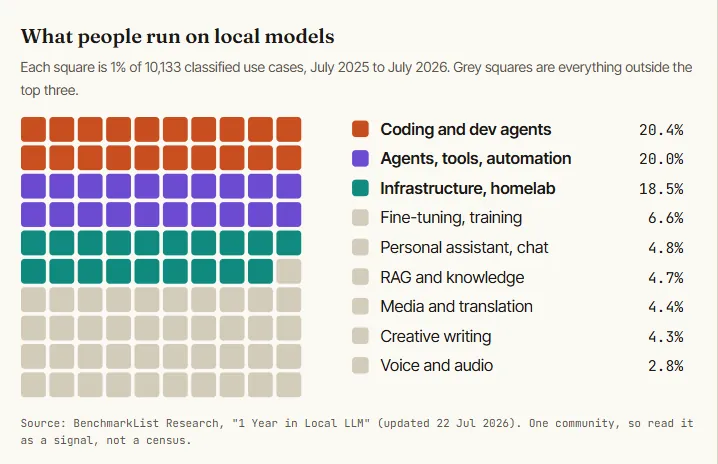
活儿决定模型,模型决定机器。先写任务清单。这是经得起实践检验的分法:从人们真正拿这些模型做什么开始。有一份分析,把一个本地 LLM Discord 群里一整年的消息,按 10,133 个使用场景做了分类。聊天只是脚注,agent 和编程占了全部的四成。
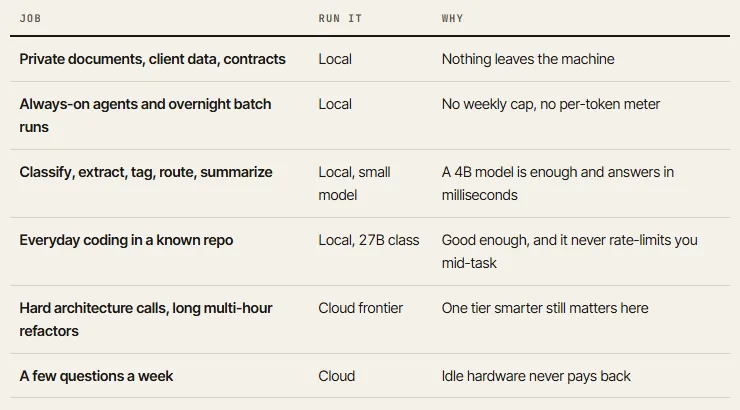
用下面这个提示词,让任何聊天模型把你这一周变成一份任务清单。它会逼出下一步需要的那些数字。
你在帮我评估一套本地 LLM 方案。什么也别问我。只按下面这份清单来。

我上周的 AI 任务
[粘贴 10 到 20 个真实任务:是什么、输入多长、多久一次]

对每个任务输出一行表格:
任务 | 是否含私有数据?(是/否) | 输入大小(tokens, 粗略) | 每天跑几次 |
需要前沿推理吗?(是/否, 一句话理由) | 能胜任的最小模型档
(4B / 12B / 27B / 100B+ / 前沿 API)

然后给我三个合计:
1. 本地模型每天会忙多少小时
2. 任何单个任务需要的最长上下文
3. 必须留在前沿 API 上的任务占比

不要推荐硬件。不要往上取整。如果有任务不清楚,就标
"不清楚",不要猜。
04. 硬件——先买内存,再买带宽,按这个顺序
生成一个 token,意味着把模型的每一个激活权重从内存里读一遍。所以两个参数决定了你的体验。内存大小决定哪些模型能加载得进。内存带宽,也就是芯片读内存的速度,决定 token 每秒的天花板。纯粹的算力排第三。
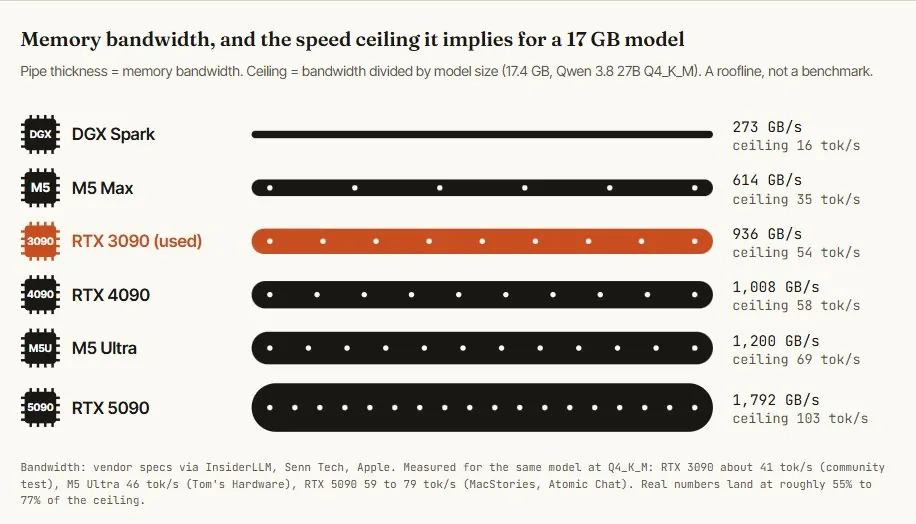
从那张表里能看出两种规律。英伟达卖的是非常快、但量少又贵的内存。苹果卖的是大池子、速度够用的内存,还附带一台电脑。如果你的模型能装进 24 到 32 GB,英伟达卡在速度和软件上赢。
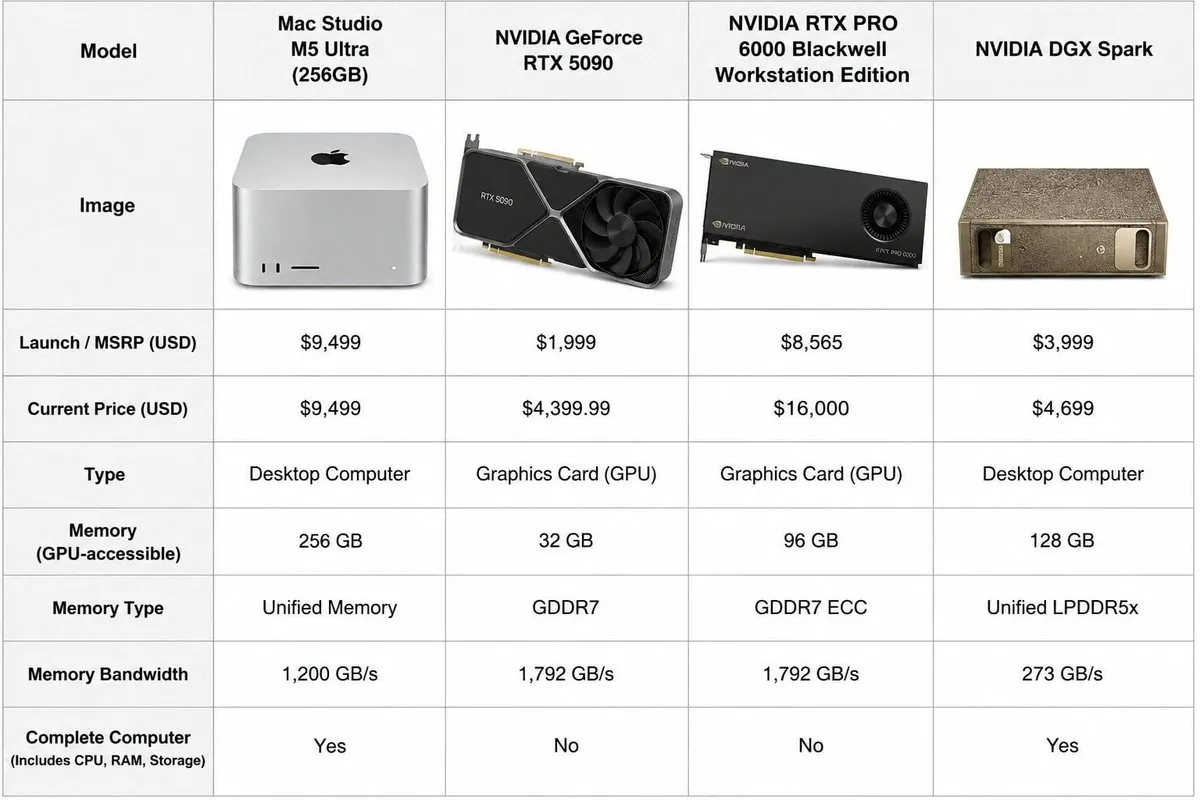
云端 RTX 3090 在 RunPod 社区档约 $0.22 一小时,4090 约 $0.34。花 $10 把真实负载放到租的卡上跑一个周末,在硬件发货前你就能知道需要哪款模型、它有多快。Vast.ai 是价格浮动的市场替代品。
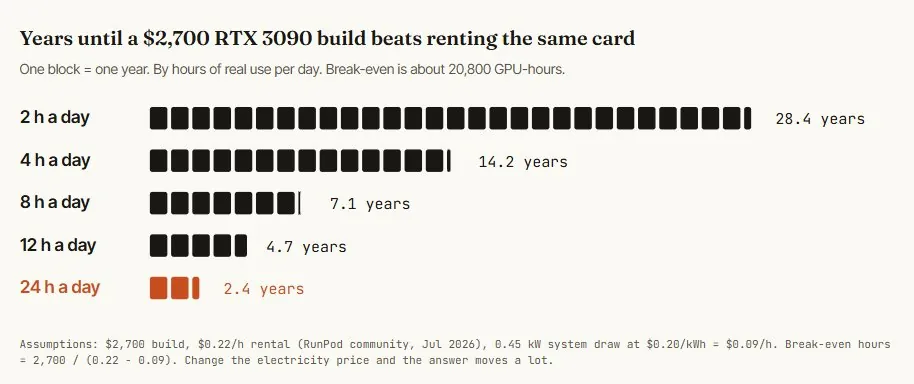
家用 AI 服务器只有在 GPU 全天干活时才回本。一天只用四小时,它就是一台硅片取暖器。
所以买硬件划算的场景是全天候负载:agent、批处理、一个小团队共用一台。不划算的场景是隐私、以及永远看不到上限横幅。两者都成立。你得清楚自己在为哪一个买单。
05. 模型——先看懂地图,再挑一个
Hugging Face 托管着每个开源模型的权重。你只需要认识屈指可数的几个家族,按它们想要多少内存排个序就好。接下来是数字。三张图告诉你的,是挑选时需要的大部分信息。
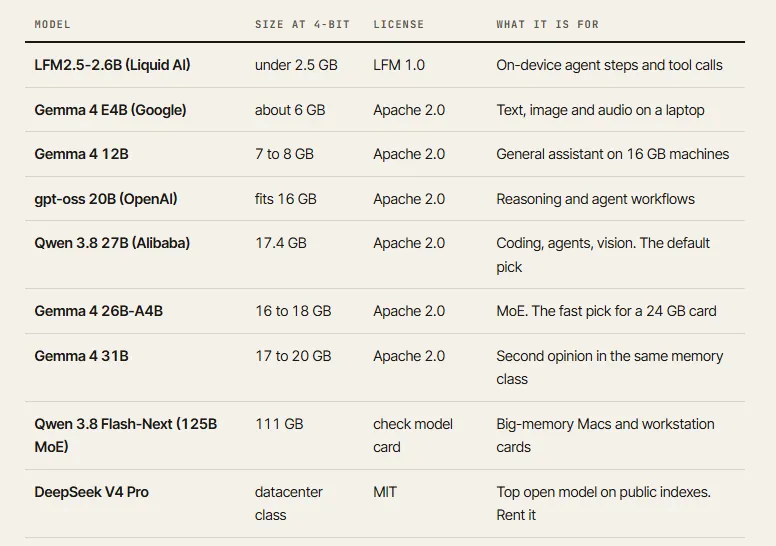
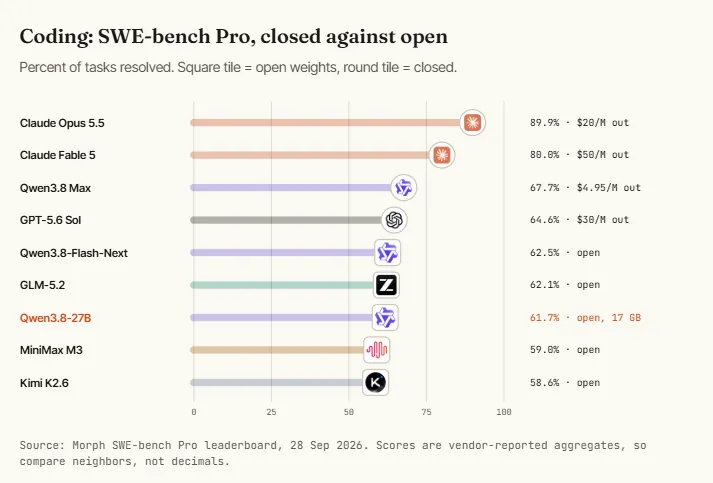
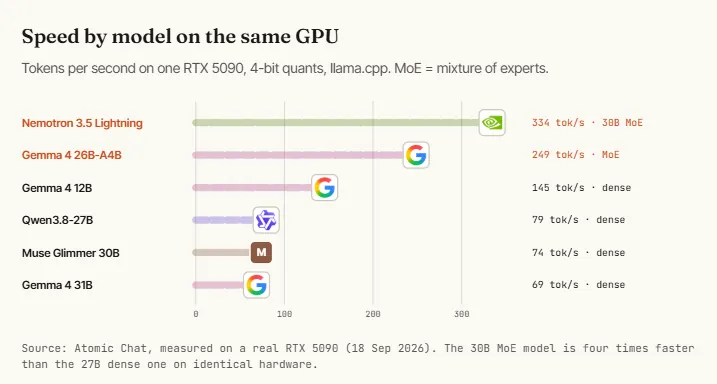
一个概念能帮你躲开常见错误。稠密模型每个 token 都用上它全部权重。专家混合(MoE)模型存很多权重,但每个 token 只激活其中一小部分。总参数量决定你需要多少内存。激活参数量决定它跑多快。这就是为什么一个 125B 的 MoE 模型,能在同一台机器上比稠密的 27B 生成得更快。
06. 量化——选那个刚好装进你内存的文件
模型权重出厂就是 16 位数字。量化用更少的位来存它们,文件就变小了。Qwen 3.8 27B 完整版是 55 GB。4 位时是 17 GB。8 月底的一份独立基准,测过这样做的代价。
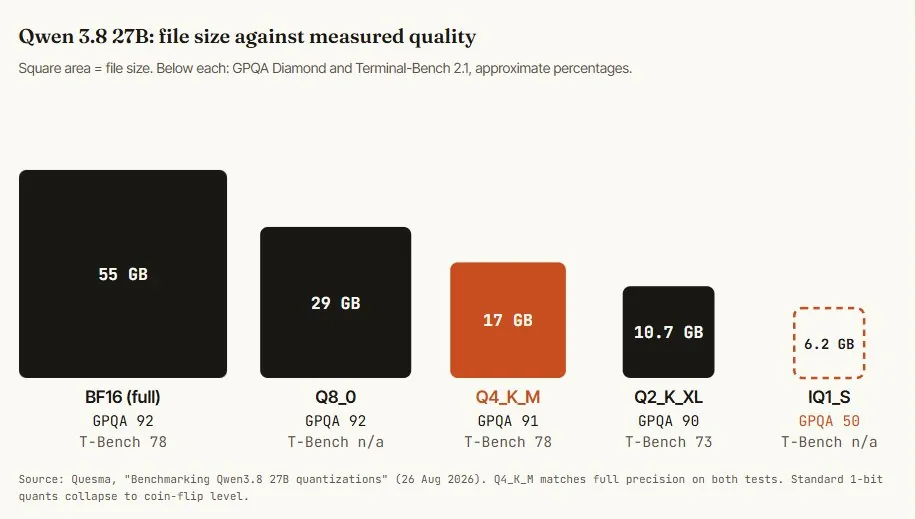
只有在模型装不下时才继续往下压,并且要预期 agent 类任务会比常识题先退化。文件只占内存账单的一半,另一半是上下文。Qwen 3.8 采用混合注意力设计,每个 token 存约 64 KB 缓存,只是经典 64 层模型的四分之一。
# 总占用 = 模型文件 + 上下文缓存 + 1 到 2 GB 运行余量

上下文     缓存     + Q4_K_M 17.4 GB    24 GB 装得下吗?
  8K       0.5 GB      17.9 GB           可以
 32K       2.0 GB      19.4 GB           可以
 64K       4.0 GB      21.4 GB           可以,偏紧
128K       8.0 GB      25.4 GB           不行 -> 降到 IQ4_XS (15.5 GB) 或 32 GB 卡
262K      16.4 GB      33.8 GB           不行 -> 48 GB+ 或统一内存
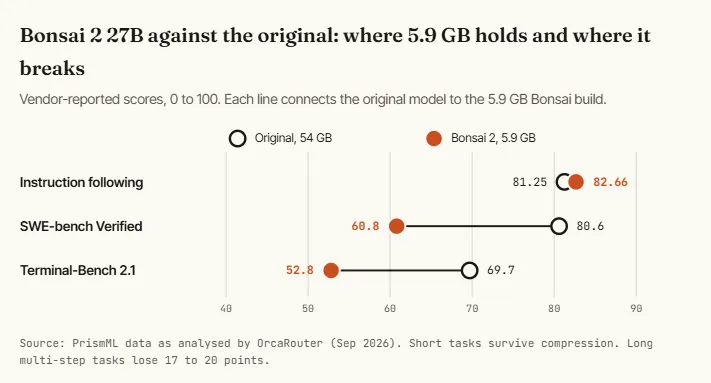
PrismML 的 Ternary Bonsai 2 27B(2026 年 9 月 17 日)是另一种技术,按每个权重 1.76 位训练,在 Apache 2.0 下落到 5.9 GB。PrismML 报告称,在它自己那套 20 基准套件上,保留了原版 98.2% 的综合分。
07. 运行——装一个引擎,把模型跑起来
你在第 0 步装好了 Ollama。现在把它配置到位:如果内存允许就换到主模型,并修掉对话默认很短的记忆。三种引擎覆盖几乎所有人。Ollama 是一条命令的路。LM Studio 是同样的思路,只是做成桌面应用。llama.cpp 是藏在两者底下的引擎,给你每一个设置。
# 1. 第 0 步已经装过。验证一下
$ ollama --version

# 2. 拉取并对话。18 GB 下载,含视觉。需要 24 GB 显存或 32 GB Mac
$ ollama run qwen3.8:27b

# Apple Silicon:用同一模型的 MLX 版本
$ ollama run qwen3.8:27b-mlx

# 3. 抬高上下文。默认窗口只有几千 token
$ OLLAMA_CONTEXT_LENGTH=65536 ollama serve
第三条命令,是本地 AI 最常见抱怨的解药。开箱即用时模型“聊几页就忘”,是因为服务器是以一个极小的窗口启动的。这个模型支持 262K。你得主动要,并且用内存来付(见上面的预算)。
保留第 0 步的模型,用更小的数字套同一套上下文设置:16 GB 上
OLLAMA_CONTEXT_LENGTH=16384是安全的起点。
第 8 到 10 步的一切,对任何模型名都成立。把 qwen3.8:27b 换成你的即可。想要完全掌控时,直接跑 llama.cpp。这部分是可选的。它会直接从 Hugging Face 下载你点名的量化文件。
# --jinja  用模型自己的聊天模板。不是可选项
# -ngl 99  把每一层都放到 GPU 上
# -c 65536 64K 上下文,约 4 GB 缓存
$ llama-server \
    -hf bartowski/Qwen3.8-27B-GGUF:Q4_K_M \
    --jinja \
    -ngl 99 \
    -c 65536 \
    --temp 0.7 --top-p 0.8 --top-k 20 \
    --port 8080
没有 --jinja,模型会越过错停符,或者把回答截短,然后人们就得出“这量化坏了”的结论。这是“这模型真烂”报告的最大单一来源。Ollama 和 LM Studio 会自动套用模板。
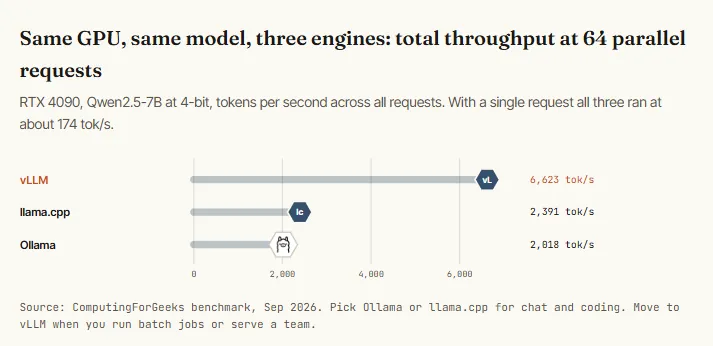
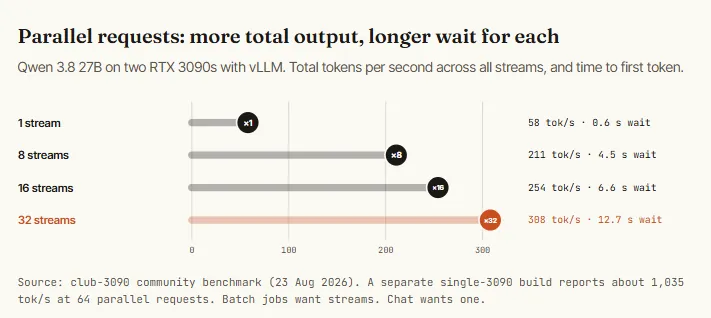
引擎会改变速度吗?对单个用户:不会。对大量并发请求:差别巨大。
08. 服务——把模型变成你的工具能调用的 API
聊天窗口里的模型是玩具。API 后面的模型是基础设施。Ollama 已经在 11434 端口上提供一个 OpenAI 兼容端点,还有一个 Anthropic 兼容端点,所以大多数工具只需改个 URL 就能连上。
$ curl http://localhost:11434/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
      "model": "qwen3.8:27b",
      "messages": [
        {"role": "system", "content": "用一句话回答。"},
        {"role": "user", "content": "什么是内存带宽?"}
      ]
    }'
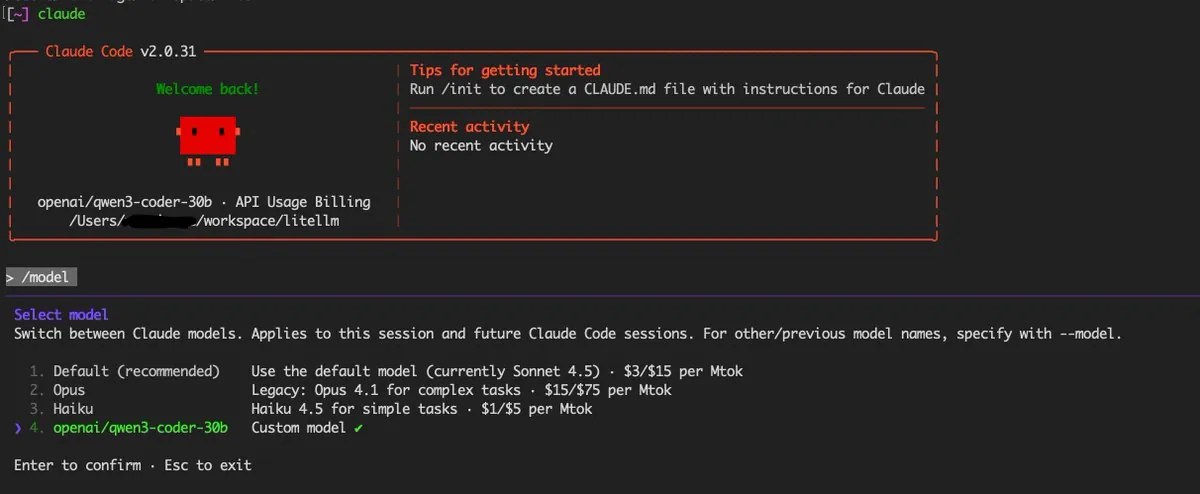
要让 Claude Code 指向本地模型,设两个环境变量。把它们写进设置文件,这样每次会话都会加载。
{
  "env": {
    "ANTHROPIC_BASE_URL": "http://localhost:11434",
    "ANTHROPIC_AUTH_TOKEN": "ollama"
  },
  "model": "qwen3.8:27b"
}
不会继承什么:Ollama 的 Anthropic 兼容 API 支持消息、流式、工具调用、视觉和思考。它不支持提示词缓存、token 计数、强制工具选择、PDF 或批处理。预期是一个能跑、但边角更糙的编程 agent,并至少给它 64K 上下文。
进阶细节:编程 agent 会在回合之间重写提示词的开头,这可能会丢掉服务器缓存,让每个回合都重算整个上下文。Unsloth 记录过本地模型的原因和修法。在怪你的 GPU 慢之前,先查这个。
09. 小模型——把无聊的 agent 步骤交给一个很小的模型
一个 agent 内部的大多数调用并不难。决定用哪个工具。从一页里抽三个字段。判断这条消息要不要人介入。英伟达研究院在 2025 年就主张,这类重复、边界清晰的口号属于小模型,并估算服务一个 7B 模型比 70B 到 175B 的便宜 10 到 30 倍。在他们的案例里,一个 agent 的 LLM 调用有 40% 到 70% 可以挪给小模型。
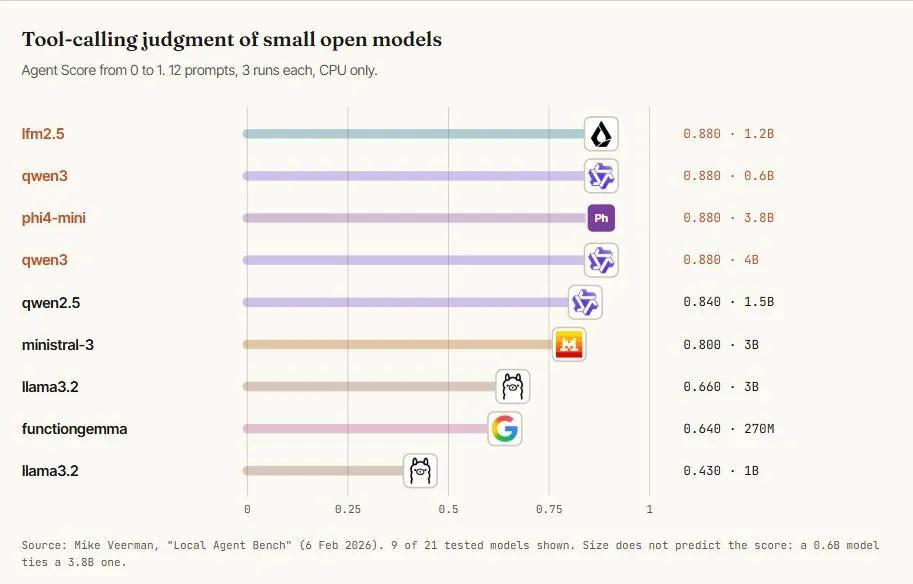
2026 年 2 月的一个基准,在无 GPU 的笔记本 CPU 上跑了 21 个小开源模型的工具调用判断。评分既奖励调对了工具,也同等奖励该安静时不去调。
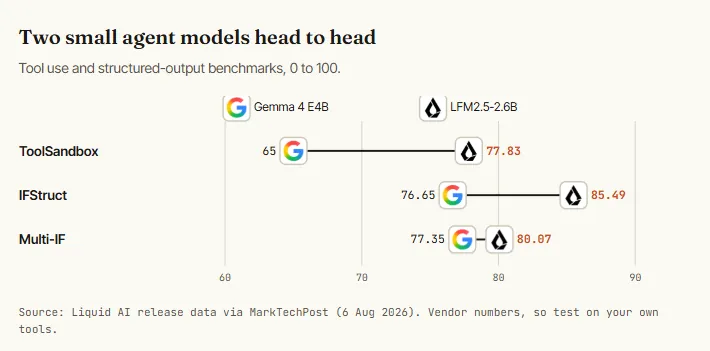
更新的小模型把这件事推得更远。Liquid AI 的 LFM2.5-2.6B(2026 年 8 月)在 2.5 GB 以内跑,带 131K 上下文,官方报告在 M5 Max 上 220 token/秒、手机上 30。
把容易的调用路由给小模型,只把真正需要的留给前沿。这个路由器,就是把整个思路装进一个文件。
from openai import OpenAI
import json

local = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")

ROUTER_PROMPT = """你是一个路由器。读任务,只回 JSON:
{"lane": "small" | "big" | "cloud", "reason": "<max 12 words>"}

small = 分类、抽取、打标、改写、是/否决策、一次工具调用
big   = 写或改代码、多步任务、任何涉及私有文件的事
cloud = 新的架构决策、本地失败过两次的任务

如果拿不准该走哪条,选更便宜的那条。"""

MODELS = {"small": "qwen3:4b", "big": "qwen3.8:27b"}

def route(task: str) -> str:
    verdict = local.chat.completions.create(
        model=MODELS["small"],
        messages=[{"role": "system", "content": ROUTER_PROMPT},
                  {"role": "user", "content": task}],
        response_format={"type": "json_object"},
        temperature=0,
    )
    lane = json.loads(verdict.choices[0].message.content)["lane"]
    if lane == "cloud":
        return call_frontier_api(task)        # 你付费的模型,很少用
    reply = local.chat.completions.create(
        model=MODELS[lane],
        messages=[{"role": "user", "content": task}],
    )
    return reply.choices[0].message.content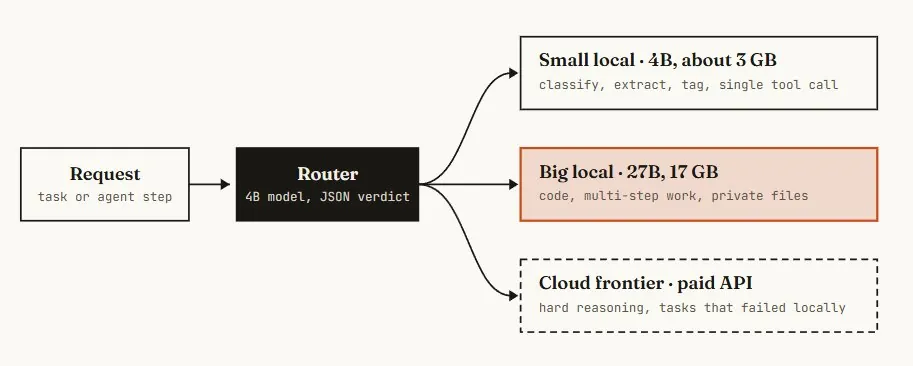
10. 度量——基准你自家的环境,然后走混合
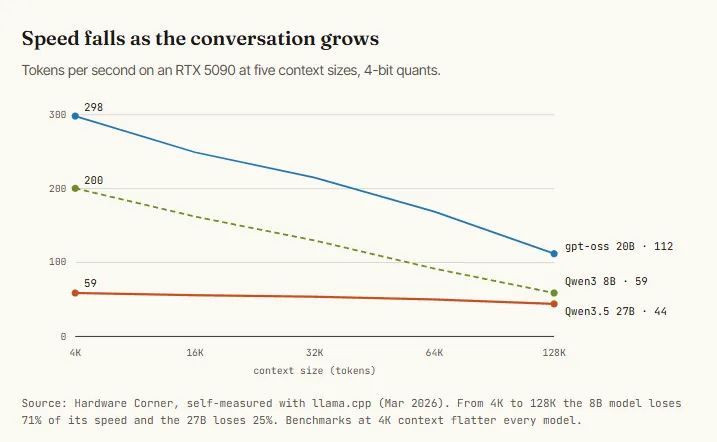
X 上的速度数字,是在别人的机器、量化、上下文长度和引擎上测的。你的会不一样。两条命令给你真相。
# Ollama:打印提示词评估速率(prefill)和生成评估速率(decode)
$ ollama run qwen3.8:27b --verbose "用 200 词解释 KV 缓存。"

# llama.cpp:针对 GGUF 文件的可重复基准
$ llama-bench -m Qwen3.8-27B-Q4_K_M.gguf -ngl 99

# 模型是否完全在 GPU 上?找 "100% GPU"
$ ollama ps
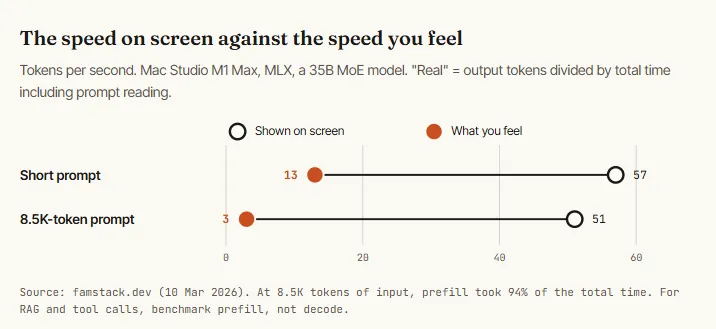
用这条标尺读结果:每秒 20 token 可用,50 舒服,100 及以上比大多数云 API 感受还快。盯两个数,因为它们坏的方式不一样。
质量也要在自己的活上测。留一个包含十个你已知正确答案的文件,拿它跑你考虑中的每个模型和每档量化。
按顺序跑下面每个任务。每个任务都打印:答案,然后一行
"SELF-CHECK:" 说明答案可能错在哪一种方式。

1. [我仓库里一个真 bug + 失败的测试输出]
2. [一份合同条款] -> 抽取双方、日期、金额为 JSON
3. [20 条客服消息] -> 每条打标:billing / bug / feature / other
4. [一张仪表盘截图] -> 列出你能读出的每个数字
5. [一份 30 页文档] -> 回答三个答案在第 24 页的问题
...
10. 一个正确答案是"我从这份输入里看不出来"的任务。
本周的六个工作负载
搭建完成。下面是立刻可以交给这套栈的六件活,从五分钟到一晚上,按顺序排。每一件都是一份可以直接粘贴的完整文件。任务 B、C、D 是简短 Python 脚本。开始前先跑一次:它会为 Python 包建一个私有文件夹,这样你电脑上其余的东西都不受影响。
A. 由 3 GB 模型写提交消息。最小但最有用的一件活。一个 git hook 读取你暂存的 diff,在编辑器打开前就把消息草拟好。一两秒跑完,从不离开笔记本。
#!/bin/sh
# 保留你自己敲的消息 (-m, merge, amend)
[ -n "$2" ] && exit 0
DIFF=$(git diff --staged | head -c 12000)
[ -z "$DIFF" ] && exit 0

printf '为这个 diff 写一条 git 提交消息。
第 1 行:祈使句摘要,最多 60 字符。
然后空一行,再接最多 3 条要点:改了什么、为什么。
不要开场白。不要代码围栏。

%s' "$DIFF" | ollama run qwen3:4b --think=false > "$1"qwen3:4b,约 3 GB。关掉了思考,因为提交消息用不着它,而且 hook 应该瞬时。
B. 批量分诊——一夜给一千张工单打标。分类是本地模型回本最快的地方:成千上万次小调用,没有按 token 的账单,数据也不用离开公司。
import asyncio, csv, json
from openai import AsyncOpenAI

client = AsyncOpenAI(base_url="http://localhost:11434/v1", api_key="ollama")
limit = asyncio.Semaphore(8)

PROMPT = """给这张客服工单打标。只回 JSON:
{"category": "billing" | "bug" | "feature" | "account" | "other",
 "urgency": 1 | 2 | 3,
 "needs_human": true | false,
 "summary": "<max 15 words>"}
urgency 3 = 丢钱、丢数据、或无法登录。
如果工单不清楚,category 为 "other" 且 needs_human 为 true。"""

async def label(row):
    async with limit:
        r = await client.chat.completions.create(
            model="qwen3:4b", temperature=0,
            response_format={"type": "json_object"},
            messages=[{"role": "system", "content": PROMPT},
                      {"role": "user", "content": row["text"]}])
        return {**row, **json.loads(r.choices[0].message.content)}

async def main():
    rows = list(csv.DictReader(open("tickets.csv")))
    done = await asyncio.gather(*(label(r) for r in rows))
    with open("labeled.csv", "w", newline="") as f:
        w = csv.DictWriter(f, fieldnames=done[0].keys())
        w.writeheader(); w.writerows(done)

asyncio.run(main())
在信任其余 950 个之前,先手工抽查 50 个标签。如果小模型和你在 5 个以上不一致,只把 needs_human 的行重新跑 27B 模型。
C. 私有文档——在你自己的文件里问问题。合同、客户笔记、研究资料。文件只嵌入一次,然后每个问题都把最相关的五个片段拉进提示词。四十行,不需要向量数据库。
import pathlib, numpy as np, ollama

docs   = [p.read_text() for p in pathlib.Path("notes").glob("**/*.md")]
chunks = [d[i:i + 1200] for d in docs for i in range(0, len(d), 1000)]

def embed(texts):
    v = np.array(ollama.embed(model="nomic-embed-text", input=texts)["embeddings"])
    return v / np.linalg.norm(v, axis=1, keepdims=True)

index = embed(chunks)                        # 只跑一次,大了就缓存到磁盘

SYSTEM = """只根据 CONTEXT 回答。回答后,把你依据的那句原文引出来。
如果上下文里没有答案,就回"Not in these documents."不要用外部知识。"""

def ask(question, k=5):
    top = np.argsort(index @ embed([question])[0])[-k:][::-1]
    context = "\n---\n".join(chunks[i] for i in top)
    r = ollama.chat(model="qwen3.8:27b", messages=[
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": f"CONTEXT:\n{context}\n\nQUESTION: {question}"}])
    return r["message"]["content"]

print(ask("我们和房东约定的通知期是多久?"))
每天这么用的人都说同一句话:检索没有看起来那么玄,大部分功夫在调块大小、以及你给模型看什么。先用上面 1,200 字符的块,再用十个你知道答案的问题测。
D. 视觉——把一张发票照片转成 JSON。Qwen 3.8 27B 原生读图。给它一个 schema,它就返回结构化数据,把收据、截图和扫描件变成本地活儿。
import json, ollama

SCHEMA = {
  "type": "object",
  "properties": {
    "vendor":   {"type": "string"},
    "date":     {"type": "string", "description": "YYYY-MM-DD"},
    "currency": {"type": "string"},
    "total":    {"type": "number"},
    "line_items": {"type": "array", "items": {"type": "object", "properties": {
        "name": {"type": "string"}, "amount": {"type": "number"}}}},
    "unreadable": {"type": "array", "items": {"type": "string"}}
  },
  "required": ["vendor", "date", "currency", "total", "unreadable"]
}

r = ollama.chat(
    model="qwen3.8:27b",
    format=SCHEMA,
    options={"temperature": 0},
    messages=[{"role": "user",
               "content": "抽取发票字段。把所有你没看清的字段列到 "
                          "'unreadable' 下。绝不要猜数字。",
               "images": ["invoice.jpg"]}])

print(json.loads(r["message"]["content"]))
unreadable 这个字段才是关键。没有一个明确的地方说“这个我没看清”,视觉模型就会用一个像模像样的数字去填坑。在代码里核对每行合计是否等于总额,而不是在提示词里核对。
E. 编程 agent——给它一个技能和一个 MCP 服务器。把 Claude Code 指向本地模型(第 8 步)后,再加两个小文件。一个技能教 agent 一条它应该严格遵循的流程。一个 MCP 服务器给它一个工具。本地模型最适合窄而明确的要求,所以两者都保持简短。
---
name: local-review
description: 在提交前审查暂存的 diff。当用户说
  "review"、"check my changes",或问某件事是否安全可提交时使用。
---
# Local review

1. 运行 `git diff --staged`。如果为空,说出来并停止。
2. 完整读每个改动的文件,而不是只看 diff 片段。
3. 按这个顺序报告:bug、缺测试、风险改动。最多 10 行。
4. 每个 bug 给出 file:line 和一行的修法。不要改任何文件。
5. 如果不确定某事是不是 bug,标成 "unsure"。
6. 最后单独一行给一个词:COMMIT 或 HOLD。
{
"mcpServers": {
"docs": {
"command": "npx",
"args": ["-y", "@modelcontextprotocol/server-filesystem", "./docs"]
}
}
}每个工具定义都是模型每回合要读的 token。在本地模型上,那是你能感受到的预填充时间。一两个 MCP 服务器是对的数量。十个,就是你 agent 打声招呼要 40 秒的原因。
F. 夜班——你醒来时已有一份摘要。这是证明买硬件划算的那个负载:一件你睡觉时每天跑、边际成本为零的活。这里它读昨天的提交和未关闭的 TODO,写一份晨报。
#!/bin/sh
cd ~/code/myrepo || exit 1
{
  echo "COMMITS SINCE YESTERDAY:"
  git log --since=yesterday --pretty='%h %an %s'
  echo
  echo "OPEN TODOS:"
  grep -rn "TODO" src | head -50
} | ollama run qwen3.8:27b --think=false "用 markdown 写一份晨间摘要。
分节:昨天交付的 / 看着没做完的 / 今天先做这 3 件。
只依据输入的事实。如果输入为空,就写 'Nothing new.'" \
  > ~/digests/$(date +%F).md

# 定时:crontab -e
# 30 6 * * * ~/bin/nightly-digest.sh
把输入换一下,同样这二十行就变成收件箱摘要、竞品更新监视器、或者转写清理器。模式永远一样:用 shell 工具收文本,用严格输出格式喂给模型,写成一个文件。
结论
租一个周末。为负载而买。把一切路由起来。
你跑的第一个本地模型,会比租来的慢一点、也笨一点。但它是你的:没有上限、没有计量、没有数据离开房间。从你已有那台机器上的一条命令开始,量一量,让数字告诉你该买什么。
来源:Movez(@0xMovez),《How to set up your first Local LLM in 10 Steps (Full-course)》,X 文章,2026-10-04,x.com/0xMovez/status/2106761689123139973。
原文来源:Movez (X)https://x.com/0xMovez/status/2106761689123139973