Skip to content
← 标签

#多智能体 (13)

AI 编程开发梯顶C

Qoder:阿里的 agentic platform for real work,九条产品线共用一套知识引擎

阿里巴巴的智能体编码平台,官方定位 agentic platform for real work:不是一个编辑器,而是一条端到端闭环——理解任务与上下文 → 规划 → 调工具执行 → 验证结果 → 朝交付物迭代,三条底层理念是上下文工程、agent 自主性与目标导向循环;九条产品线共用一套知识引擎(桌面 Qoder 与 Qoder IDE 并存互不替代、Editor 与 Quest 双形态、JetBrains 插件、Qoder CLI、云端 agents 等),会话历史与 memory 分开存但可从 IDE 导入。Repo Wiki 由多 agent 在本地生成、不上传代码库,默认关闭,支持 Auto Update / Auto Export / Citation 回指源码位置。Quest 有四种驱动方式:Agent / Experts / Goal / Spec(可转定时任务)——Spec 走需求澄清(多选题形式,可 Recommend / Continue / Skip)→ 结构化 Spec(需求、设计、任务拆解、验收标准)→ 人工评审 → 执行 → Review/Commit/Push;Goal 只描述结果,每轮结束评估进度、未达成自动进下一轮。两个规模化案例:用 Qoder 造 Qoder(10 人 3 周,50 万行 agent 代码并入 400 万行遗留系统,99% 由 agent 生成,到 v1.4.0 仍在生产运行且零线上事故;方法是认知底座 + Ultra Spec + Experts 交叉评审 + verifier agent 反向过滤幻觉问题,人只做 SLO 定义与不可逆操作的最终决策,人均每天主导 20 多个 Experts 任务);高德车机 AutoSDK 跨 20 多个仓库、超百万行,严格一次通过率 37.3% → 61.5%(问题定性引 KoCo-Bench / arXiv:2601.13240v3:通用编程 Pass@1 可达 90%,领域代码生成只有 8.9%)。边界:客户端与知识引擎不开源;全部规模化数据出自官方案例与厂商自述,自家产品自证存在方法学自利偏差,未独立复算;Experts 单位成本明显高于单 agent(中位数约 75 vs 50 Credits),Credits 周期清零不能囤。置信度 C(厂商宣称)。
500,000 行 · 99% agent 生成10 人 3 周并入 400 万行遗留系统(厂商案例)厂商宣称 · 2026
产品Alibaba官网Repo
Qoder:阿里的 agentic platform for real work,九条产品线共用一套知识引擎
World Action Agent:让 VLM 在视觉动作工作区里驾驶机器人

World Action Agent:让 VLM 在视觉动作工作区里驾驶机器人

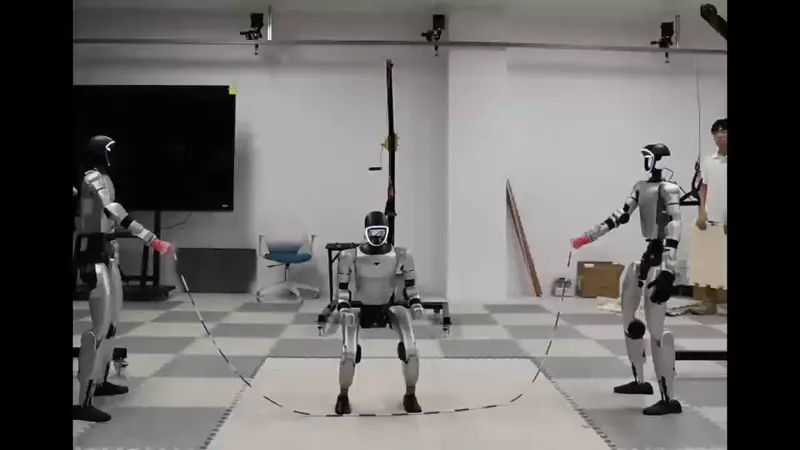
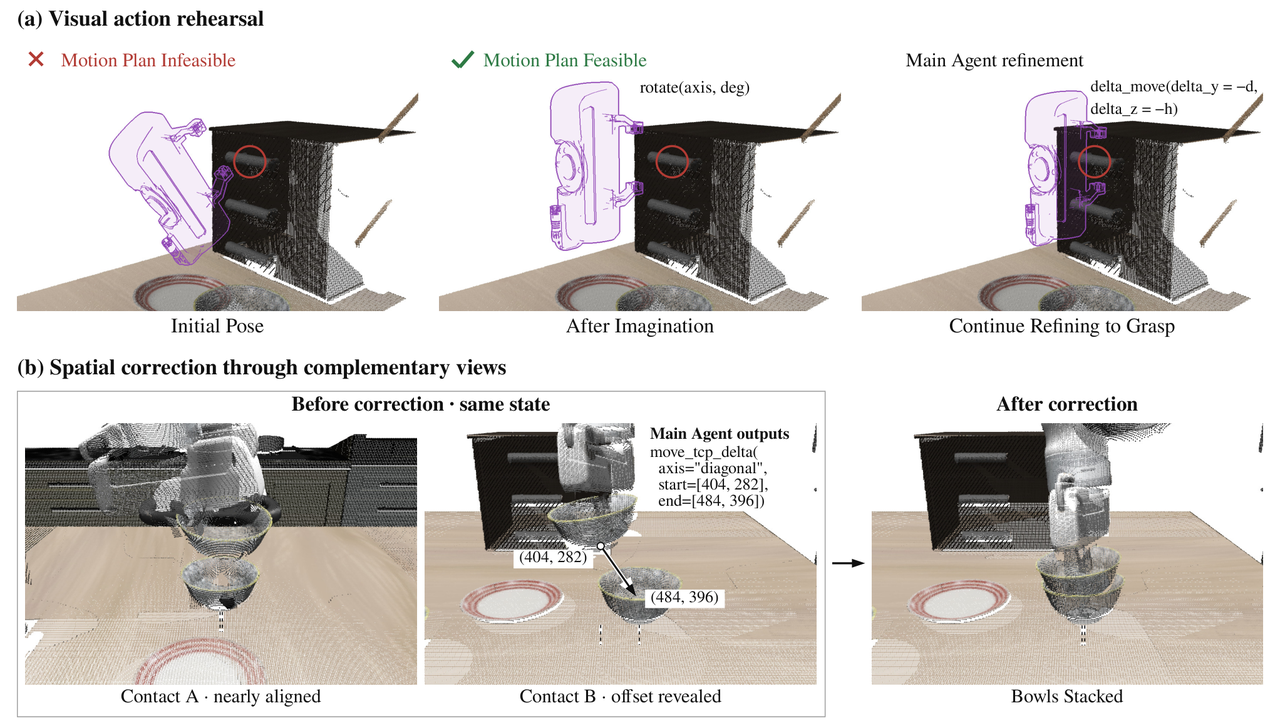
香港科技大学(广州)、香港中文大学与 Knowin AI 提出 World Action Agent(WAA),一个多智能体 harness——它不改 VLM,而是改 VLM 看到什么、以及它的决策如何生效,让通用 VLM 只用点选、拖拽、预览、执行等基础工具就能驾驶机器人,所有决策都在同一个「视觉动作工作区」内完成。工作区有三个性质:其一是 Contact views,根据交互区域、遮挡、取景紧凑度、视点冗余与稳定性主动求解相机参数,且约束两个视图的水平投影正交,使任何对齐误差都能沿两个独立方向被读出,且只需基坐标系点云,因此对 RGB-D 融合、仿真渲染或 VGGT 重建等感知来源完全无关;其二是动作试演,把每个动作表示为可编辑提案,由 cuRobo 规划后以半透明机器人叠加到各视图并报告可行性,Imagination Agent 在物理场景不变的独立上下文中反复修订,只有具备可执行规划的提案才能变成物理运动;其三是视图内修正,智能体在观察到误差的 Contact view 中从参考点拖到期望位置,参考点可以是所持物体上的可见点,因此无需先把关系换算成绝对位姿。技能侧由 Learner、Editor、Reviewer 三个角色在证据与独立审核约束下从专家视频与人类 Canvas-GUI 教学中进化出关系型多模态技能库。LIBERO-Pro 上以 Gemini 3.7 Flash 为骨干、仅用 LIBERO-90 进化并冻结的技能取得 75.6% 平均成功率的 SOTA,超过 ASPIRE(72.0%)、端到端 VLA 与同骨干的 Show-Harness(6.7%),Spatial 两个切分达 80.0 / 73.3;每回合仅 31 次模型调用、150 秒、0.1996 美元,远低于 Show-Harness 的 120 次、874 秒、0.5021 美元。同一套冻结技能迁移到 robosuite 达 100.0%;用 112 条轨迹(1,774 决策步)LoRA 微调 Qwen3.5-9B 只替换主智能体,域外成功率从 1.7% 提升至 43.3%。

Yehang Zhang, Haojian Huang, Yifan Chang2026年9月24日
World Action AgentWAA视觉语言模型2026年9月24日