Nemotron 3 Diarization 实测:1 亿参数实时说话人分离,本地跑效果超预期
视频加载中
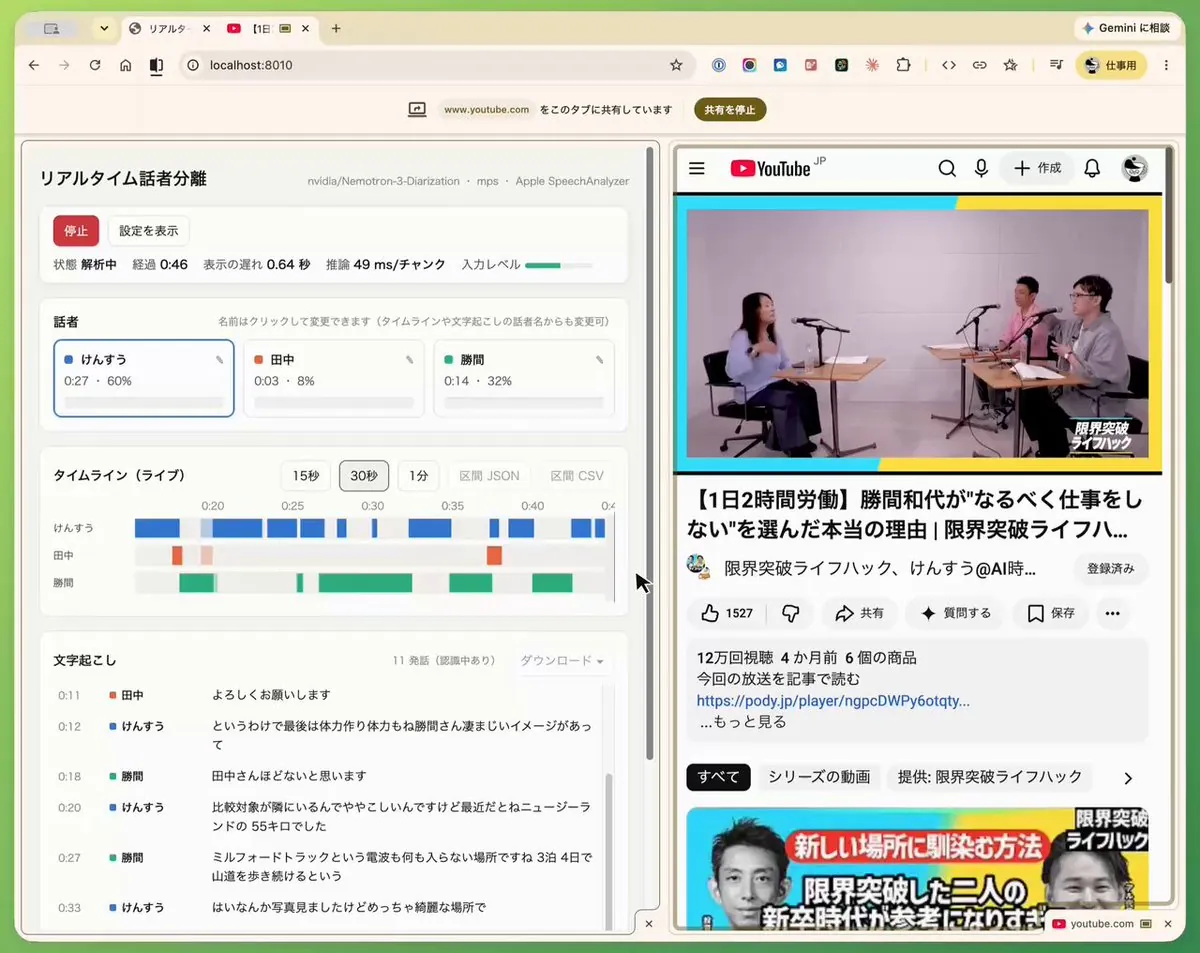
视频加载中日本开发者 @ouchi 测试 NVIDIA 9 月 23 日开源的 Nemotron 3 Diarization 说话人分离模型:实时流式下精度相当不错。该模型约 1 亿参数,基于 Streaming Sortformer 架构(31 层 Transformer + Arrival-Order Speaker Cache),单次前向即完成分离,支持最多 8 个说话人、10 毫秒分辨率、最低约 320 毫秒流式延迟,OpenMDW 1.1 许可,4GB 显存即可跑。作者观察:模型会边听边积累各说话人声纹特征,长音频离线分析精度略高于实时;HF 在线 demo 只支持 2 分钟音源所以效果一般,本地跑效果超出预期。VoiceArena Diarization-Bench 榜一(DER 14.72%)、AISHELL-4 9.8%(前代 27.2%)。语音 Agent 感知「谁在说话」的关键拼图,机器人语音交互直接相关。
Category: voice-interaction
Author: @ouchi
Date: 2026-09-27T00:00:00
Duration: 53.866s