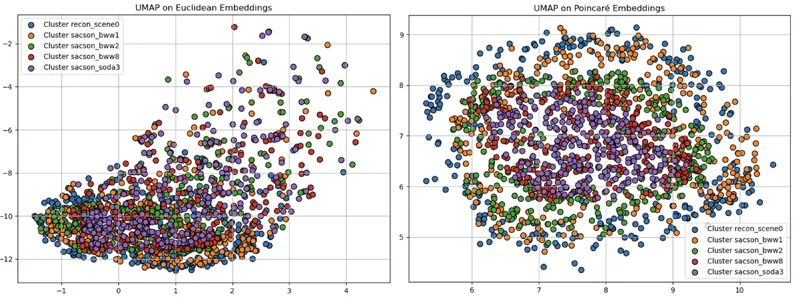
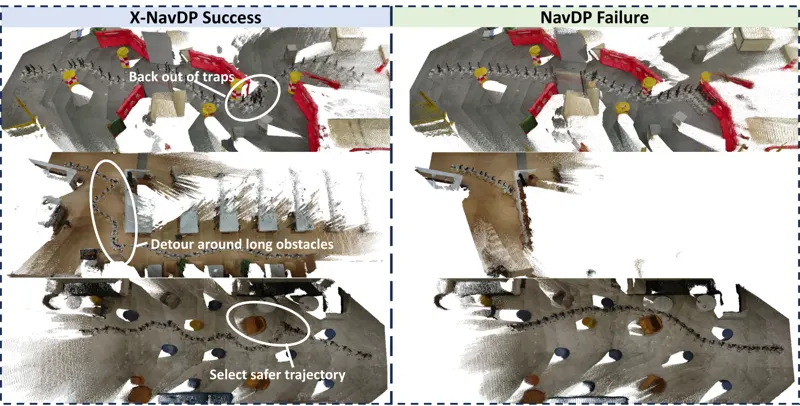
论文提出HyperDCM,把RGB观测转为场景图并映射到Poincaré双曲空间,再用结构敏感动态聚类维护回放样本,缓解扩散导航策略跨场景训练的灾难性遗忘。
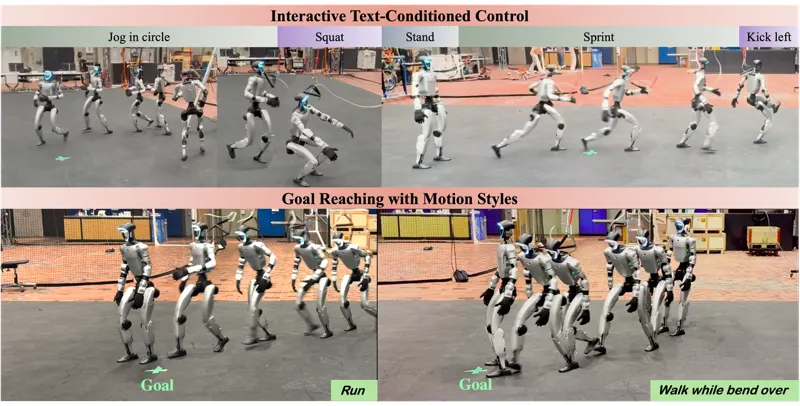
苏黎世联邦理工提出 ADAPT:文本条件扩散技能先验加约束残差强化学习,在 Unitree G1 上实现实时指令切换的端到端全身控制,并可通过噪声引导复用冻结先验完成风格保持的目标到达。
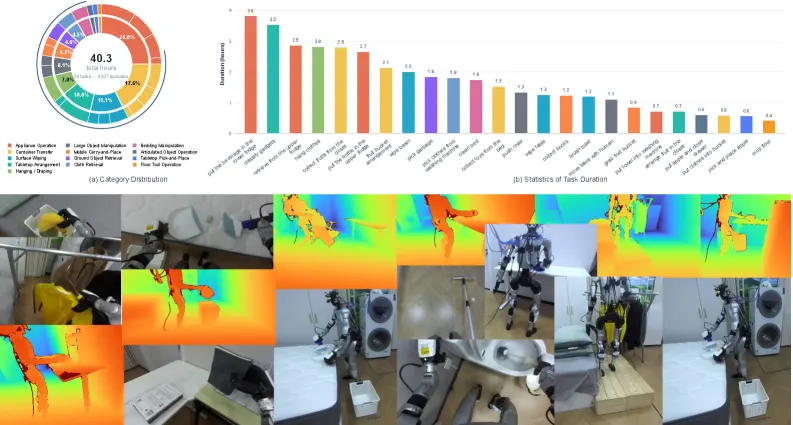
提出ω-0,面向真实人形机器人协同移动操作的全身世界动作模型:给定语言指令、视觉观测与本体状态,直接预测控制器可执行的全身动作潜变量;以轻量未来观测嵌入预测替代视频重建,耦合潜空间视觉预见与扩散式全身动作生成;并采集40+小时真机数据集ω-HOME,在11项家庭任务上稳定超越IL/VLA/人形/WAM基线。
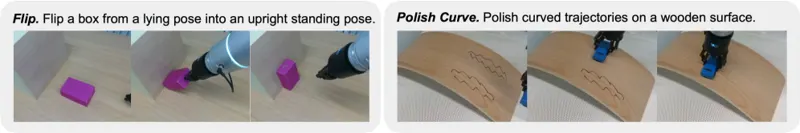
通过仿真与真机实验证明:动作分块的收益并非来自时间一致性、视界缩减或表征学习,而是来自非马尔可夫表达能力、基于延迟观测降低复合误差,以及隐式集成效应;并据此提出随机延迟集成与显式集成策略,可在无需动作分块的情况下匹敌甚至超越其性能。
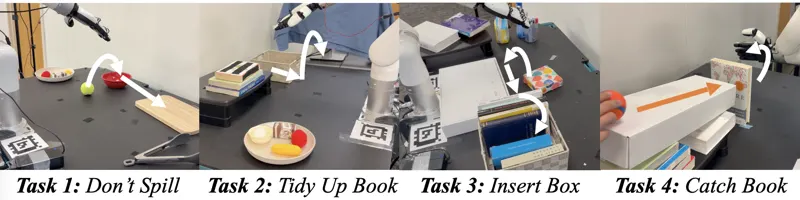
将扩散流操作策略变为反应式实时控制:快速本体感知通道+异步视觉通道+延迟自适应流调度,单步去噪每帧重规划,在真实机械臂上达 25Hz,成功率提升 30%。
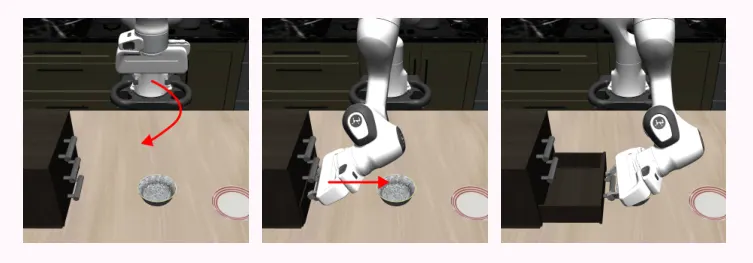
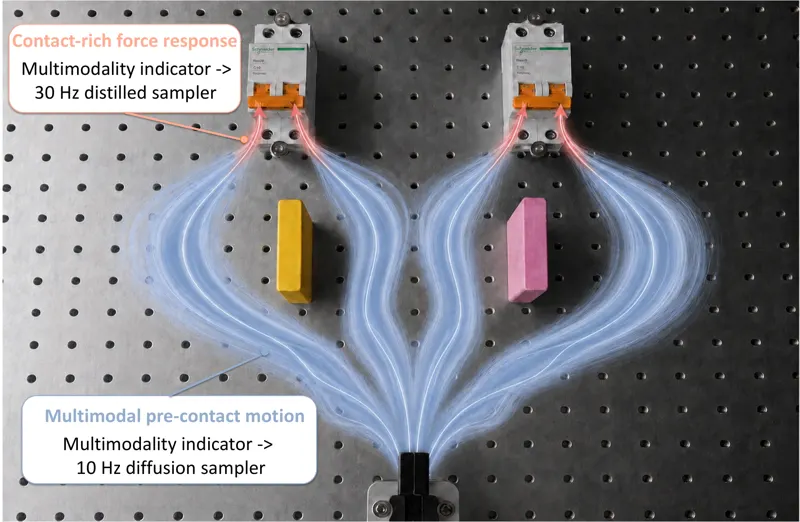
接触前需保留多模态轨迹、接触后需快速响应力反馈——FA-RDP 用共享多频率视觉-力 Transformer 同时预测高低频动作块,并学习多模态指示器在接触前多步低频采样、歧义降低后切换单步高频采样;配合流形一致性蒸馏,在三个接触密集任务上取得最高成功率。
提出GQRM强化学习后训练框架,通过自举探索与群组Q值归一化机制对导航扩散策略进行跨本体微调,仿真成功率从61%提升至84%,真实世界从10%提升至65%。
本文提出异步多模态扩散策略组合方法,通过延迟感知引导融合,解决多模态传感延迟下的策略执行问题。