Skip to content
OpenVLHarness:真实世界视觉智能体工具调用与多模态记忆

OpenVLHarness:真实世界视觉智能体工具调用与多模态记忆

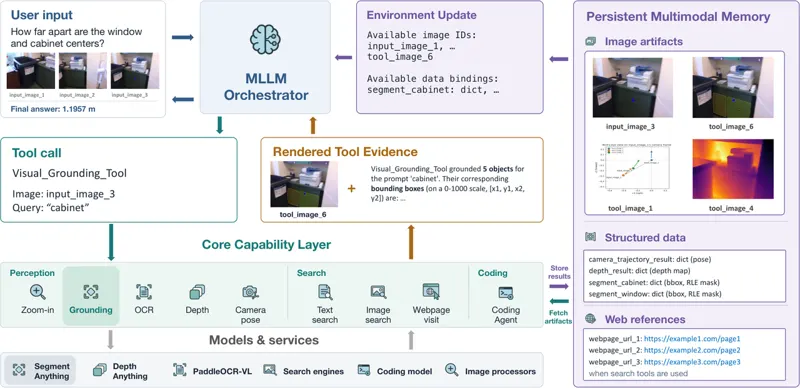
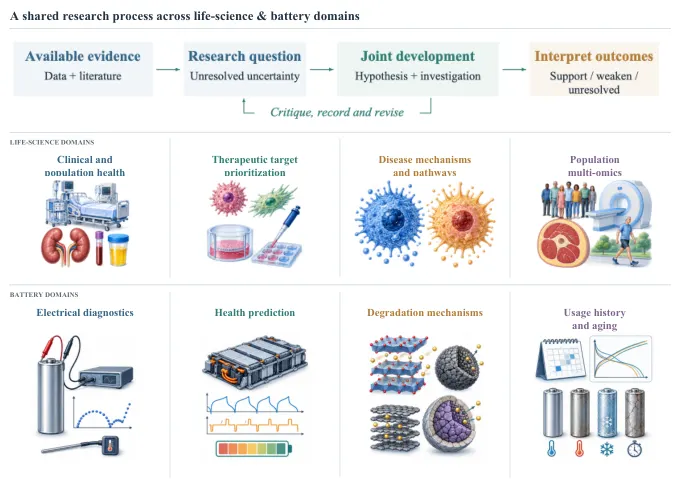
多模态大语言模型(MLLM)在视觉推理上进步迅速,但许多任务所需的证据无法仅靠内部推理获得:作者在 22 个基准上的对照实验显示,单纯提高基础模型的推理预算只能带来有限提升。这类任务需要接地感知、外部知识与数值测量,且来自异构工具的输出必须被模型读懂、并在多轮推理之间保留。本文提出 OpenVLHarness,一个围绕「能力层」与「持久多模态记忆」组织起来的多模态推理 harness。能力层把任务级工具接口与证据渲染结合在一起,为异构后端提供一致的访问方式,并把它们的输出转换成模型可读的观察;持久多模态记忆在整条查询过程中,把相应的图像、结构化数据与网页引用保存为可寻址工件;编码接口则在已存数据上执行生成的程序,实现跨工具结果的组合计算。三者共同支撑「获取—检视—组合」多模态证据的迭代过程。在 22 个基准、8 个开源与闭源骨干上的评测中,OpenVLHarness 相对同配置无工具基线平均提升 9.7–12.6 分,其中 Qwen3-VL-8B 提升 11.2 分、Kimi K3 提升 9.7 分、GPT-6 Astra 提升 9.9 分;GPT-6 Luna 在中等推理预算下,OpenVLHarness 比最大推理预算下的基础模型、Codex 与 Visual Sketchpad 高 7.7–8.5 分,而模型 token 开销最多只有它们的 37%。

Multimodal ReasoningTool Use
Yu Zhou, Cheng-Fu Yang, Rui Sun · 486次阅读 · 2026年10月19日
感知人形跑酷:通过动作匹配串联动态人类技能

感知人形跑酷:通过动作匹配串联动态人类技能

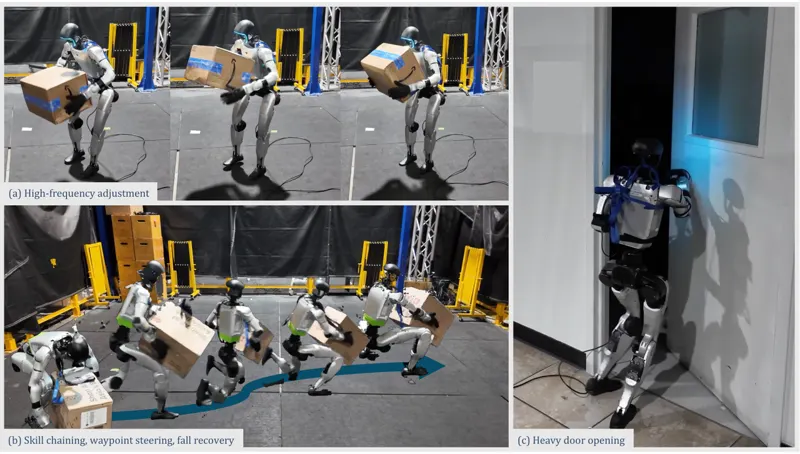
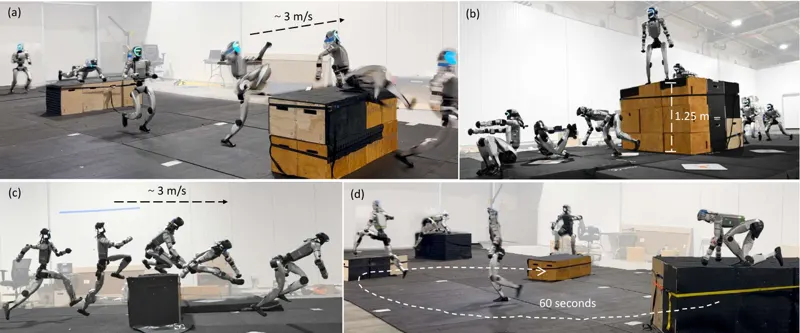
尽管人形机器人的运动控制近来已在多种地形上实现稳定行走,如何获得高动态人类动作那般的敏捷性与适应性,仍是一个开放问题。尤其是在复杂环境中的敏捷跑酷,不仅要求底层控制的鲁棒性,还要求类人的动作表现力、长时程的技能组合,以及由感知驱动的决策能力。本文提出感知人形跑酷框架 PHP(Perceptive Humanoid Parkour):一个模块化系统,使人形机器人能够在具有挑战性的障碍场地上自主完成长时程、基于视觉的跑酷。方法首先把动作匹配(motion matching)表述为特征空间中的最近邻检索,用它把重定向后的原子人类技能组合成长时程运动学轨迹;这一框架让复杂技能链既能灵活组合、又能平滑过渡,同时保留人类动态动作的优雅与流畅。随后,我们为这些合成动作训练基于动作跟踪的强化学习(RL)专家策略,并用 DAgger 与 RL 相结合的方式把它们蒸馏成单个基于深度图的多技能学生策略。关键在于,感知与技能组合的结合带来了自主的、随场景而变的决策能力:仅凭板载深度传感与一条二维速度指令,机器人就能自行判断应当跨过、爬上、撑越还是翻下几何形状与高度各不相同的障碍。我们在 Unitree G1 人形机器人上以大量真机实验验证该框架,展示了诸如攀爬最高 1.25 m(相当于机器人身高 96%)障碍这类高动态跑酷技能,以及在障碍被实时扰动时闭环适应的长时程多障碍穿越。

人形机器人跑酷
Zhen Wu, Xiaoyu Huang, Lujie Yang · 256次阅读 · 2026年2月17日

本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。