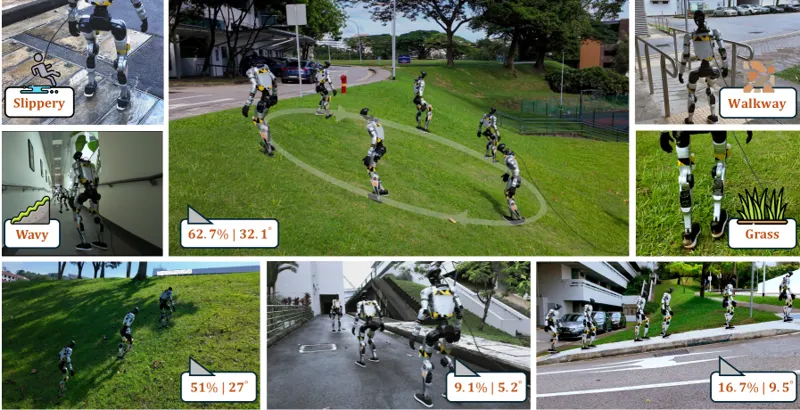
两阶段框架:Stage I 用坡面自适应 ZMP 正则化建立平衡先验,Stage II 用生物力学步态适配器(BSGA)根据地形描述符调节质心高度和下肢协调——上坡髋驱动、下坡膝制动。盲感知在 Unitree G1 上实现 36° 陡坡行走。
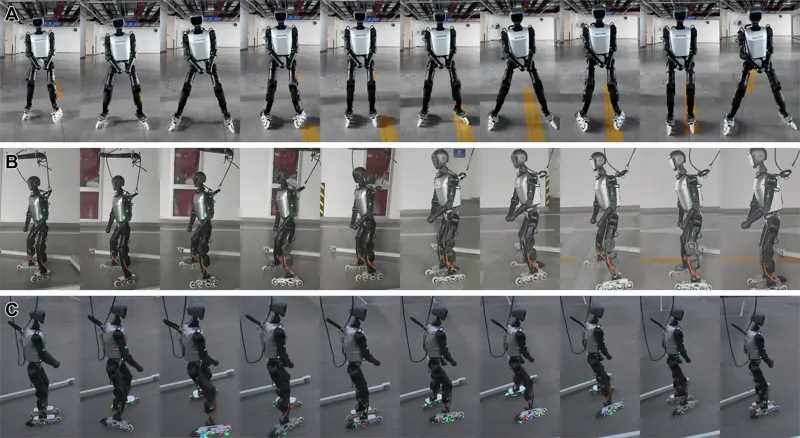
用 AMP-PPO 框架和切片圆柱体轮仿真模型,让人形机器人学会 Pump Glide(足部开合产生动力)和 Push Glide(交替支撑推进)两种被动轮滑步态,在 Booster T1 上实现仿真和真实机器人持续轮滑。
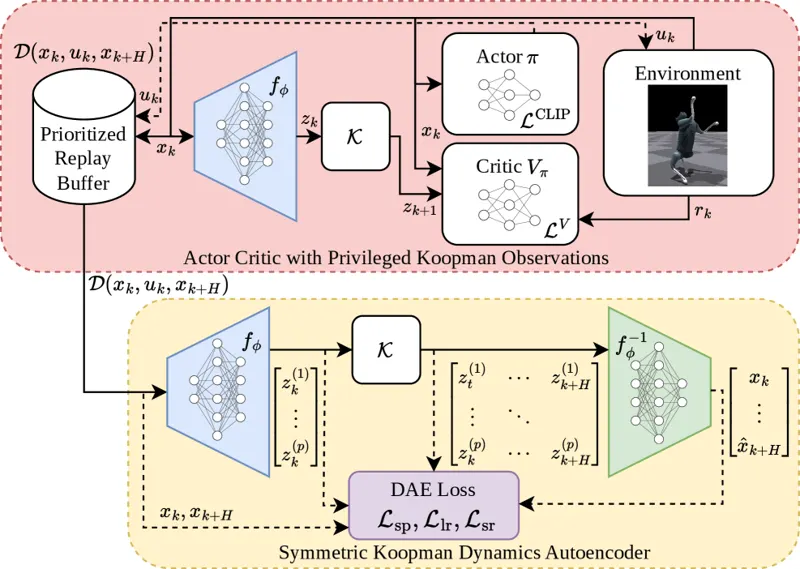
将形态对称性(C2反射)与 Koopman 动力学自编码器结合,在 actor-critic RL 中为 critic 提供线性化动力学预测作为特权观测,显著提升样本效率和跨对称任务泛化能力。在 Cyberdog2 双足任务上验证。
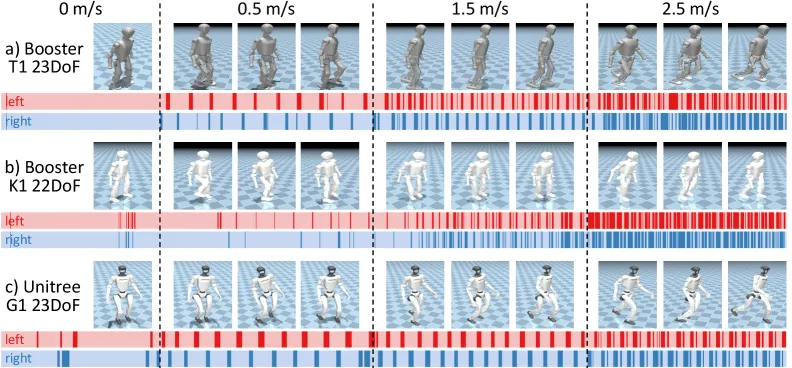
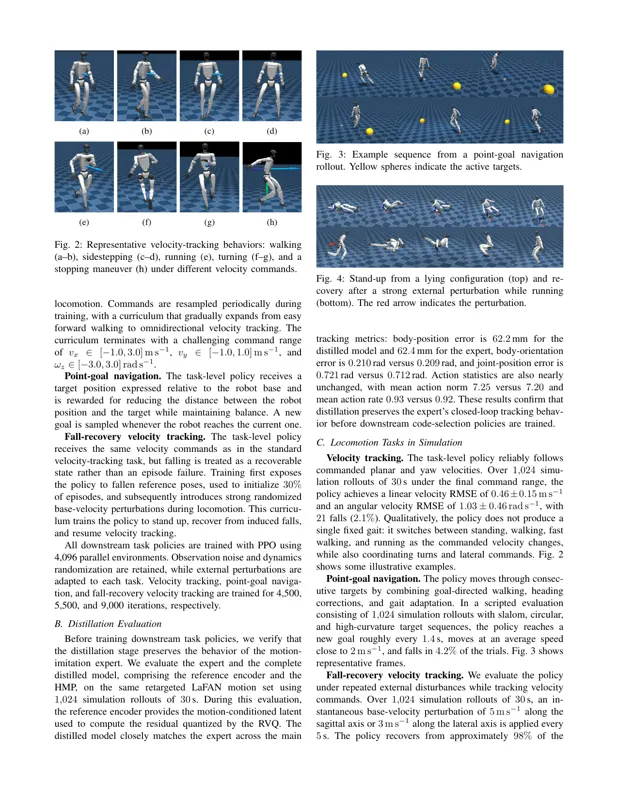
将预训练行走策略当作种子技能,通过 GaitWave 节奏生成、H-SLIP 步态动态塑形和残差适应三个模块,让一个策略连续覆盖行走→慢跑→跑步,在五种人形形态上实现零样本迁移。
提出可行性感知的机器人运动优化方法,在运动规划中显式建模可行性约束,提升机器人运动的鲁棒性与可执行性。
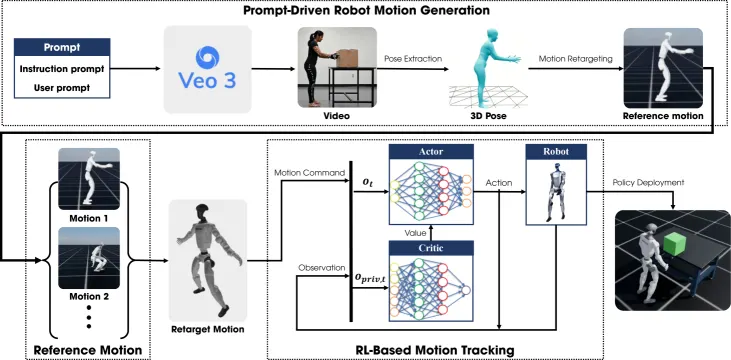
提出通过合成视频场景学习多样化人形机器人任务的方法,无需真实世界数据,降低人形机器人技能学习的数据采集成本。
从运动模仿中学习可复用的混合运动先验,让 RL 策略能跨步态任务迁移而非每次从零训练,提升人形运动控制的样本效率和泛化能力。
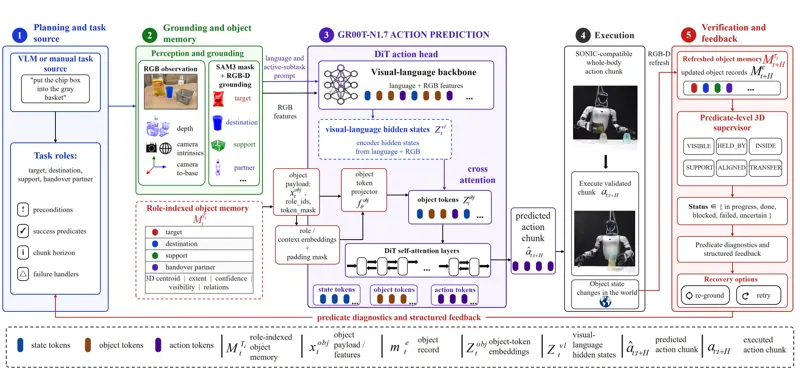
提出持久物体令牌化(POT),从RGB-D观测维护角色索引3D物体记录并转换为动作专家的物体令牌,实现动作生成与几何谓词检验的闭环执行。POT-VLA在Unitree G1上将GR00T-N1.7基线从39/80提升至71/80,在Being-0对齐服务任务上达44/50。
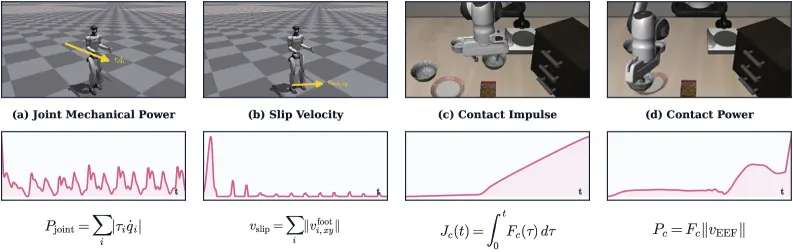
PRISM 提出一种紧凑的策略表示方法,将可观测物理变量间的多项式交互显式化、可学习化。标准 MLP 策略接收一阶变量(位置、速度),但许多动作相关线索来自乘积交互(如关节功率=扭矩×速度)。PRISM 用因子化多项式模块直接暴露这些交互,无需枚举所有单项式,在人形机器人行走和接触丰富操作上显著超越 MLP 基线。
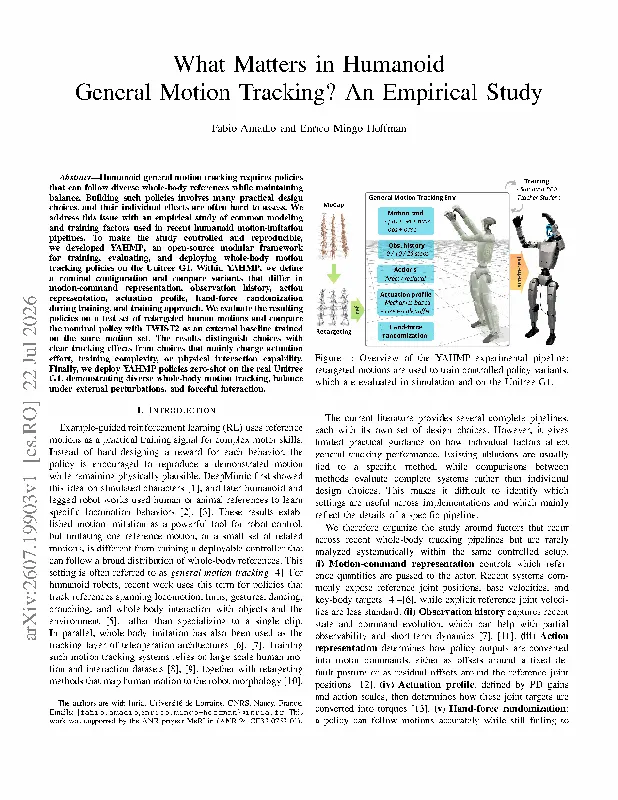
本文通过系统性实证研究揭示人形机器人通用运动跟踪中的关键因素,分析影响全身运动跟踪性能的设计选择。
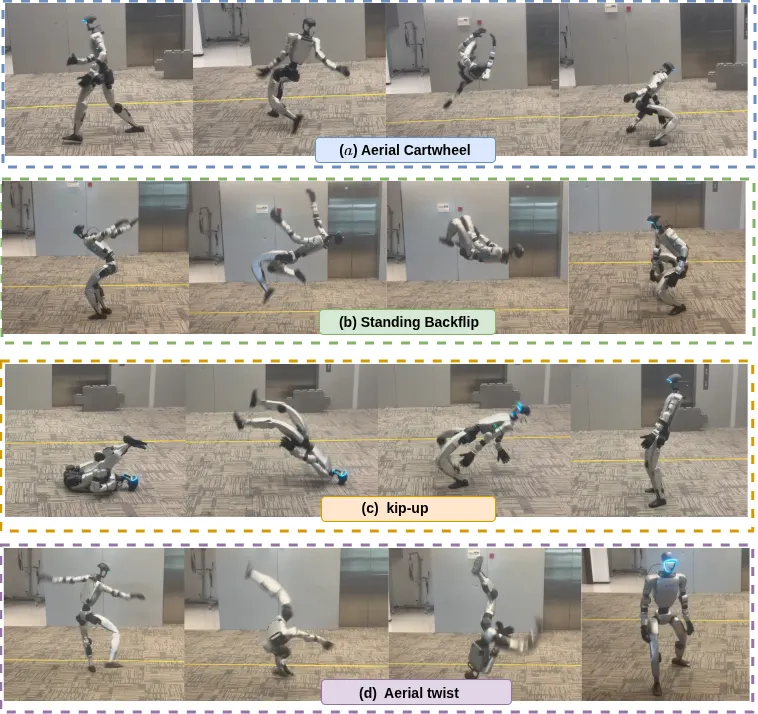
Extreme-RGMT提出持续学习方法用于人形机器人的高动态技能获取,实现对通用机器人控制的鲁棒泛化。
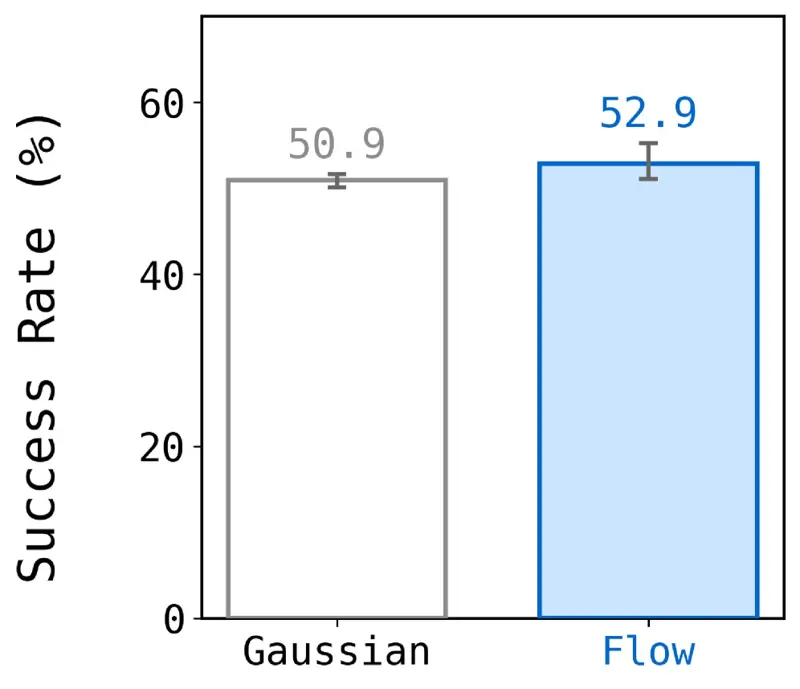
本文研究层次化动作分块在离线强化学习中的应用,通过将动作序列分组为层次化块结构,提升离线RL的效率和稳定性,面向人形机器人控制。