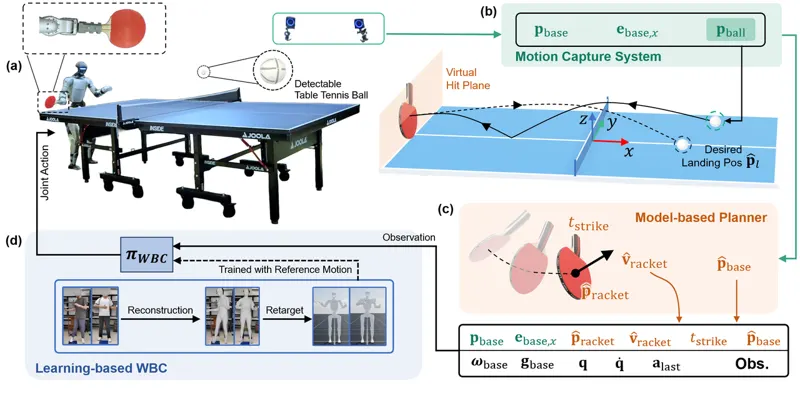
伯克利团队提出 HITTER:基于模型的规划器预测球的落点、击球位置与时刻,强化学习全身控制器用人类挥拍参考动作生成正/反手击球,在 Unitree G1 上实现与人类最多 106 拍连续对拉。
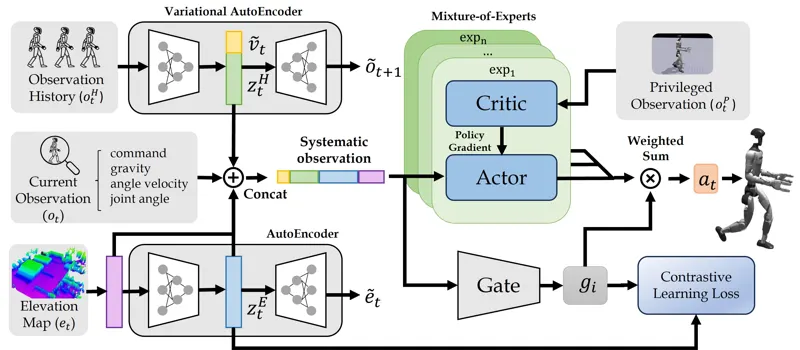
CMoE 利用对比学习优化 MoE 专家激活,提升人形机器人地形导航能力。在 Unitree G1 上验证,可跨越 20cm 台阶和 80cm 间隙。
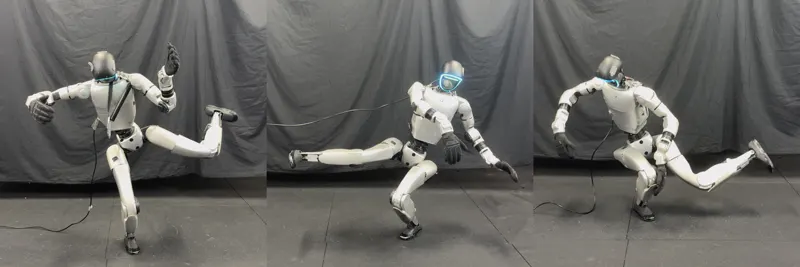
首个可部署动态质心(xCoM)观测直接驱动硬件策略,配合人体姿势控制奖励库与非对称FastSAC训练,FDDC在90个单腿平衡动作中86个保持干净站姿,并迁移至真实Unitree G1。
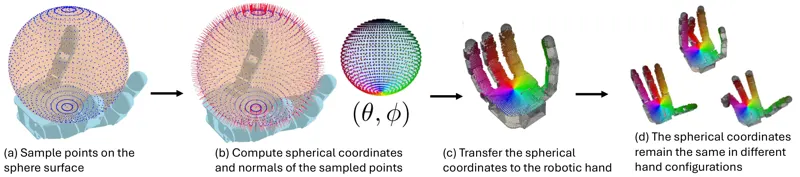
提出规范球面形变的统一手部动作空间,用级联逆运动学把同一策略映射到多款灵巧手,并在仿真与真实手完成手内立方体转位。
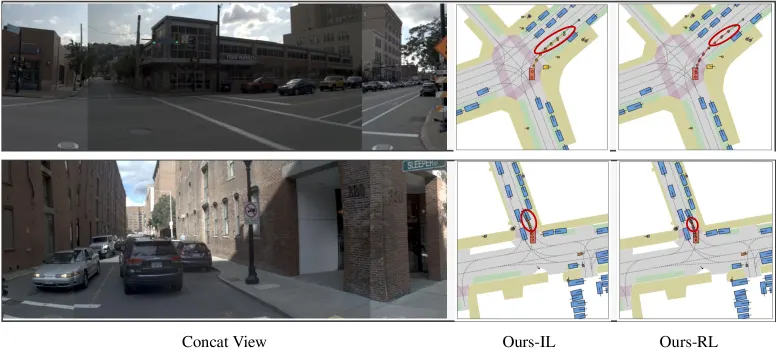
提出将视频生成仅作为训练信号的简洁世界-动作模型,联合训练视频专家和轻量动作专家,用隔离注意力掩码使动作预测独立于未来帧,训练后丢弃视频分支保留自包含规划器直接预测轨迹,并用强化学习优化组合驾驶奖励,在 NAVSIM 上达 91.5 PDMS。
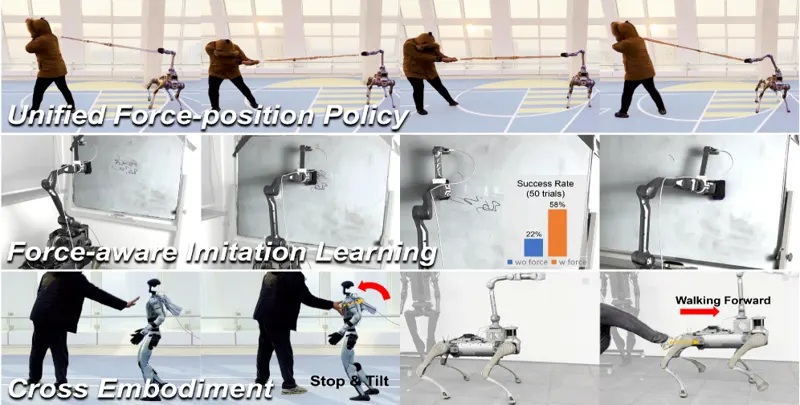
本文提出首个足式机器人力位统一控制策略,无需力传感器,通过RL从历史状态估计外力并补偿位置速度,支持位置/力跟踪与柔顺交互,并在四足与双足机器人上验证。
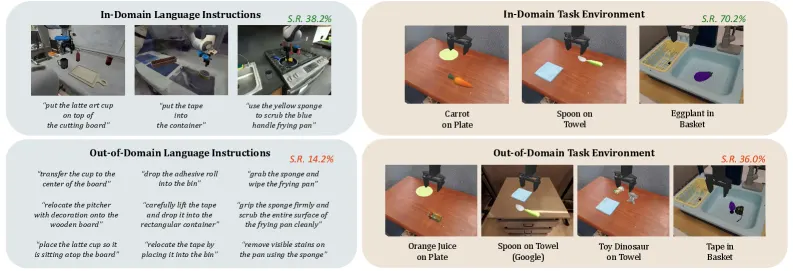
提出 RL2 自适应推理时引导框架,在 VLA 动作专家潜空间上训练轻量离线 RL 策略,推理时将其流速度与冻结 VLA 组合,仅在预测失败时激活引导,在 SIMPLER 和 PolaRiS 基准上 OOD 场景成功率提升达 17.3%,真机实验验证迁移有效。
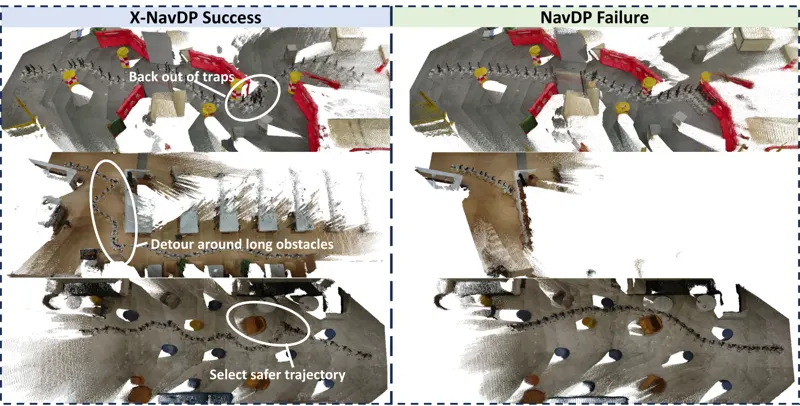
提出GQRM强化学习后训练框架,通过自举探索与群组Q值归一化机制对导航扩散策略进行跨本体微调,仿真成功率从61%提升至84%,真实世界从10%提升至65%。
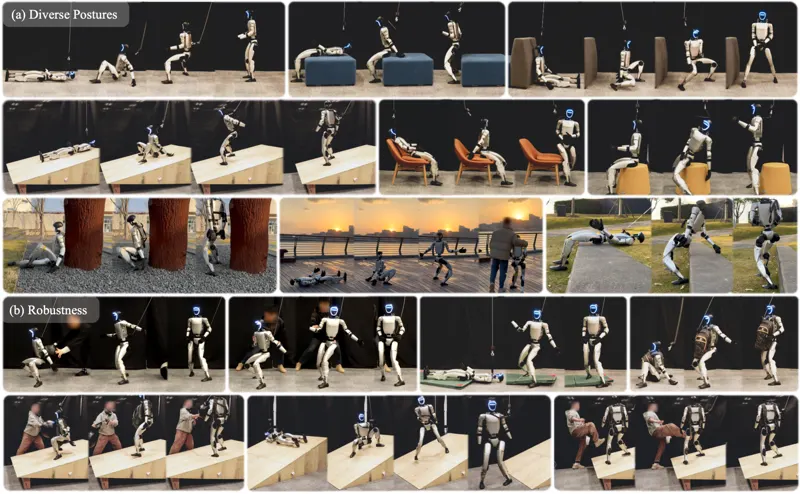
HoST是一种强化学习框架,从零学习人形机器人起立控制,通过多评价者架构和多样化地形课程训练实现姿态自适应运动。采用平滑正则化和隐式运动速度约束确保sim-to-real迁移成功,直接部署于Unitree G1人形机器人,在实验室和户外多种环境中实现平滑稳定的起立动作。
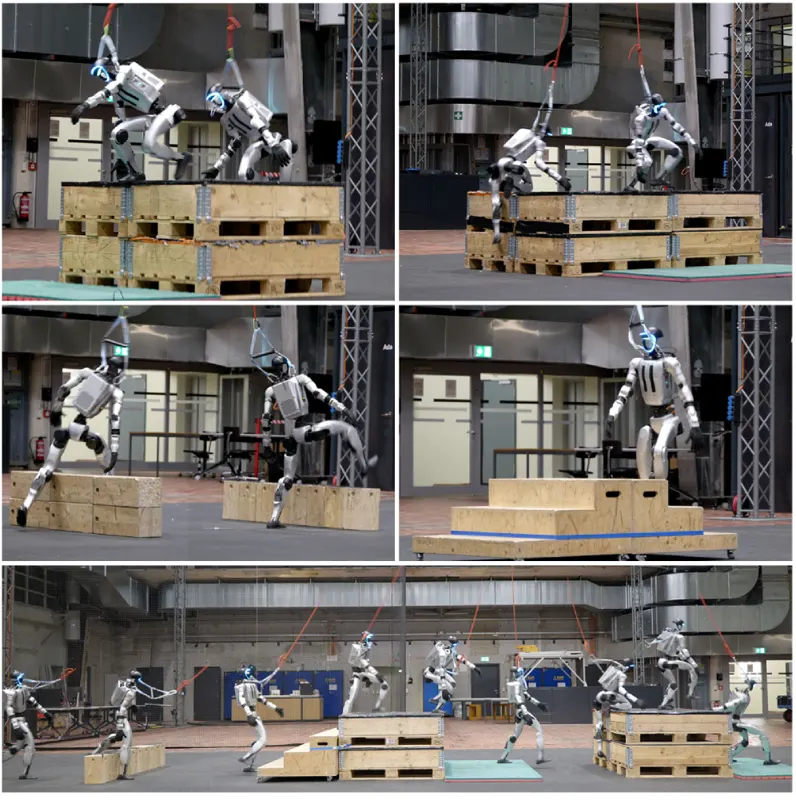
全身人形运动具有挑战性,因为高维控制、形态不稳定性以及需要使用机载感知对各种地形实时适应。直接将强化学习与奖励塑造应用于人形运动通常导致下半身主导行为,而基于模仿的方法在适应未见地形方面存在困难。本文提出通过运动生成和运动跟踪学习全身运动。
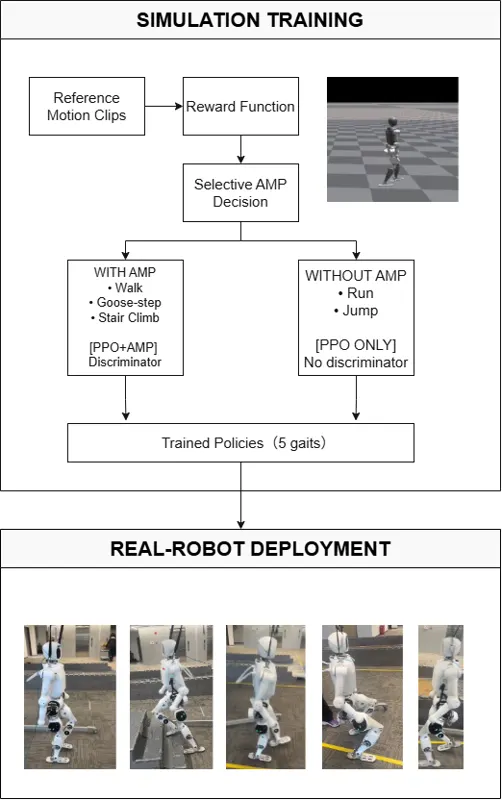
在统一强化学习框架中为人形机器人学习多样化运动技能仍具挑战性,因为不同步态间稳定性和动态表达性的冲突需求。本文提出多步态学习方法,使人形机器人掌握五种不同步态——行走、正步、跑步、爬楼梯和跳跃——使用选择性对抗运动先验。
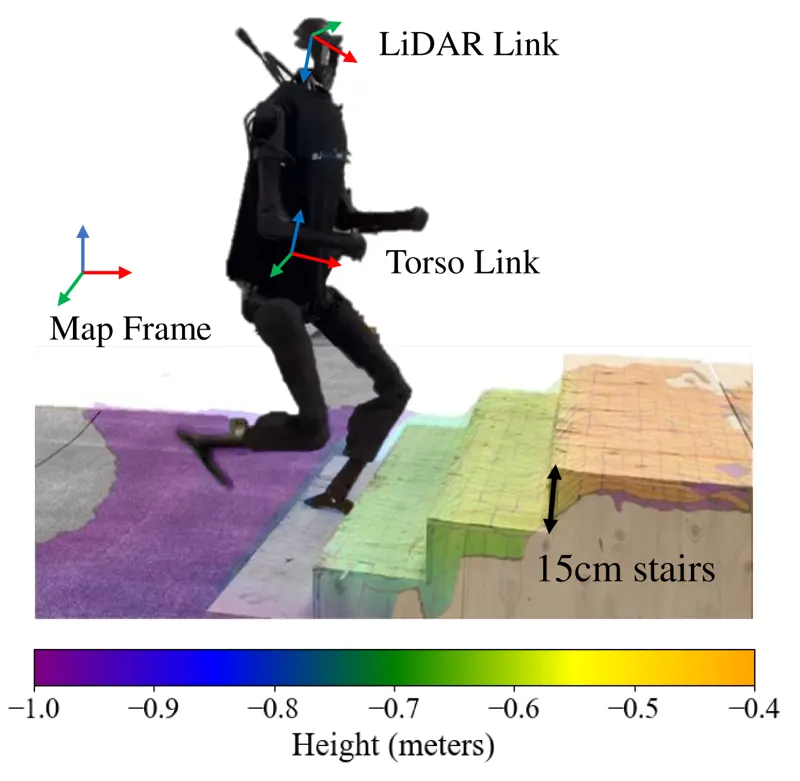
与四足机器人可以使用盲策略导航多种地形不同,人形机器人由于高自由度和本质上不稳定的形态,需要精确感知才能稳定运动。然而引入感知信号往往会给系统引入额外干扰,降低鲁棒性、泛化性和效率。本文提出感知内部模型解决这些问题。