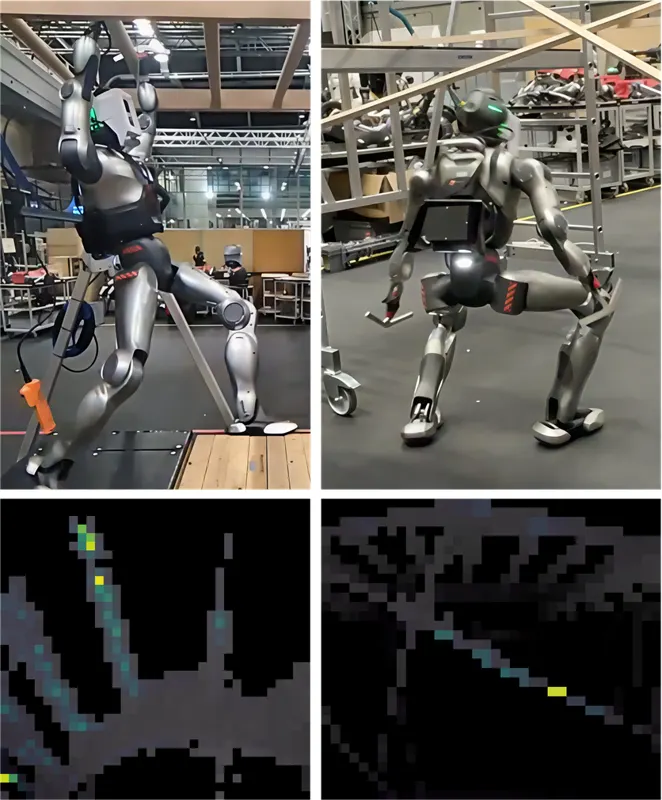
ETH RSL 让人形机器人只靠头部固态激光雷达原始回波完成跳上云梯、臂行横越、跳下落地的完整序列:三个特权教师经相位调度蒸馏为一个注意力感知学生,配合电池压降、电机热极限与雷达噪声建模,硬件 15 次成功 14 次,臂行速度 0.5 m/s。
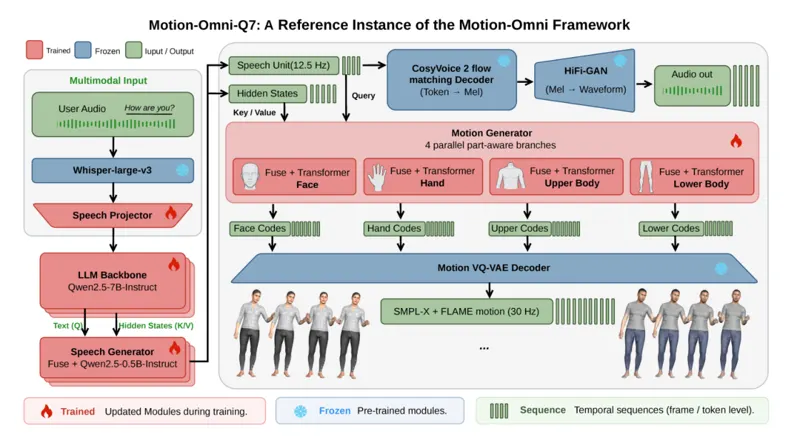
把动作输出从级联改成原生:一个 7B 主干在说话的同时生成面部、手、上肢、下肢动作,响应比教师级联快 5.4 倍,无参考动作指标差距在 2% 以内。
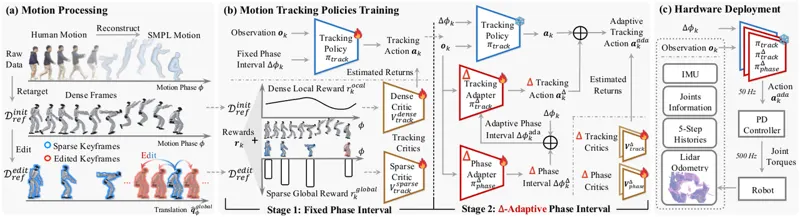
AdaMimic 把单条参考动作稀疏成关键帧并轻量编辑,先训跟踪策略,再冻结策略学相位与跟踪适配器,实现时间扭曲式可适配人形控制,已部署 Unitree G1。
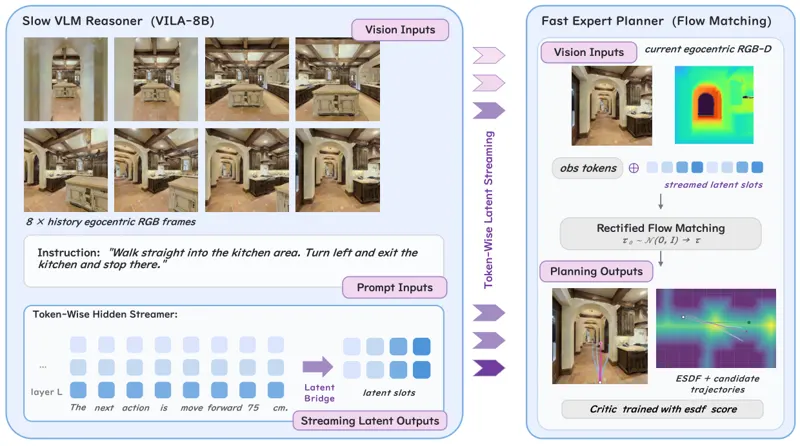
冻结的 VILA-8B 慢推理器把逐 token 多层隐状态流式汇成 8 个潜槽,实时条件化流匹配快规划器;动态行人导航基准上理想/真实两阶段成功率 41.6%/34.8%,碰撞率最低。
PrimeBot等发布1500小时双臂家庭操作数据,训练5B VLA模型XR-2;叠衣任务上专家数据把成功率从34%推到84%后饱和,三轮DAgger在策略纠正再从58%提至93%。
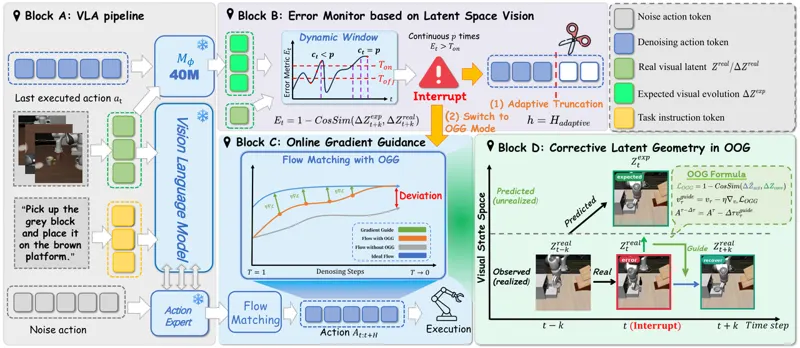
视觉-语言-动作(VLA)基础模型在具身智能上进展显著。为降低策略调用频率并保持时间连贯性,多数生成式策略采用动作块机制,在固定动作视界下以开环方式执行多步未来动作。然而这种先预测后盲目执行的范式牺牲了闭环反应性:在接触丰富的物理交互中,即使微小的局部扰动也会在开环盲区内迅速放大,导致误差复合并最终任务失败。为此本文提出 VLA-Corrector,一个面向动作块 VLA 策略的轻量纠正推理框架。在不修改主干策略权重的前提下,VLA-Corrector 引入轻量潜空间视觉监控器(LVM),持续比较预测与实际的视觉特征演化,实现在线检测视觉动力学偏差;一旦检测到持续偏差,系统触发截断事件、丢弃剩余陈旧动作,并通过在线梯度引导(OGG)发起纠正重规划。该检测-纠正机制自然诱导出事件触发的自适应动作视界:当前动作块可靠时保留长视界执行,执行开始漂移时调用短视界纠正重规划,从而缓解静态视界在执行鲁棒性与策略调用频率之间的权衡。VLA-Corrector 可在不重训 VLA 主干的情况下集成到不同 VLA 模型中,在保留动作块效率收益的同时中断复合误差,显著提升长视界、接触丰富机器人操作任务的鲁棒性。
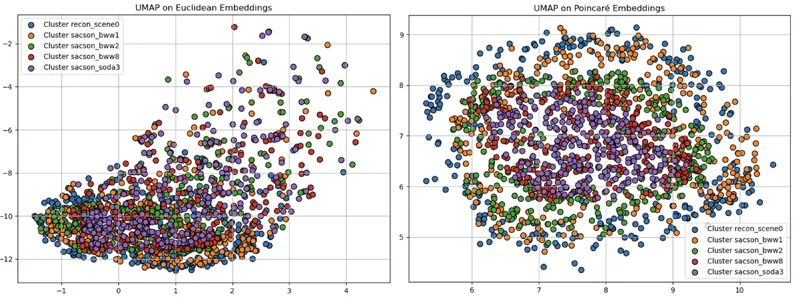
论文提出HyperDCM,把RGB观测转为场景图并映射到Poincaré双曲空间,再用结构敏感动态聚类维护回放样本,缓解扩散导航策略跨场景训练的灾难性遗忘。
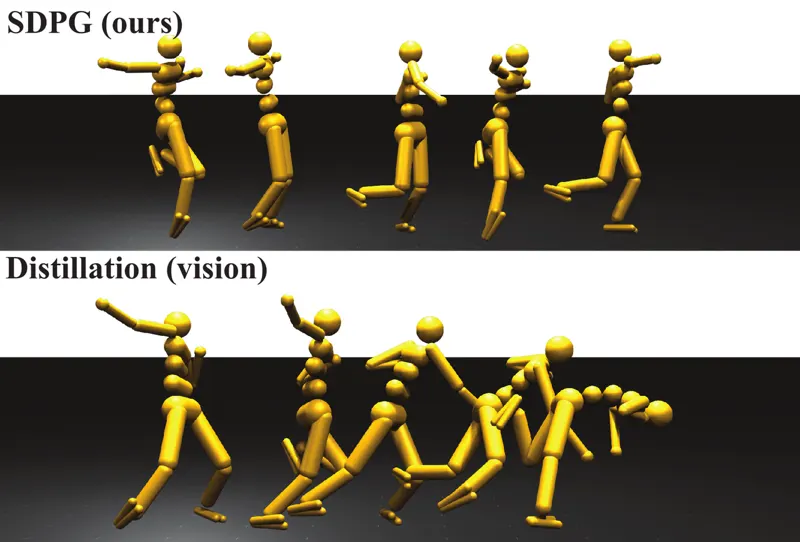
SDPG 用同一名义轨迹周围的随机动作扰动估计平滑策略梯度,只批量渲染少量名义环境,并用大量无渲染物理环境计算回报差。论文在视觉 MuJoCo 与多类机器人任务上实现单张 RTX 4080 的端到端训练,并在 Unitree Go2 上验证零样本 sim-to-real 迁移。
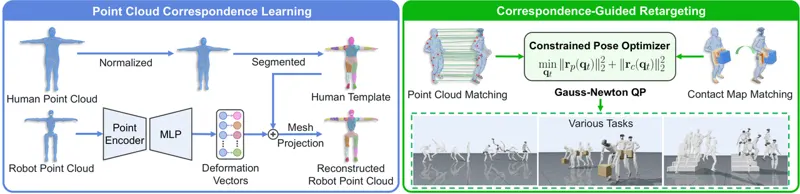
UMR 框架通过学习稠密点云对应关系实现人形运动重定向,无需手动映射,提升可扩展性与细节还原能力。
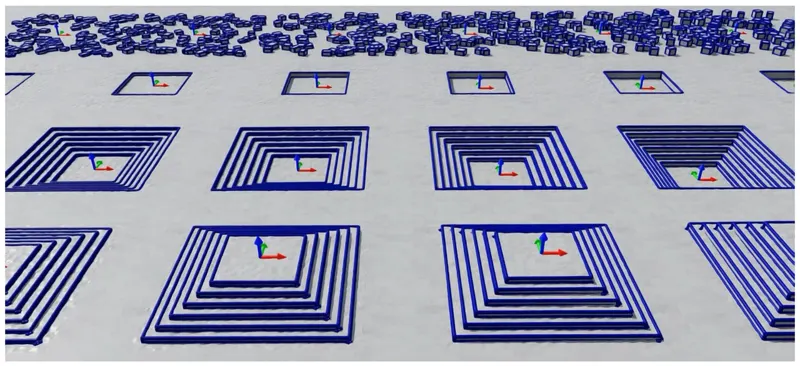
提出端到端感知跑酷框架,将原始深度图与本体感受直接映射为关节动作,结合地形边缘检测、足部体积点防边缘滑落机制与平坦区域采样抑制奖励作弊,全尺寸人形机器人实测最高 2.5 m/s 穿越复杂非结构化地形。
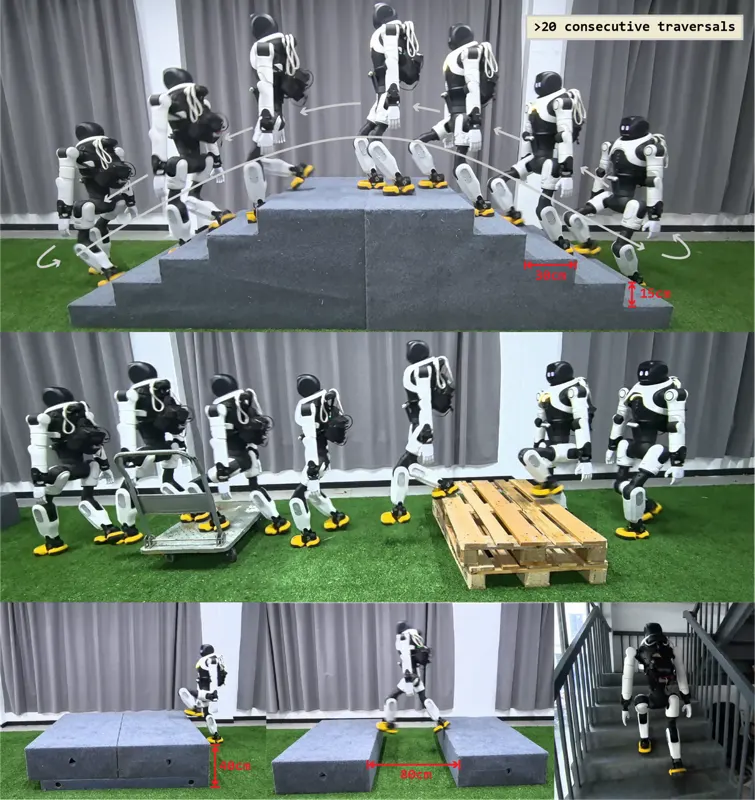
CReF 提出单阶段、直接以深度图+本体感知映射到关节目标的视觉人形运动框架:本体感知查询的跨模态注意力、门控残差融合与 GRU 高速公路门控循环融合从原始前向深度提取运动相关特征,并引入基于足端点云可支撑候选的地形感知落脚奖励。仿真中在楼梯/间隙/平台三类地形全部难度档取得领先,零样本部署到 AGIBOT X2 Ultra,在带扶手楼梯、镂空托盘、强反光与杂乱户外场景中稳定行走。
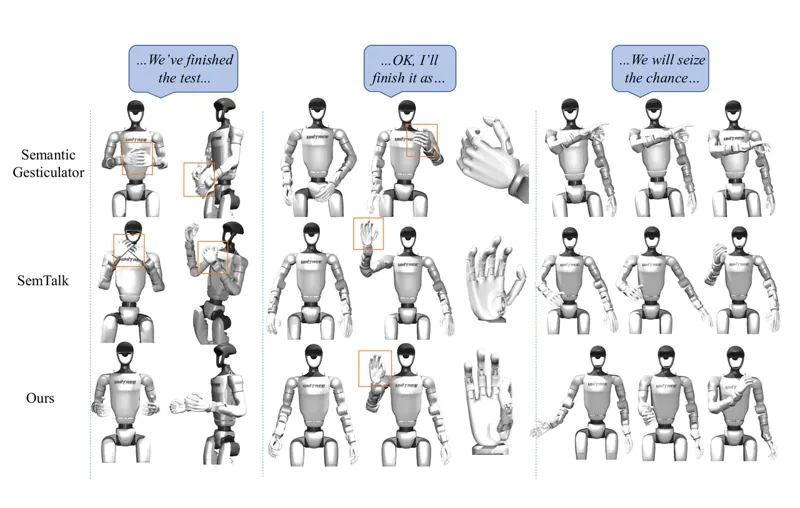
RoboGesture 让人形机器人听懂语音并实时做手势:300 余类手势数据集,分层语义-声学对齐提取韵律与语义线索,流式扩散生成器驱动 Unitree G1,MPC 安全滤波保真机无碰撞执行。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。